Meta发Muse Wonder,官方说在多项测试中达到了前沿水平,部分指标甚至超过了GPT-6和Claude。在独立评测机构的综合智能指数里,更强的Full版本拿了56分,超过了GPT-6 Astra的53分。
但有意思的是,新模型发布之后,开发者的反馈并不是一片叫好。
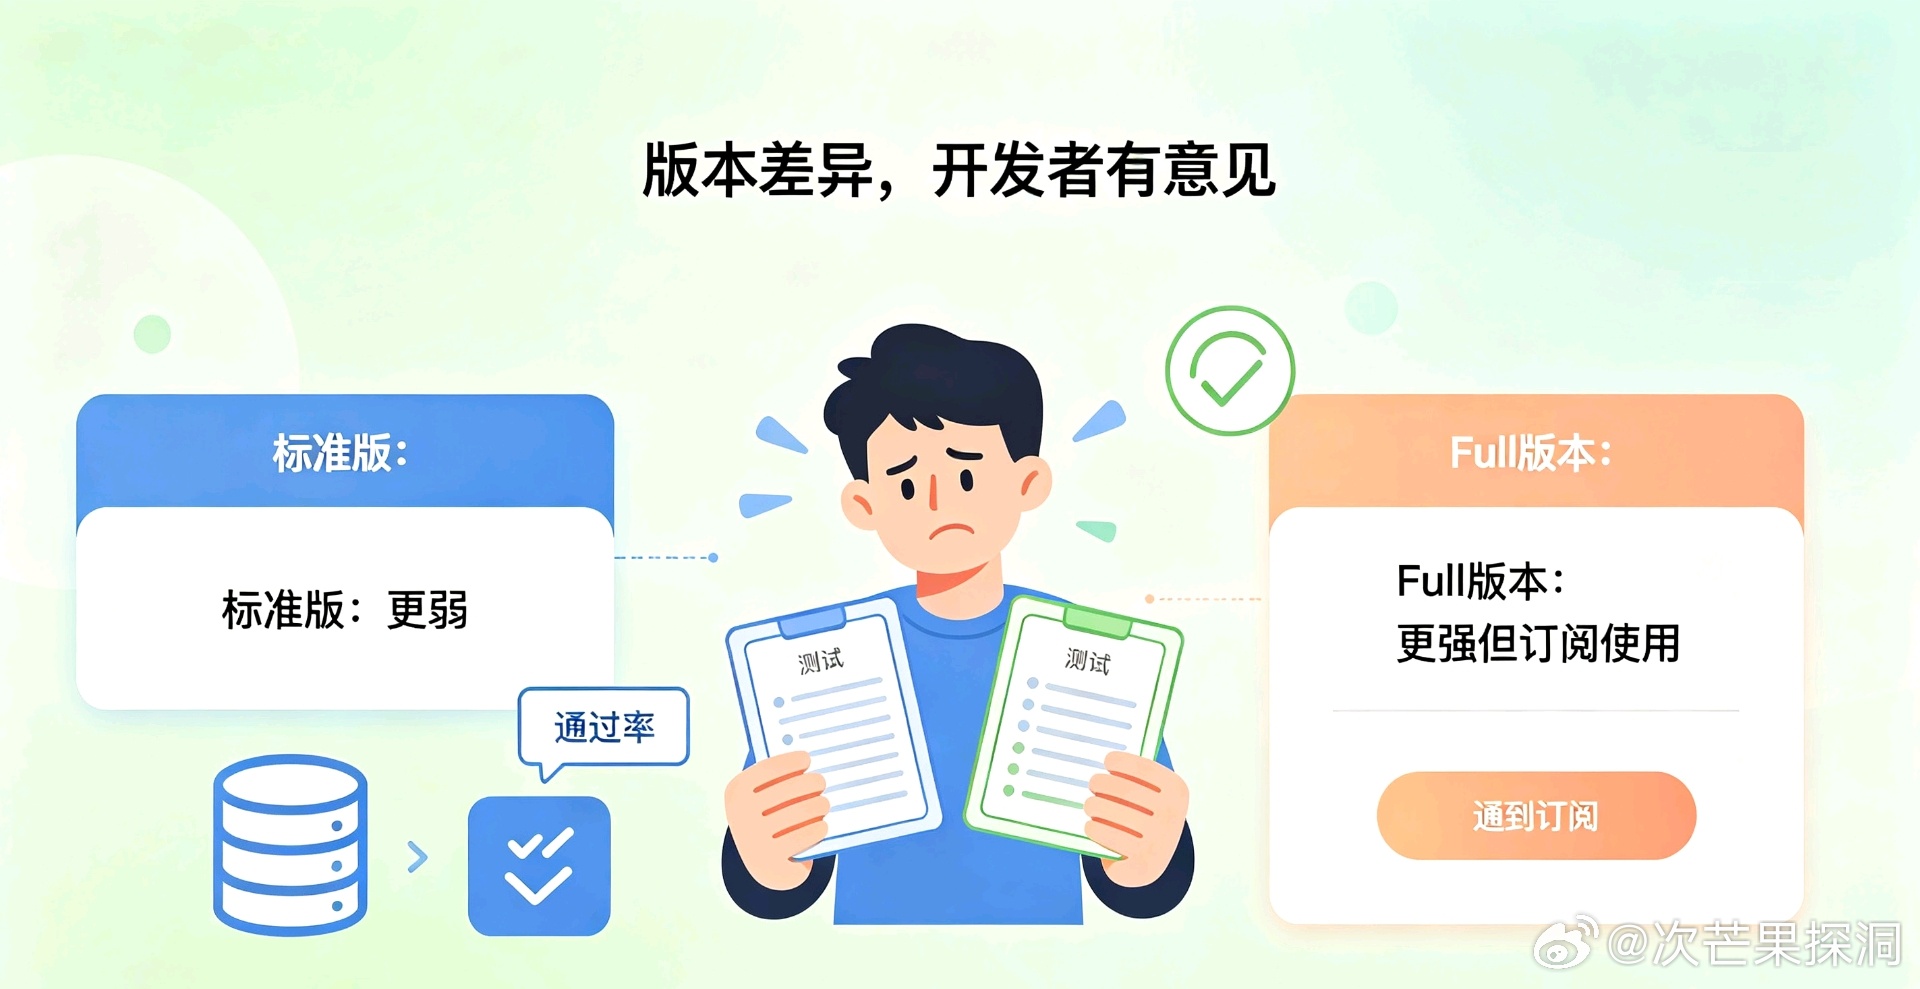
有开发者把Full排在跟Claude Opus 5.5同一档,但同时提醒说,通过API提供的标准版Wonder明显更弱。他连同两个版本的命名方式、Full只能订阅使用的安排,一起吐槽了一遍。
还有开发者测了代码库重写任务,标准版Wonder的通过率是48%,而GPT-6.1 Sol是71%,差距不小。另一位用户直接说实际表现配不上榜单成绩。
Meta的首席AI官回应说,团队没有专门针对某些演示场景做训练,希望大家把模型用到实际编程工作中去。
我觉得这件事挺正常的。榜单是实验室里的成绩,开发者的体验是真实工作里的感受。两者之间有落差,不一定是谁在说谎,只是评测的场景和实际使用的场景,本来就不完全一样。
新产品好不好,榜单只是一个参考。真正的答案,得等更多人用起来才知道。