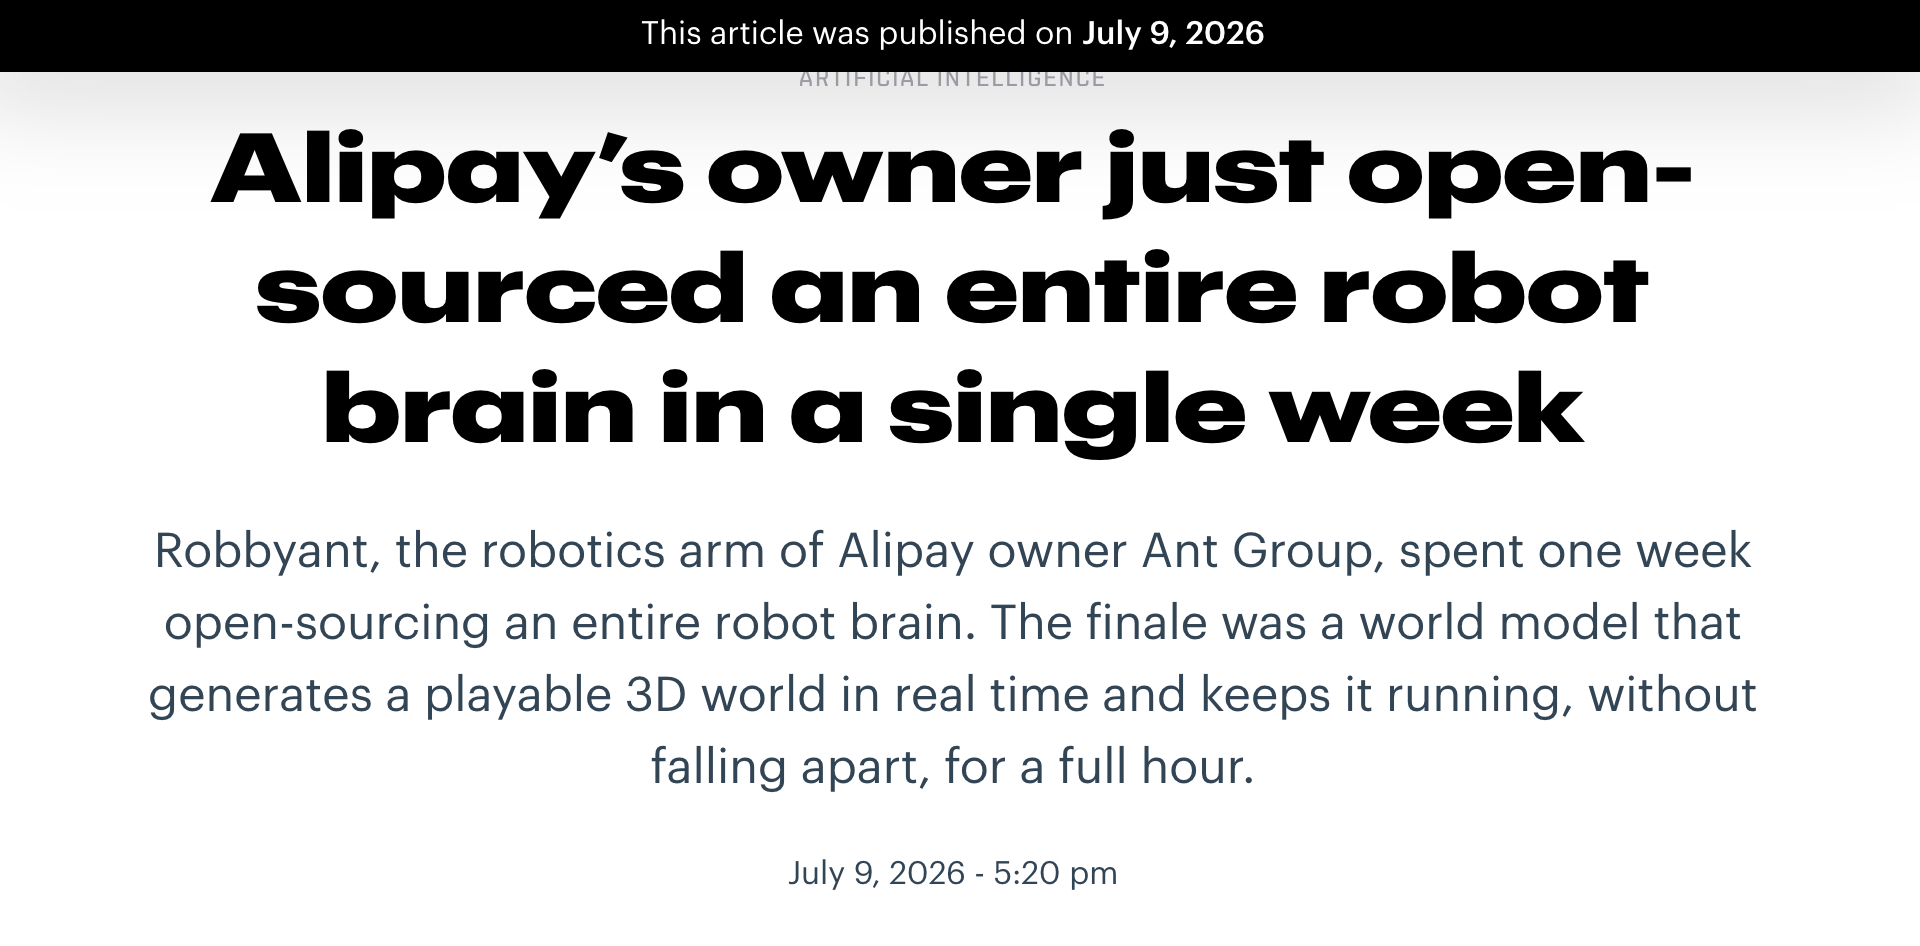
很推荐大家读一篇文章,是 The Next Web 前段时间写的一篇LingBot系列的深度分析。
文章里有个很大胆的判断:谁能提供机器人的大脑,谁就可能成为其他团队继续构建的那一层。
这句话的分量很重。因为在具身智能领域,灵波面对的不只是几家模型公司,还有英伟达、Physical Intelligence 等已经投入大量资源的团队。
想成为其他团队依赖的基础能力,模型自身的性能只是其中一部分。外部研究者是否愿意复用它,开发者能否把它接进真实项目,主流工具又是否愿意为它提供标准接口,同样决定了它能走多远。
最近发生在 LingBot系列身上的几件事,刚好提供了观察这些问题的线索。当一个模型从被讨论、被比较,逐渐走进其他团队的研发流程,它在行业里的位置也会发生变化。
所以,一套开源模型,凭什么有机会成为行业底座?
首先,是成为其他研究可以复用的起点。
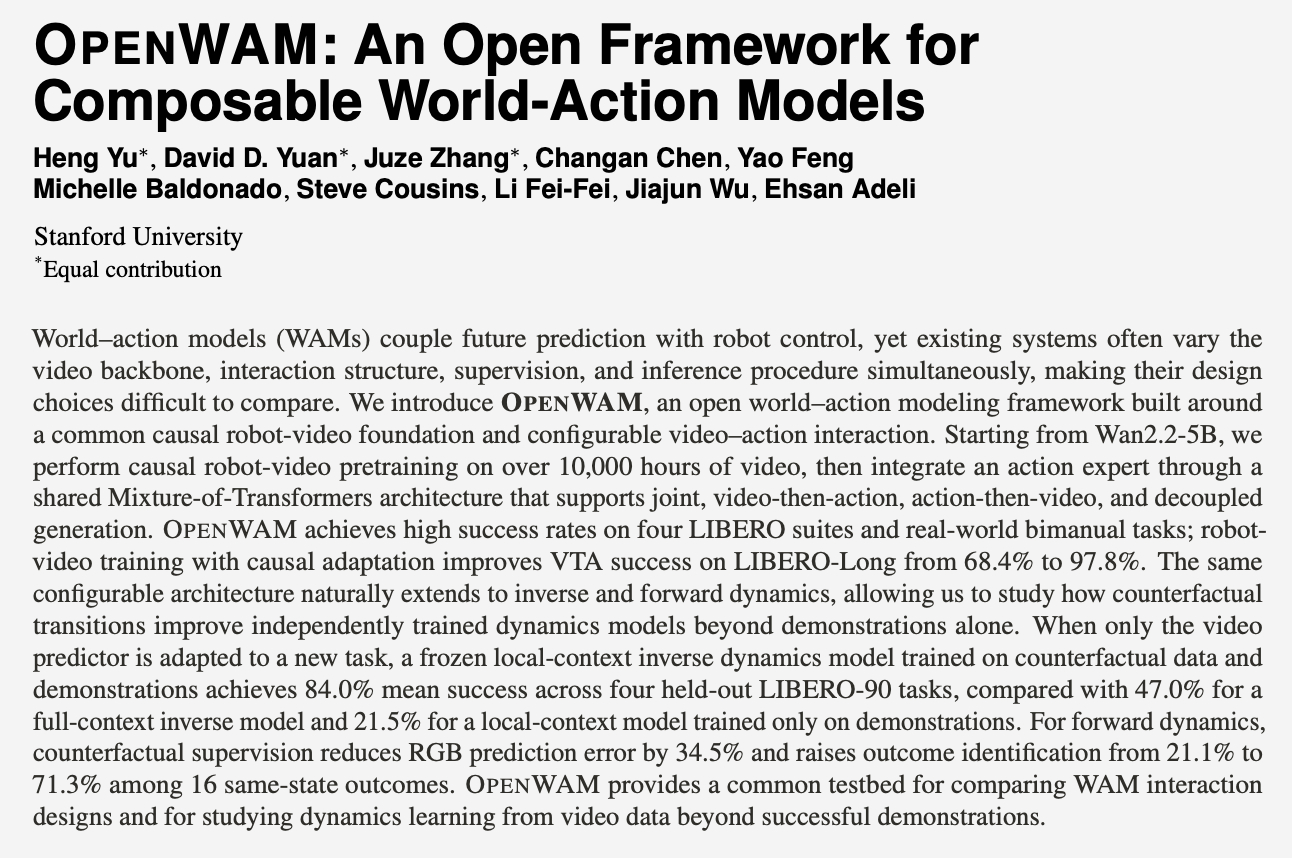
最近,斯坦福团队发布了《OpenWAM: An Open Framework for Composable World-Action Models》,一套研究世界动作模型的开放框架。
简单来说,它试图把未来画面预测和机器人控制放进一个可组合的框架中,让研究者在相对统一的基础上比较不同的视频与动作生成方式。
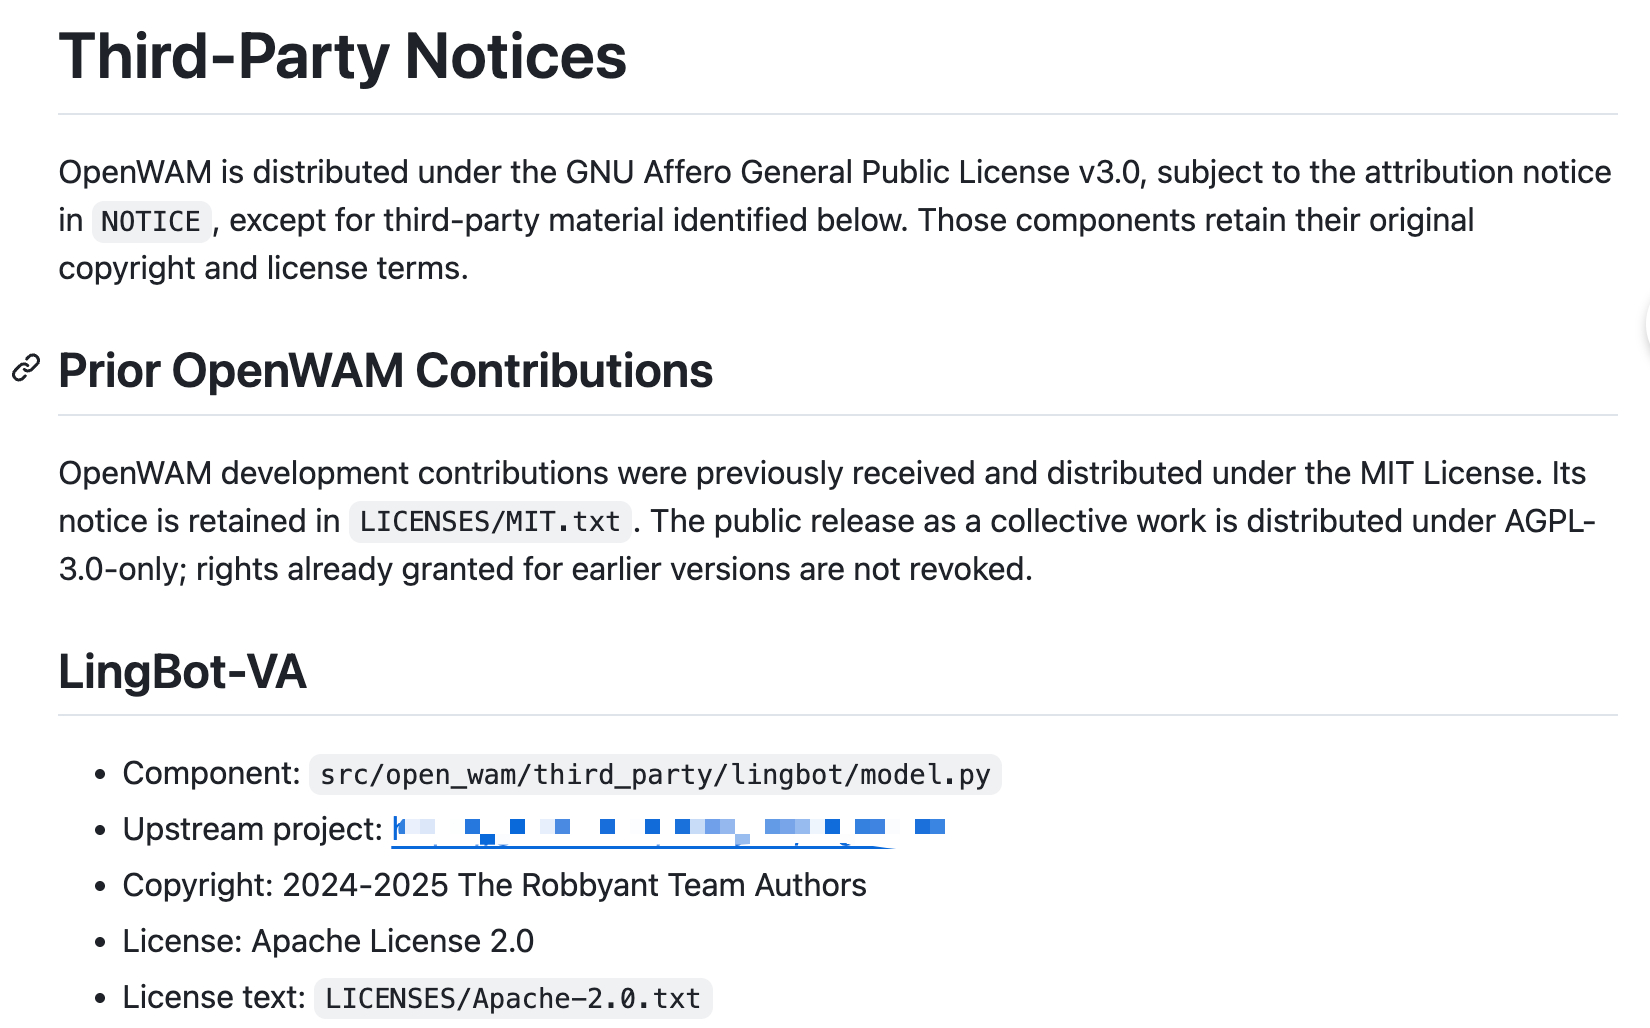
值得注意的是它对 LingBot-VA 的使用方式。官方训练文档明确提到,LingBot-VA 为项目提供了参考 Transformer 格式和文本组件,相关模型资产也进入了训练流程。
普通的论文引用,代表一项工作进入了研究视野;而代码、格式和组件被直接纳入另一个项目,则代表更深一层的复用关系。
所谓底座属性,往往就出现在这样的细节里:来者不必从头造轮子,而是站在它提供的结构上往前走。
其次,是进入真实的专业工作流。
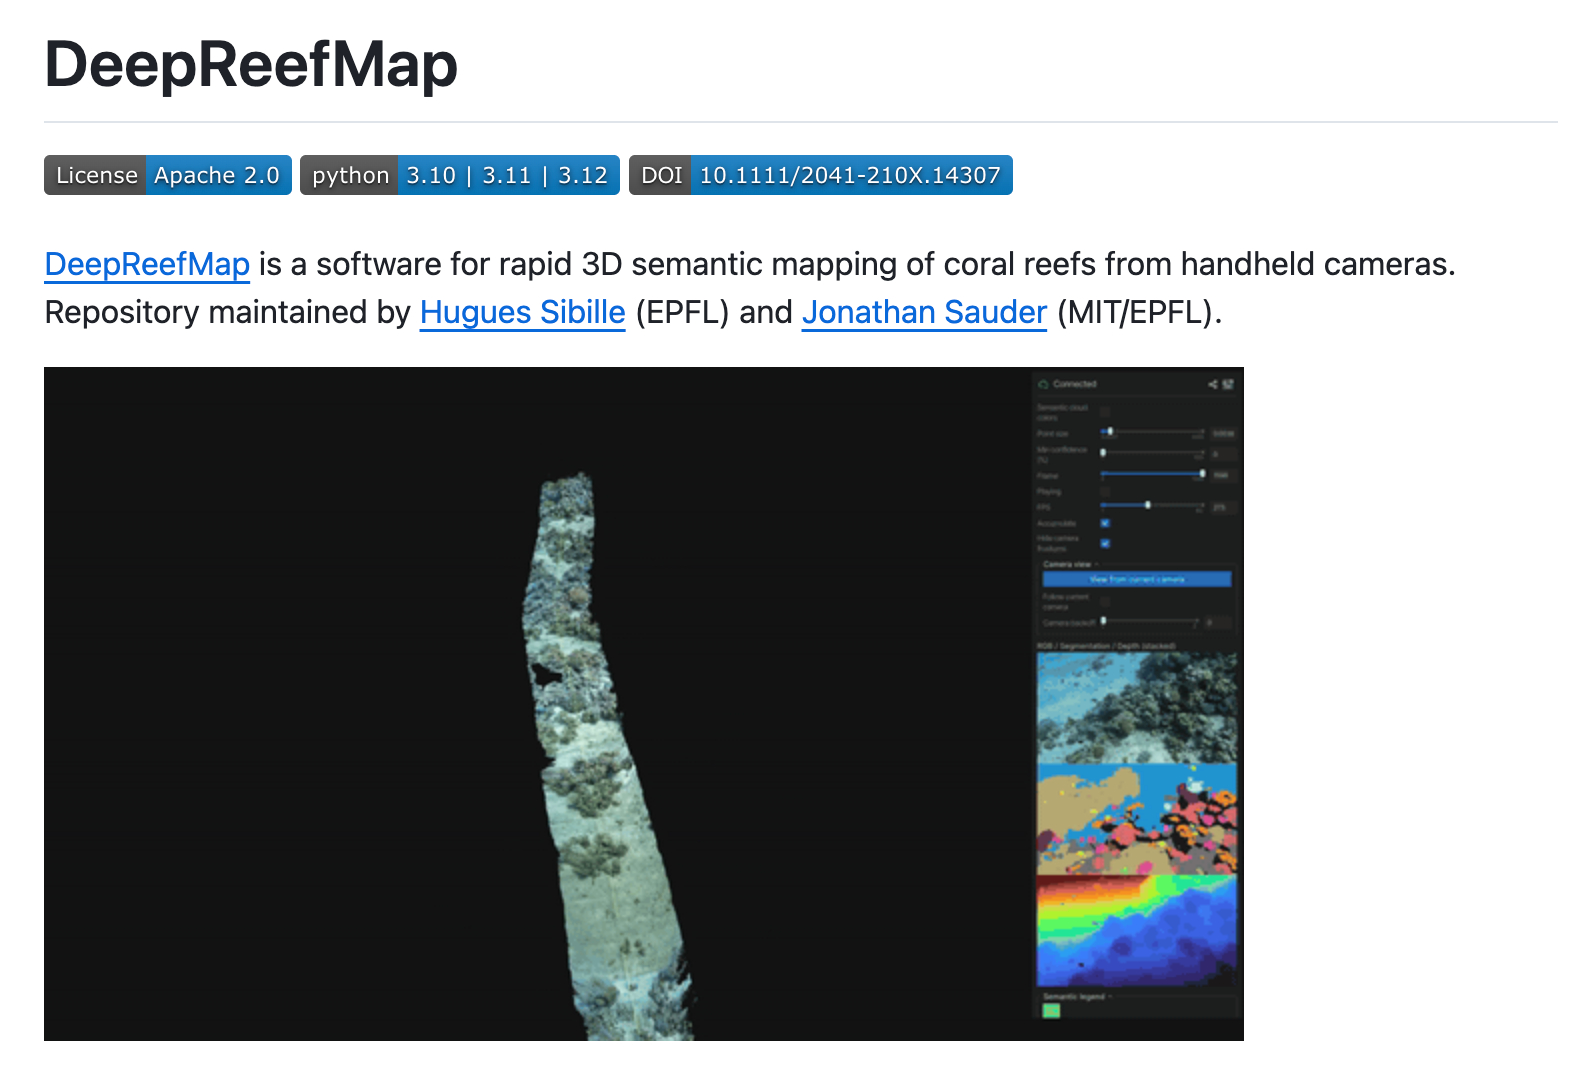
由 EPFL 等研究者维护的 DeepReefMap,做了一件很有意思的事。他们把潜水员拍摄的海底视频,转化成可以分析的珊瑚礁三维地图。
如今,LingBot-Map 已经被接进这套重建流程。项目选择它的原因很实际。水下视频通常很长,如果模型一次处理整段素材,显存占用很容易不断增加。
LingBot-Map 可以流式读取视频,素材变长时,显存占用仍能大致保持稳定。因此,项目文档认为它更适合处理长视频,或者显存有限的设备。
从通用的视频空间重建,到珊瑚礁研究,LingBot-Map 的能力已经被外部团队重新组合,进入了一个不同于原始演示的专业场景。
接着,是进入行业常用的工具链。
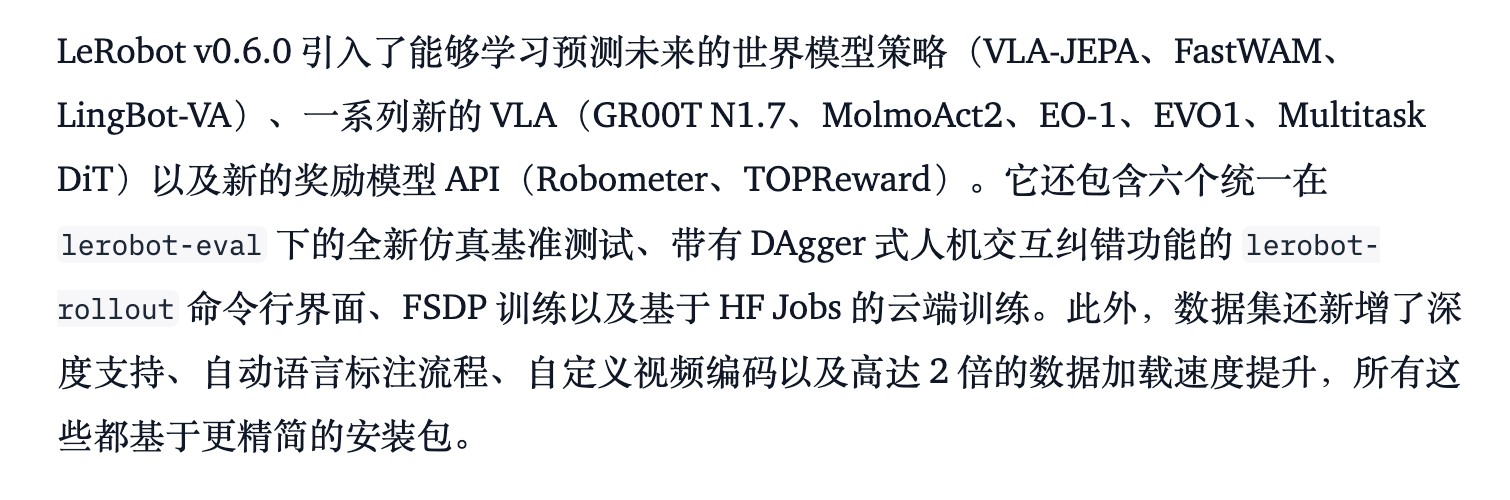
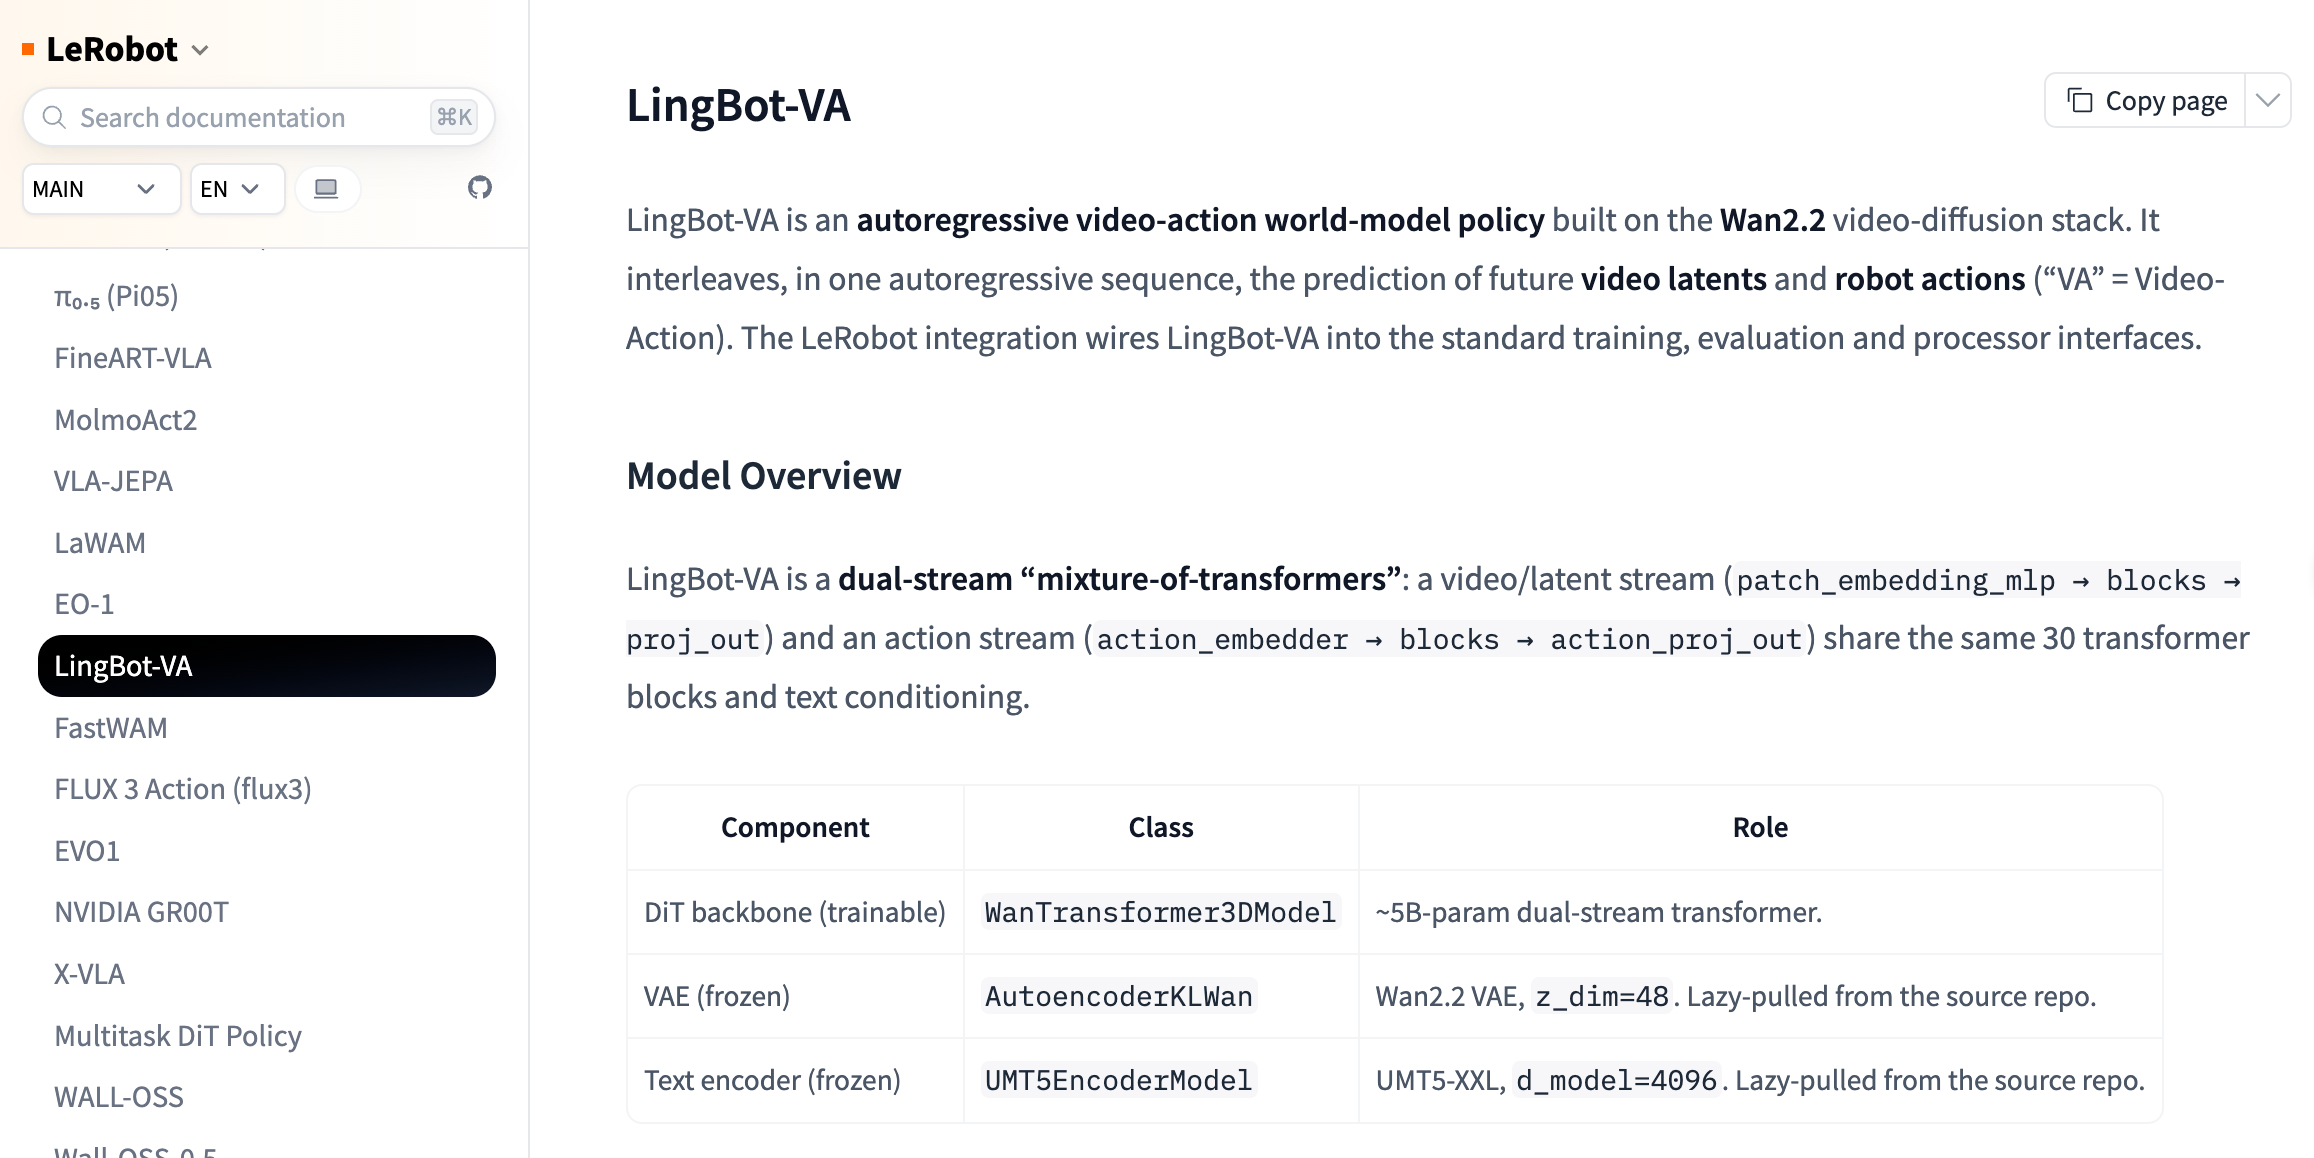
今年7月,Hugging Face 发布 LeRobot 0.6.0 时,正式把 LingBot-VA 纳入了统一的机器人开发体系。
开发者可以沿用 LeRobot 原有的数据、训练和评测流程使用它,还能保存模型预测的未来画面,再和机器人真实执行的结果进行比较。
很多人可能会低估工具适配的意义。
模型开放权重以后,开发者仍要处理环境安装、数据格式、训练配置、推理和评测等一系列工程问题。如果每一步都需要重新适配,再强的模型也很难快速进入实际研发。
接入 LeRobot 之后,开发者尝试、比较和改造 LingBot 都会方便很多。模型获得了标准化入口,也更容易进入已有的机器人开发流程。
到这里,一条从研究复用、应用落地到工具链集成的路径已经清晰。独立研究团队复用了 LingBot-VA 的代码与组件;应用项目把 LingBot-Map 作为实际重建后端;开源机器人平台又把 LingBot-VA 接进标准训练和评测接口。
当然,距离真正的行业底座,它还需要更广泛的采用、更长期的维护,以及生产环境和不同平台的持续验证。但这些案例已经释放出一个明确信号,LingBot 系列正逐步进入更多团队的研究与开发流程,成为可以直接调用、组合和继续改造的技术资源。
而这,正是一套开源模型具备底座潜力的开始。