AI 做视频,居然不用视频生成模型?
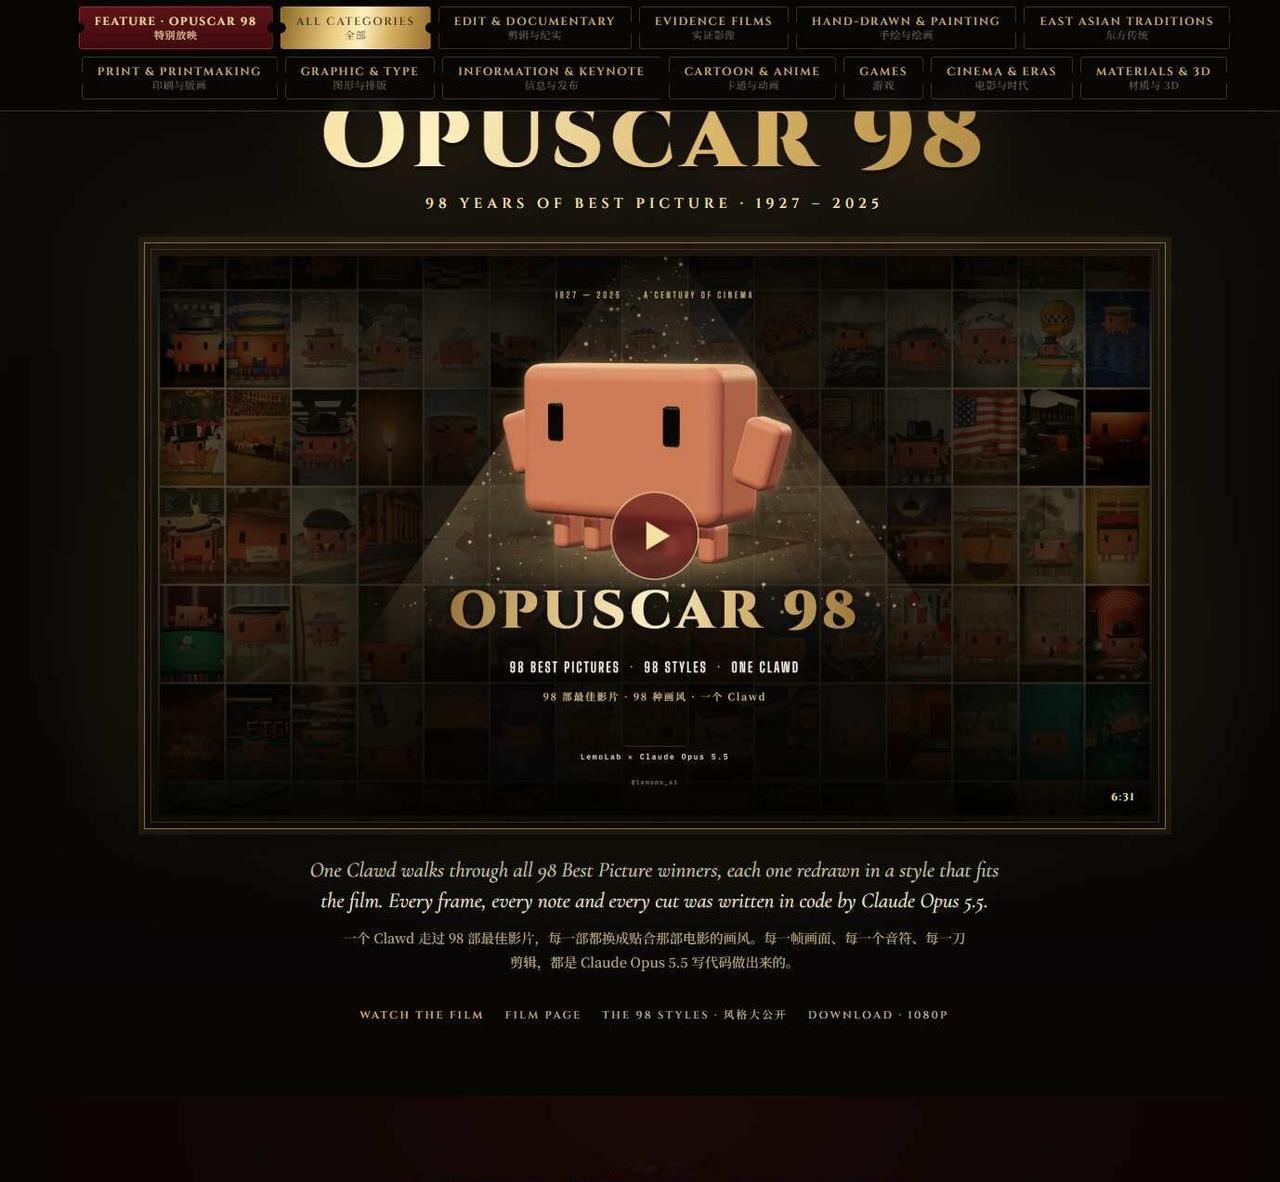
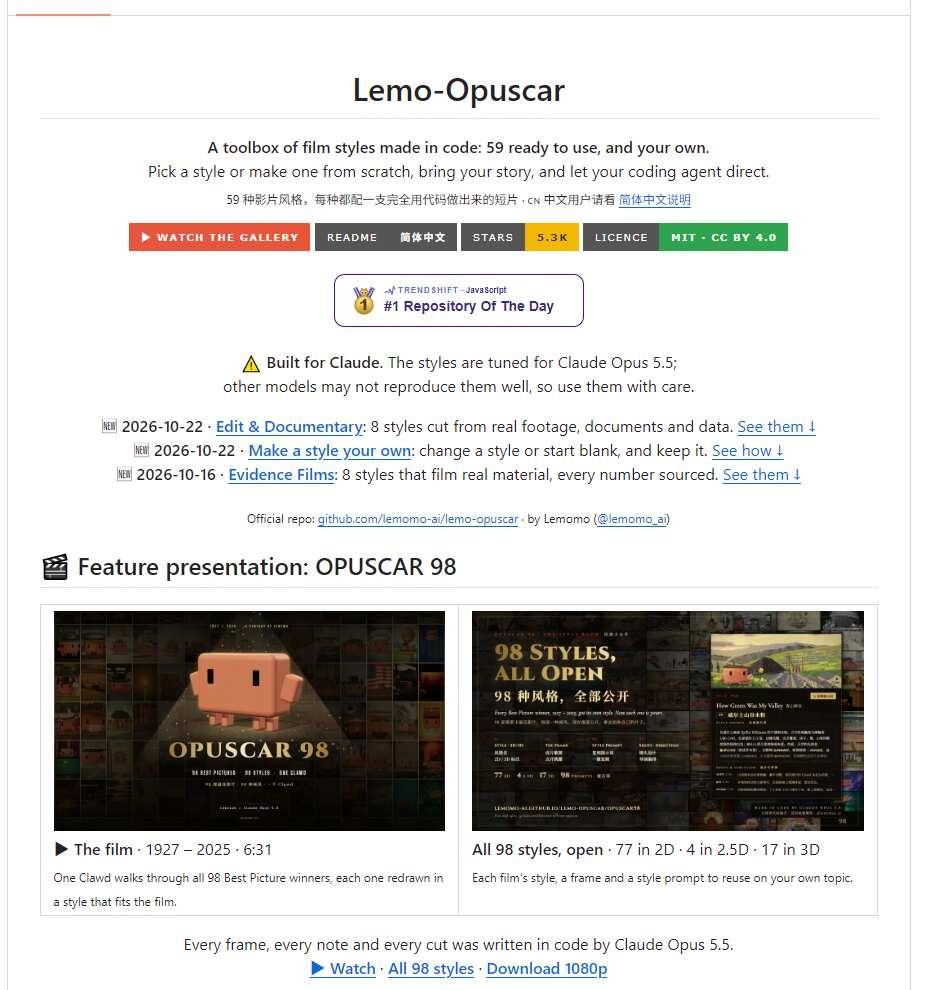
最近发现一个挺有意思的开源项目:**lemo-opuscar**。
它让我重新理解了 AI 做视频这件事。
很多 AI 视频工具,靠的是视频生成模型。但这个项目走了另一条路:
🎬 画面用代码一帧帧渲染
🎵 音乐通过采样合成
🎙️ 旁白通过 TTS 生成
🎞️ 最终输出 1080p、24fps 的视频
**不直接调用视频生成模型,也能做出电影感的视频。**
更有意思的是,它不是简单地把文字变成视频,而是把一套完整的视频制作流程交给 AI。
你只需要告诉它:
「用水彩风格,做一支 45 秒的视频,讲述我的咖啡农场,配温暖的女性旁白。」
接下来,它会规划内容、编写分镜、渲染画面、制作配乐,再完成混音。
整个过程大约需要 30–60 分钟,具体取决于任务和运行环境。
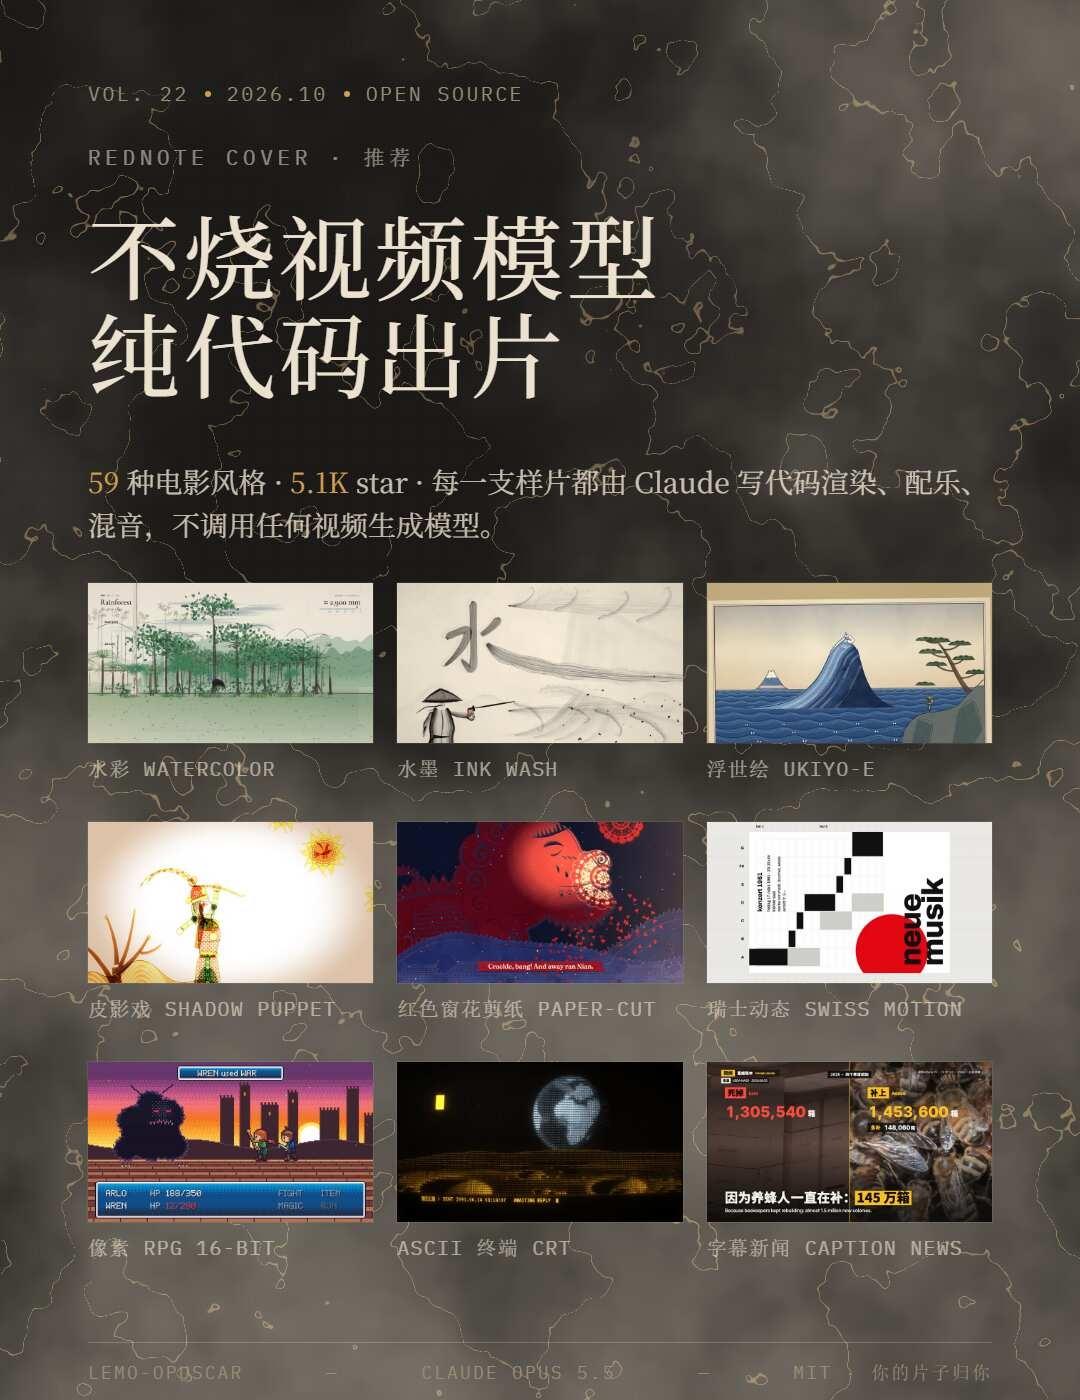
🎨 59 种视觉风格,选择比想象中丰富
它把不同的视觉风格做成了可以复用的模板,目前包含纪录片、手绘、水墨、版画、科技感信息图、像素游戏、微缩景观等多种方向。
比如:
🖌️ 水彩、蜡笔画、油画、水墨
🏮 皮影戏、浮世绘、红色剪纸
🔬 LiDAR 扫描、卫星简报、爆炸拆解图
📊 数据叙事、科技发布会、全息 HUD
🎮 16-bit 像素 RPG、HD-2D
🎞️ 复古新闻片、默片、伪纪录片
🤯 最让我感兴趣的是这两个设计
**1️⃣ 风格不是固定的,还可以自己创造**
不喜欢现成风格?可以修改,也可以从零开始。
AI 会通过提问了解你的想法,先生成一张风格预览图。修改现有风格时,还可以把原版和新版并排对比。
确认满意后,再用这套风格制作完整视频。
**2️⃣ 尽量避免不同视频看起来一模一样**
项目设计了原创性约束:要求先构思自己的故事方案,再参考风格演示,并通过多个维度的差异要求,避免直接照搬示例。
当然,这不等于绝对保证原创,但这个思路值得参考。
我觉得这个项目真正有意思的地方,不是它能不能取代传统视频生成模型。
而是它提供了另一种思路:
**AI 不一定要直接生成每一帧,也可以通过代码、设计规则和自动化工作流来完成视频创作。**
对于知识科普、数据可视化、品牌故事、风格化短片等内容,这种路线很值得研究。
AI工具 开源项目 AI视频 人工智能 效率工具 程序员