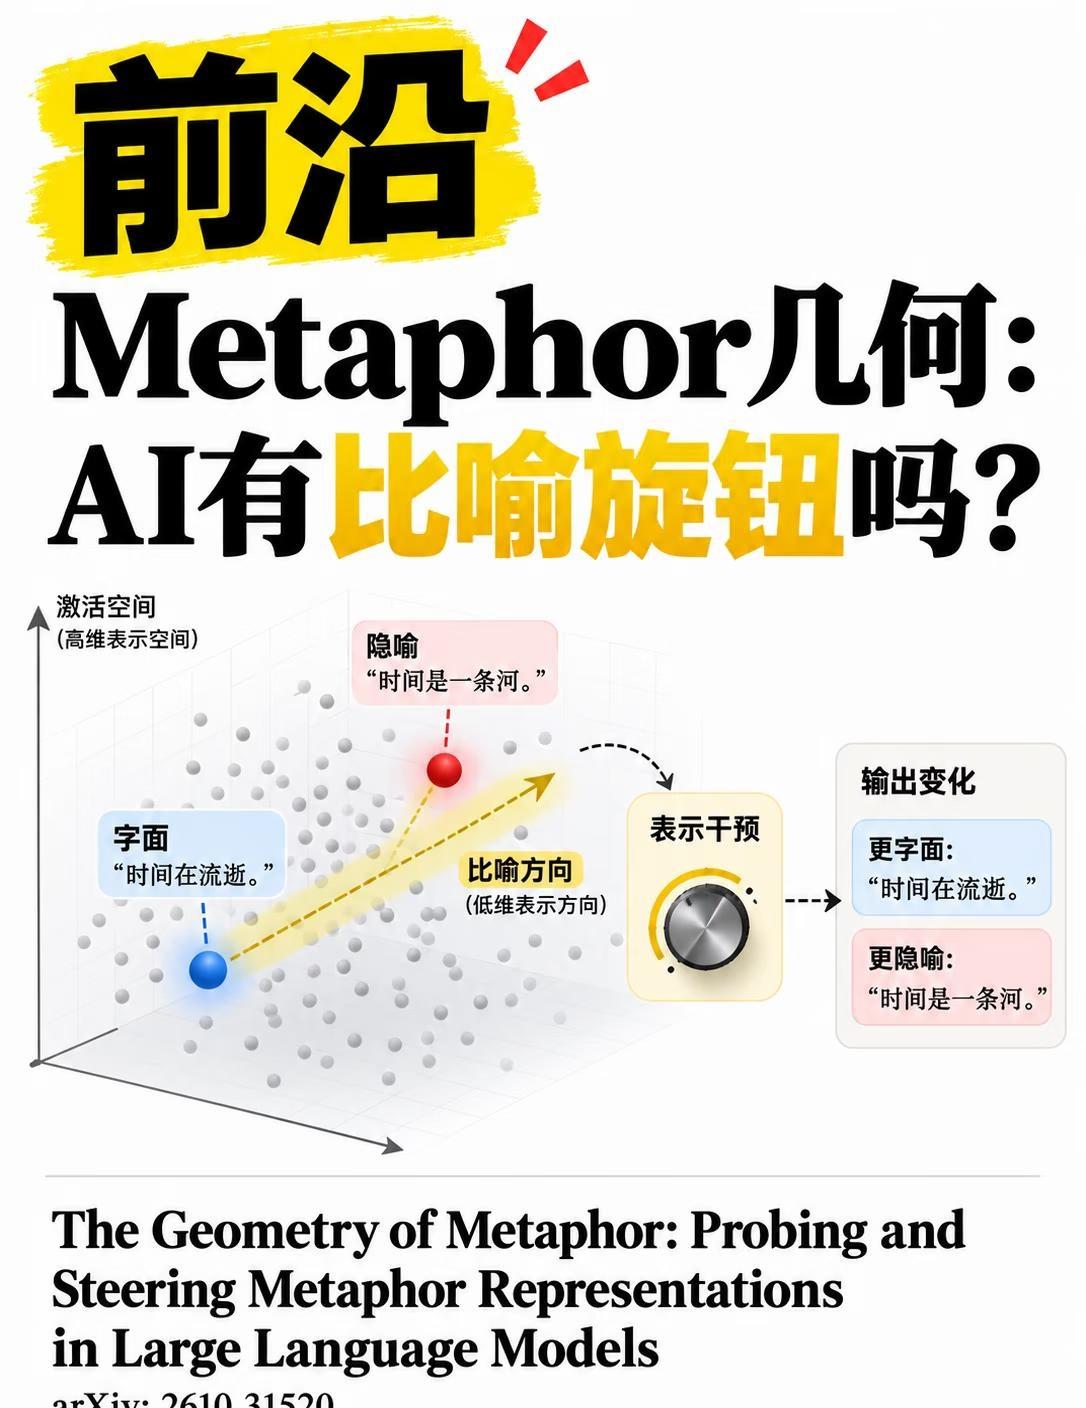
Metaphor几何:AI有比喻旋钮吗?
“他的想法是一座桥”,人能听出这不是在描述建筑。大语言模型也会判断和生成比喻,但它内部究竟怎样区分字面与隐喻?论文《The Geometry of Metaphor》把问题从“模型答对了没有”,推进到“哪些内部表示真的影响了答案”。
研究者比较字面和隐喻表达,观察模型中间层的激活。一个常见做法是先找出能区分两类句子的方向;但“能分类”不等于“决定输出”。因此论文还做因果干预:把某些层和位置的激活替换,或沿着发现的方向调整,再看模型的隐喻判断是否改变。
Kimi 介绍提到两类技术:激活修补,以及分布式对齐搜索(DAS)。前者逐层、逐位置测试哪里对判断有作用;后者在高维激活中寻找一个较低维的子空间,并只修改这部分信息。可以把子空间想成控制台上的一个旋钮,但这只是比喻:它不表示模型里真有单独的“隐喻神经元”。
实验不只让模型回答“这是比喻吗”。作者还考察不同词性上的分类任务,以及生成任务。摘要报告,识别出的因果子空间可跨多种模型架构和规模,用干预能改变分类输出;在文本生成中,也能影响表达的隐喻程度。这比仅在可视化图上看到两类点分开更有说服力,因为干预直接改变了模型行为。
但“能调节隐喻性”不等于每次都能写出自然、贴切的比喻。模型输出还受主题、语境、干预强度与评测方式影响。找到可操作的方向,也不能证明人类隐喻认知就在同一几何位置上。
这项工作的价值,是把修辞这种看似抽象的语言现象,转成可定位、可干预的表示问题。它为理解模型的写作风格提供了新工具,也提醒我们区分两件事:模型是否能写出比喻,以及我们是否知道怎样在内部可靠地控制它。
论文:The Geometry of Metaphor: Probing and Steering Metaphor Representations in Large Language Models
arXiv: 2610.31520
AI前沿 大语言模型 模型可解释性 语言学