上海AIlabRIPPLE:反思能纠错
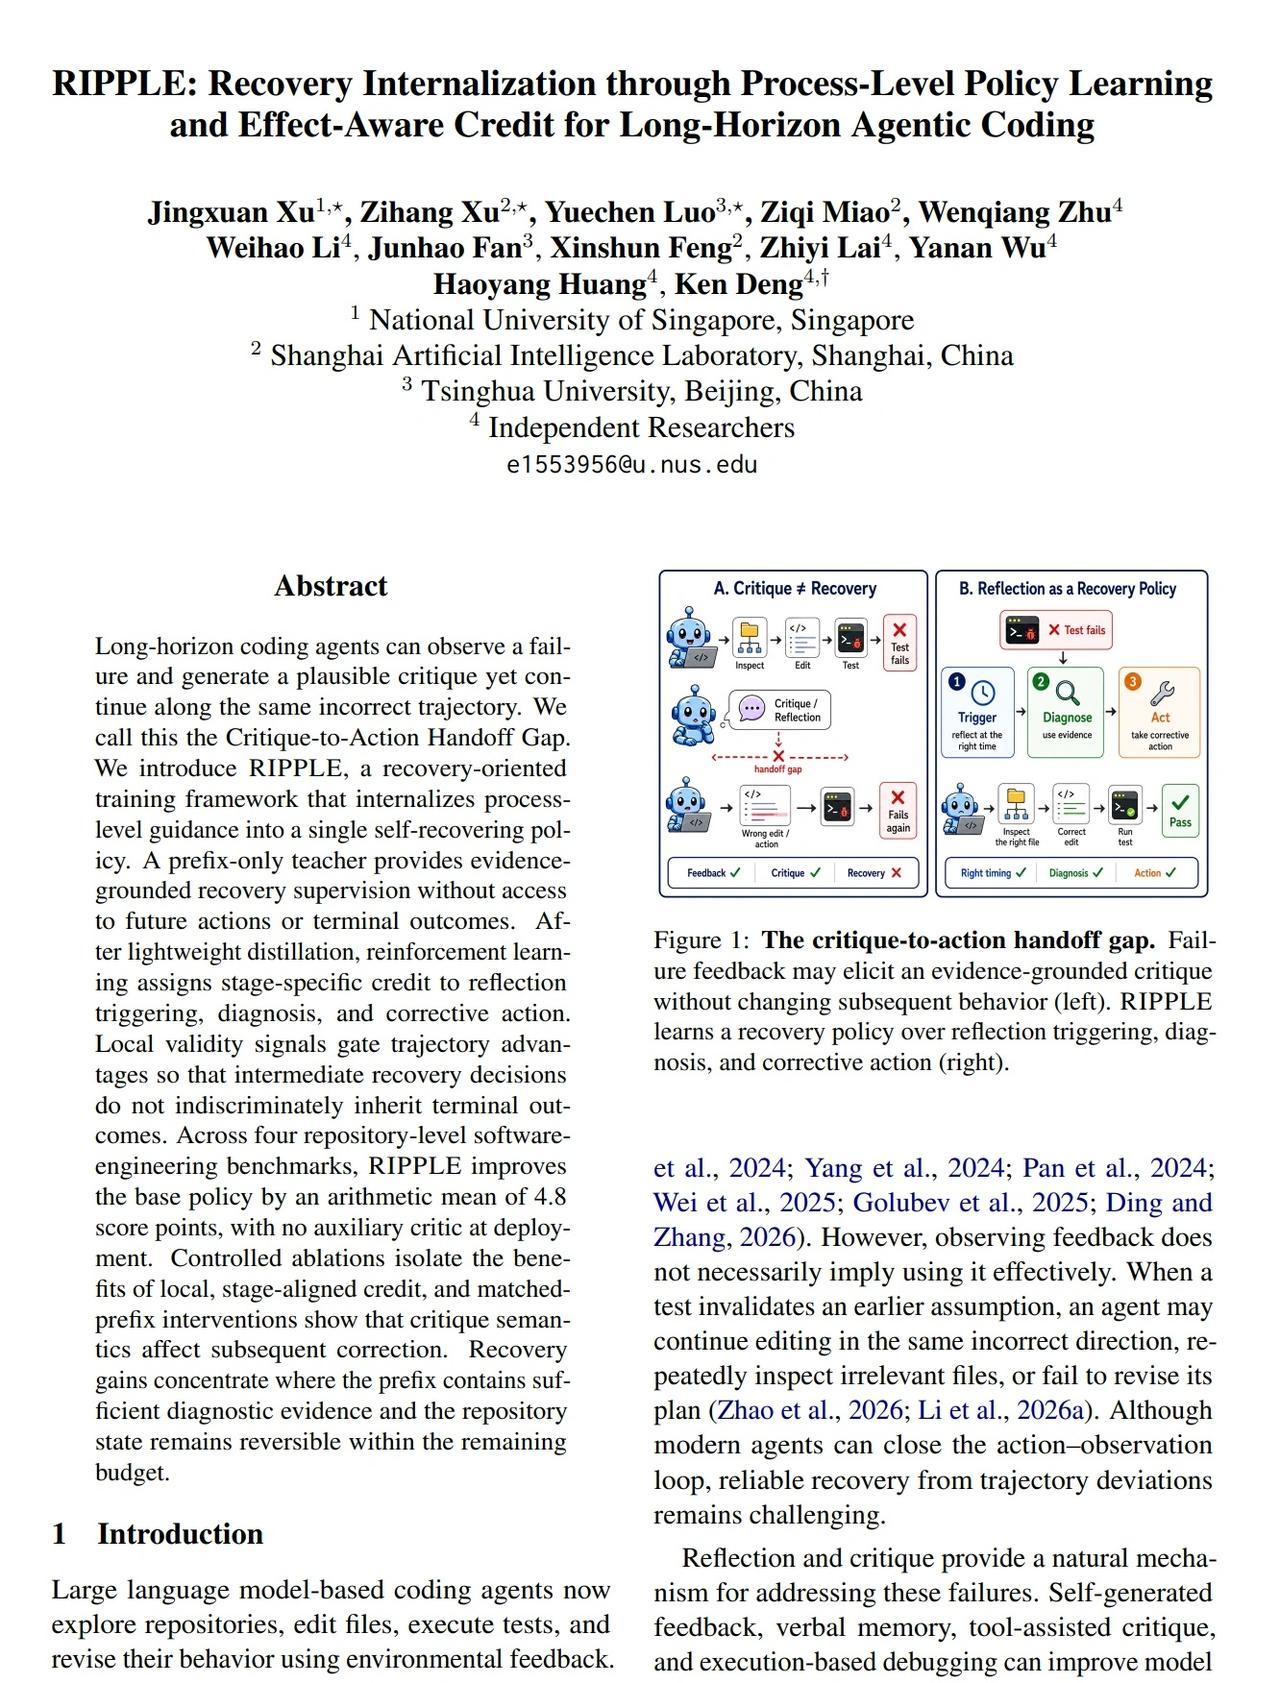
Coding Agent 修改代码、运行测试后,即使指出错误原因,下一步仍可能沿错误方向编辑。反思文字合理,不代表执行策略已经改变,长链路任务会因此反复消耗修复预算。
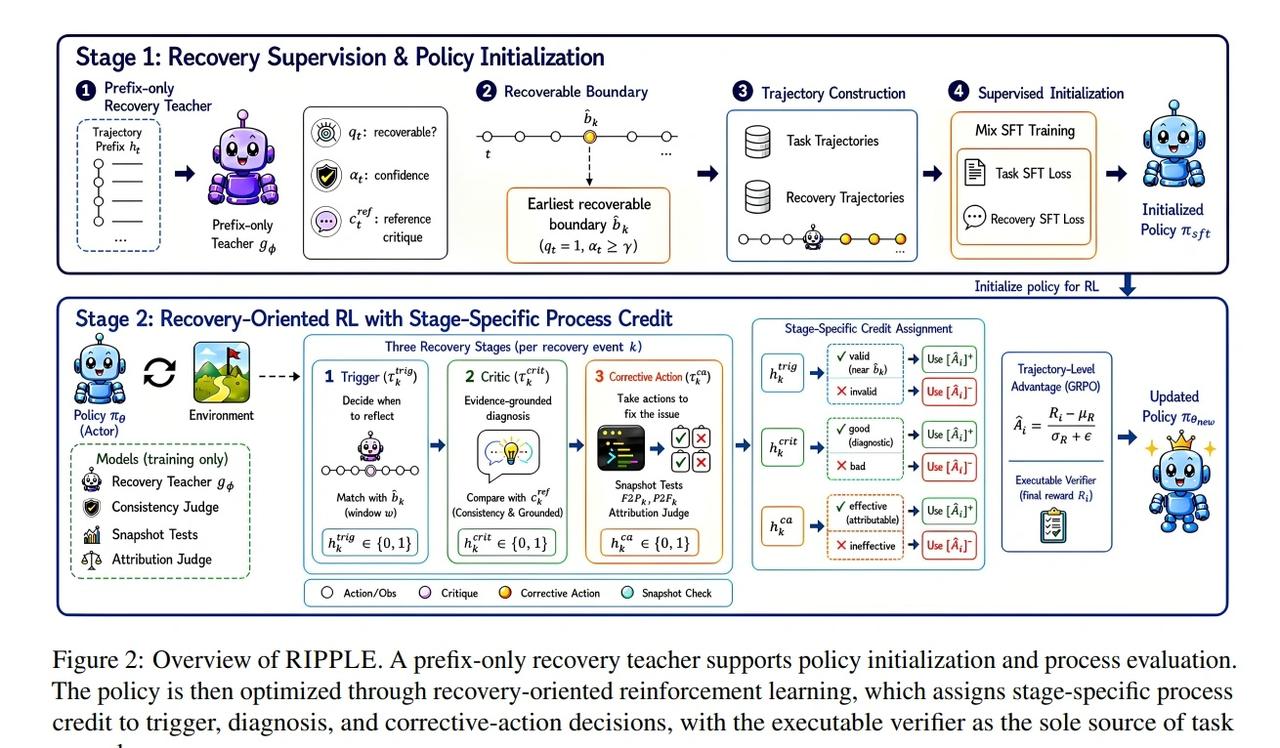
上海人工智能实验室、新加坡国立大学和清华大学提出 RIPPLE,把失败恢复拆为触发反思、证据诊断、执行纠正三个阶段。训练用的轻量 Teacher 只读取当前轨迹前缀,判断错误是否可见,并给出测试证据、失效假设和修改方向,不借用未来动作或任务结果。
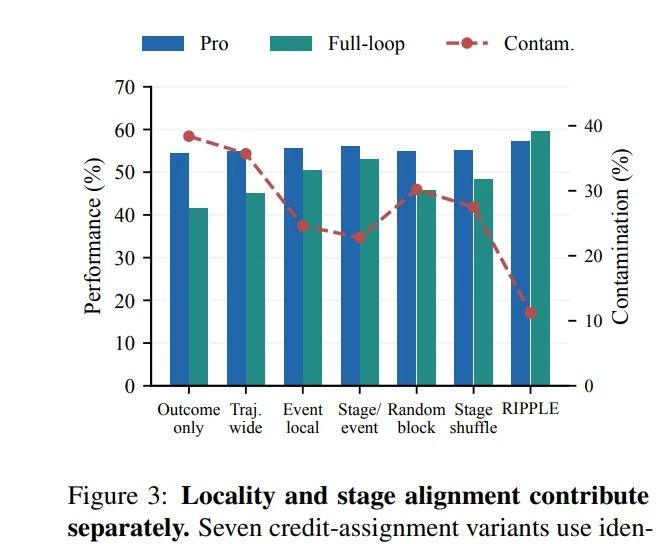
系统先混合常规轨迹与纠错轨迹进行 SFT,再在 GRPO 式强化学习中分阶段分配信用。触发阶段核对反思时机,诊断阶段检查证据与原因;动作阶段比较修改前后的测试快照,确认修复的用例、新引入的回归,以及操作是否遵循诊断方向。局部有效性门控决定各段能否继承轨迹奖励,避免成功任务中的无效反思被强化。部署时只保留单个 Coding Agent,无需在线评审模型。
基于 Qwen3.5-27B,在 SWE-bench Verified、Pro、Multilingual 和 SWE-Compass 上,得分分别从 74.6、50.8、68.8、24.3 升至 75.9、57.3、73.6、30.7,四项平均提高 4.8 分。固定恢复测试中,完整恢复率达 59.6%,仅使用结果奖励时为 41.6%。
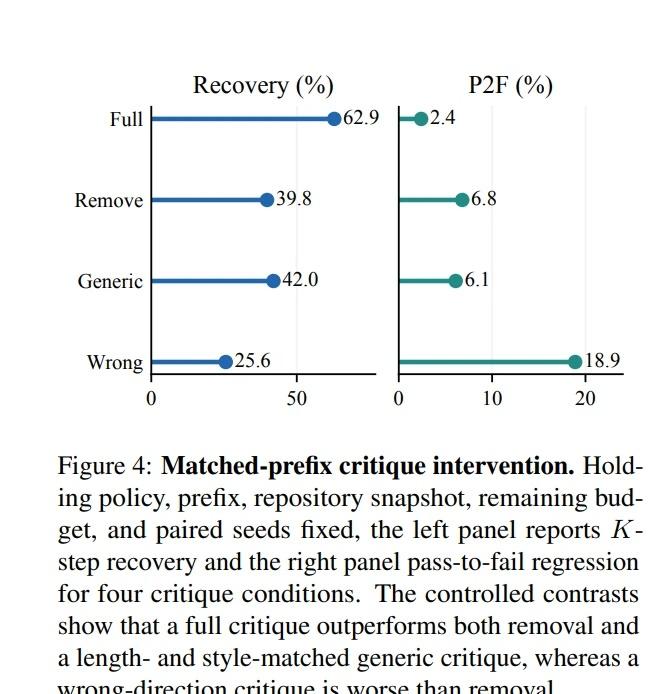
消融显示,移除纠正动作的独立信用后,Pro 从 57.3 降至 54.0,完整恢复率从 59.6% 降至 43.5%。保持仓库状态相同,保留具体反思时后续恢复率为 62.9%;删掉反思为 39.8%,给出错误修正方向则降至 25.6%。
实验仅覆盖一个 Coding Agent 框架和模型底座,过程标签与测试快照增加训练成本;部署 Token 用量增加 17%,尾部延迟增加 23%。证据不足或仓库状态难以逆转时,恢复收益也明显受限。让反思真实影响后续修改,使 Agent 的纠错成为可训练、可检验的行为能力。
AI CodingAgent RIPPLE 强化学习 软件工程