浙大:长文档Agent要管好证据
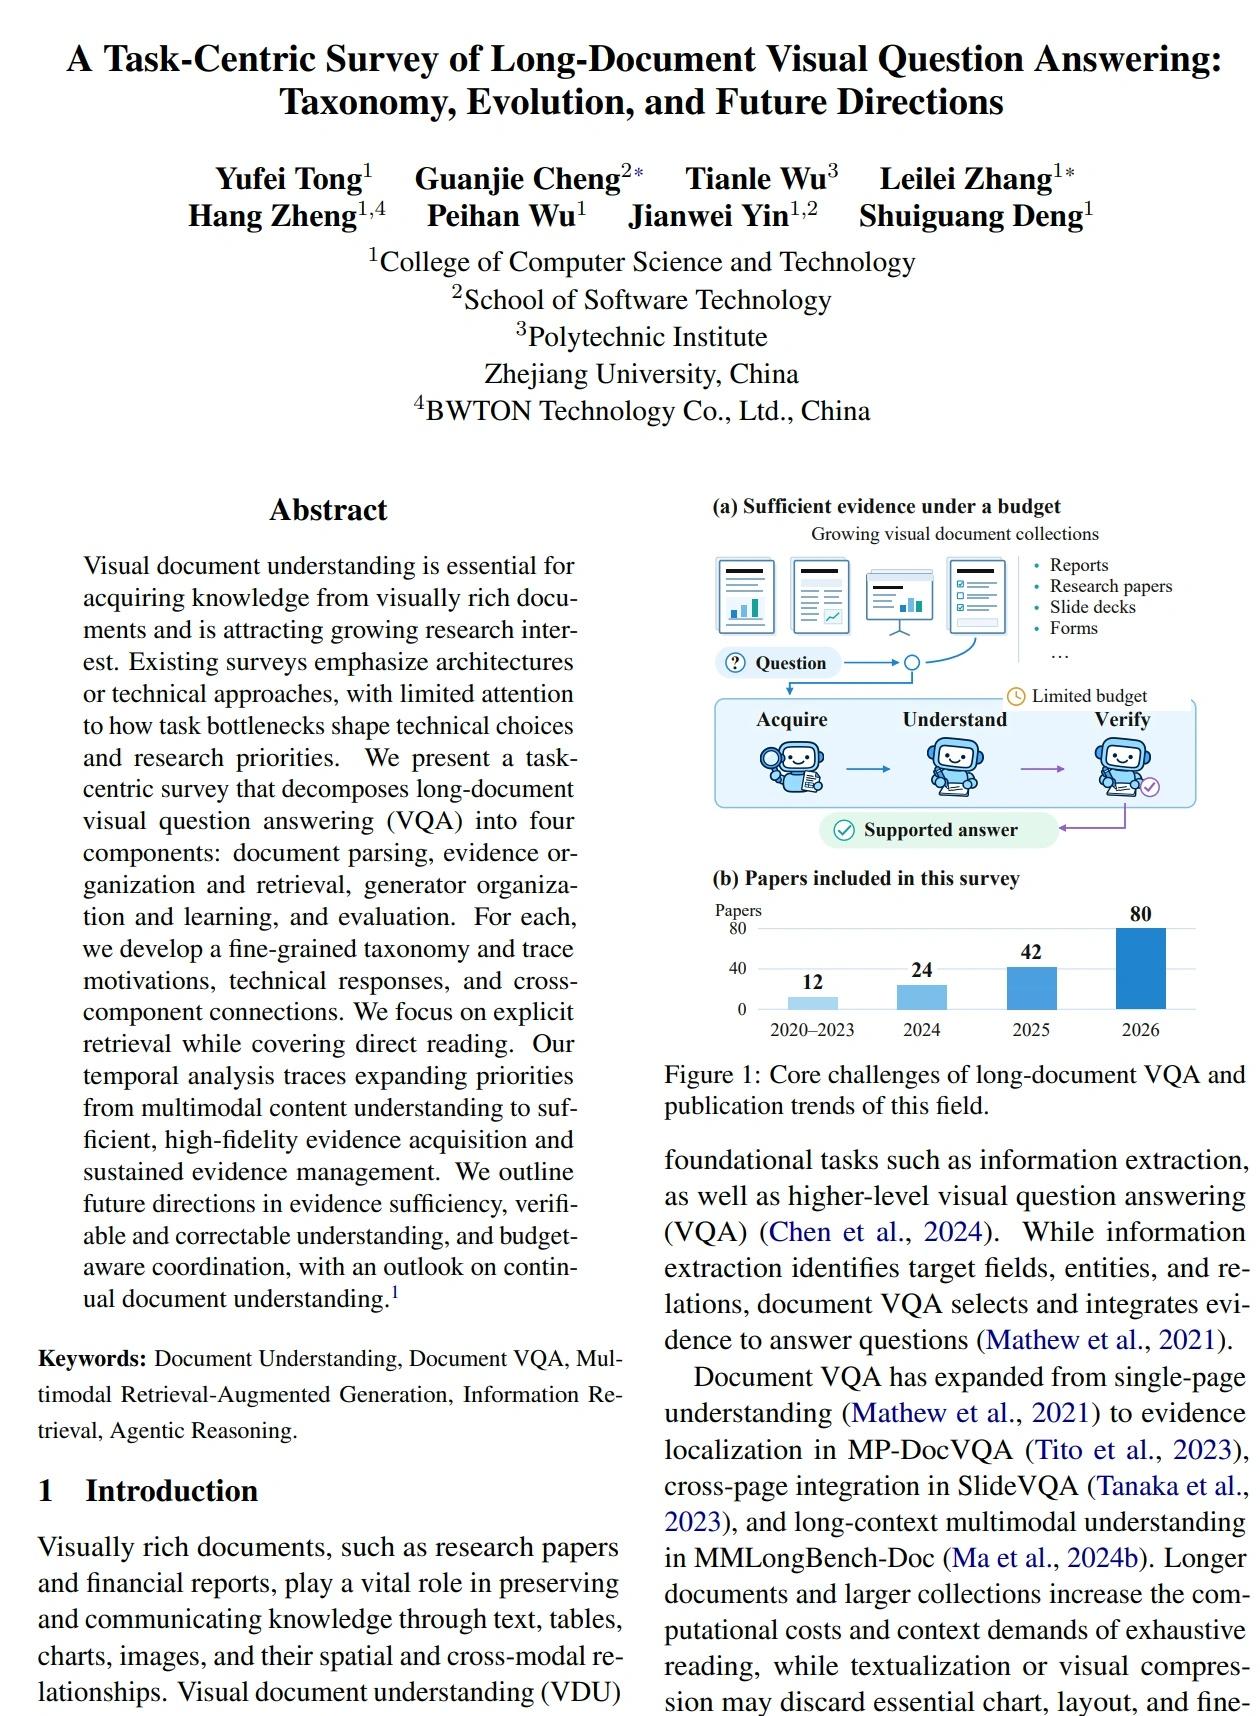
面对上百页财报、科研报告和合同,Agent 即使找到相关页面,也可能遗漏跨页表格、图表和关联信息。OCR 会损失部分布局关系,直接读取整份文档又受到上下文与计算预算限制。检索命中相关内容,并不意味着证据已经足够回答问题。
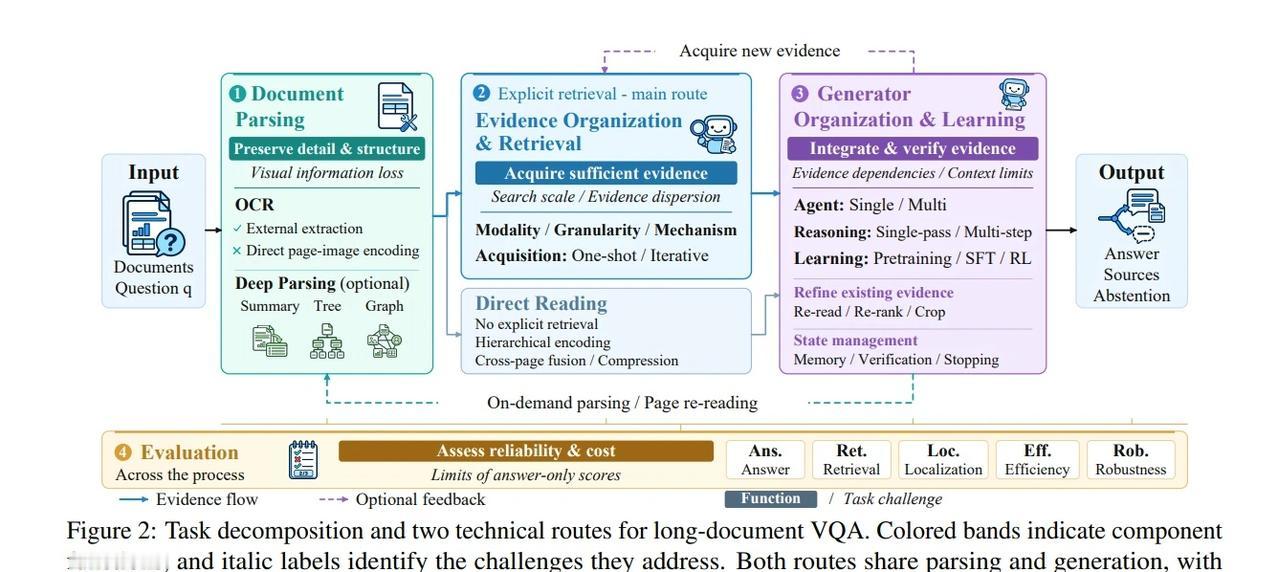
浙江大学研究团队系统梳理 150 余项长文档视觉问答研究,将技术体系拆为 4 个相互关联的环节:文档解析、证据组织与检索、答案生成与学习、评估。
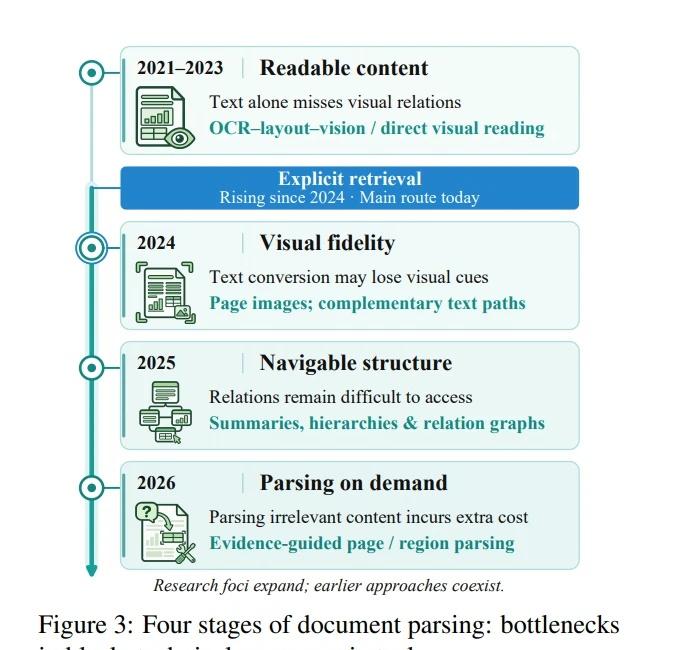
解析阶段需要在 OCR 文本、原始页面图像、目录树和关系图之间权衡。文本便于索引,却可能破坏表格结构;图像保留视觉信息,但小字和复杂布局仍可能丢失。检索阶段则进一步决定按整页、章节还是局部区域获取证据,并通过多轮反馈补充遗漏内容。
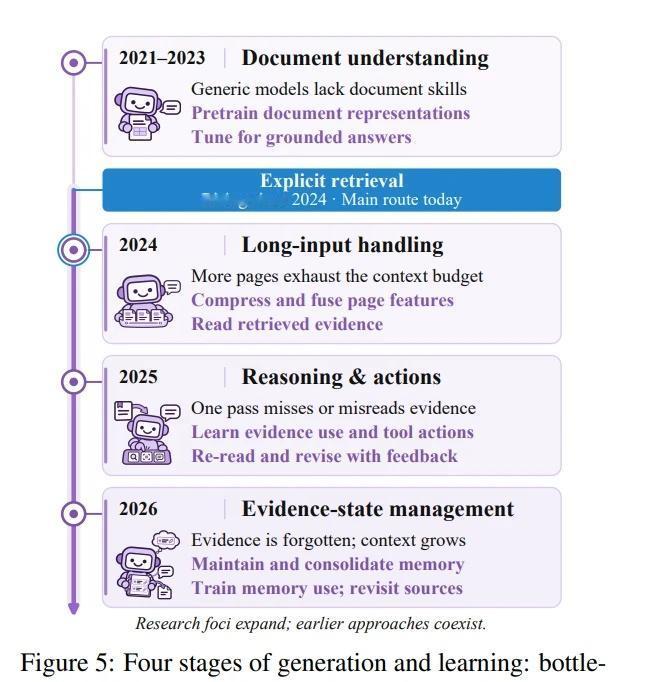
技术演进已经出现清晰变化。ColPali 采用页面视觉多向量匹配,DocAgent 利用层级结构导航,VRAG-RL 通过 SFT 和强化学习训练检索、局部检查与回答的交替决策。DocMemo 则维护页面证据状态和问题记忆,辅助决定何时继续检索、何时停止。
约 80% 的所梳理方法采用显式检索路线。评测任务也持续变复杂:MMLongBench-Doc 平均包含 47.5 页,33.7% 的问题需要跨页证据,20.6% 无法从文档回答;M-LongDoc 的平均文档长度达到 210.8 页;DocScope 中跨页问题占 57.7%。
这些数字反映了任务规模与证据要求,并非某个新模型的性能提升。研究没有独立训练新模型或开展模块消融,而是比较不同技术路线的工程取舍:整页检索保留上下文,却容易引入噪声;局部检索节约 Token,却可能遗漏关联证据;多轮 Agent 检索改善覆盖范围,同时增加工具调用成本。
当前评估仍偏重答案正确率,证据充分性、错误修正和跨任务记忆缺少统一衡量方式。长文档 Agent 的发展方向正在转向可追溯的证据管理,以及检索、阅读、核验和计算预算之间的协同决策。
AI Agent DocumentVQA 多模态RAG 长文档理解