美国终于发现,中国干了一件连上帝都没想到的事,中国芯片竟然来了一个回马枪。
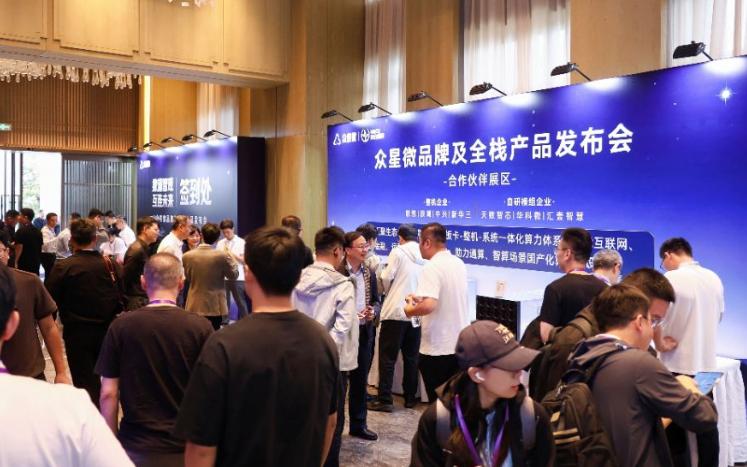
就在所有人都以为中国芯片还在光刻机的死胡同里打转时,2026年10月15日,江苏无锡。江苏无锡众星微等本土芯片企业,一口气亮出12款已经实现量产的自研高性能互连芯片,当场甩出的硬核数据直接震住了全场:累计出货量突破80万颗!
80万颗,听着就是个数字。但你得先搞懂一件事:这不是摆在展柜里看个新鲜的"样品芯片",这是已经焊进服务器、在你我手机和银行系统里日夜干活的真家伙。
更关键的是——它干的这行,过去根本没人觉得中国能碰。
打个比方。把一台AI服务器想象成一座大城市。CPU、GPU是一座座工厂和写字楼,硬盘是仓库,网卡是出城的高速口。那城里这么多车谁先谁后、谁跟谁对接、堵了谁来疏?靠的就是一颗叫"互连芯片"的交通调度中心。服务器内部数据要跑,靠PCIe交换芯片;服务器和服务器之间要传,靠网卡;海量数据要存要护,靠RAID芯片。这东西看不见摸不着,可它一旦掉链子,再贵的GPU也得在那儿干瞪眼。
这么要害的位置,过去是谁坐着?美国博通。一家公司,几乎把全球企业级互连芯片的桌子全占了。你别觉得这芯片用量小——一台8卡的AI服务器,里头就得塞4颗PCIe交换芯片;等到了超节点时代,一个节点要装几十上百颗。算力越往上堆,这条"路"就越宽,它卡你就卡得越狠。中国呢?六年前的状态,用他们自己的话说叫"四无":没人才、没代码、没核心IP、没产品。等于一条高速公路,设计图纸、红绿灯、收费系统全在别人兜里,你想自己修,连个看过图纸的人都找不到。
所有人的眼睛都盯着光刻机,好像中国芯片就剩这一仗。可人家悄悄绕到侧翼,先把"路"给修了。
这就是回马枪。
看看这组爬坡的数字,你就知道这枪是怎么出膛的:2022年8月,第一代产品量产,首批出货——280颗。2024年,全年大约5万颗。2025年,年底累计40万颗。到今年10月,80万颗。年底,奔着100万颗去。
从280颗到80万颗,四年,三百倍。这不是实验室PPT上的数字,是一颗颗焊进板子、跑进机房的真实出货。
它跑进了哪里?说出来你可能没感觉:你早上用手机点开一个APP,你去银行办一笔转账,你在保险公司签一份电子合同——这些流程背后,可能就有这家公司的芯片在替你搬数据。运营商的云里,它的产品铺了将近10万片,稳稳跑了18个月没出事;金融系统里,RAID芯片规模部署5万多片,扛的是微秒级延迟、百万级并发这种银行最要命的指标;到了AI领域,全国产十万卡级算力集群建设,它一口气6款芯片入选,部署了大约20万颗。
最提气的是最后这一笔:用国产互连芯片搭出来的集群,整体建设周期比传统进口方案,至少缩短了一个月。一个月,在抢算力的战场上,那是真金白银。
而且人家不是关起门来"交作业"。现场一把拉住七家伙伴签了战略协议,操作系统要认它,整机厂要用它,云平台要跑它。目前它的产品已经适配了15家以上云平台、50个型号操作系统、300种硬盘和光模块,跟15家主流算力芯片、7大CPU平台打通了对话。这才叫成了气候。
这次发布会上,它还顺手掏出三款新家伙:PCIe 6.0交换芯片,单通道速率比上一代翻一倍,144个通道、100纳秒级时延;800G多协议AI网卡,首颗国产同类产品,专门冲着万卡级AI集群去的;还有一颗全国产IP、全国产设计制造的多模RAID芯片,直接杀进金融这种对可靠性苛刻到骨子里的行业。
这还只是眼前。按他们亮出的路线图,到2030年,PCIe 7.0、8.0交换芯片,1.6T以上的AI网卡,连光互连交换芯片都要自己做。也就是说,这一枪不是打到这儿就停了,枪口已经指向下一个十年。
有人会问:是不是靠政策单子喂出来的?这个数字,是在没有专项政策倾斜的情况下,一单一单在市场里拼出来的。互联网公司要用,运营商要扛,银行要稳——客户的账本比谁都严,不好用早就退货了。
还有个细节特别有意思:这家公司研发用的网络,全是用自家芯片组起来的。自己造的路,自己先跑。这跟那种拿别人芯片做集成的玩法,根本不是一个物种。
六年前团队从零开始读标准、养队伍,六年,近百项关键技术从系统设计到高速信号再到量产工艺一路啃下来,做到国内产品品类最全、技术链条最完整、出货规模最大。从"跟跑",到"并跑",再到个别特性上"领跑"。
外人盯着光刻机叹气的时候,他们没吭声,低头把数据中心里那条看不见的"高速公路"修通了。80万颗不是终点,年底100万颗也不是。真正让人回味的是发布会上那句感慨:这个时代给了我们做点事的机会,这点事,超越了养家糊口的意义。