代码图谱最狠的失败不是画错,是画漏了还看不出来
Graphify 这周在 GitHub 周榜第六,一周涨七千多 Star,总数十三万六。它是个给 Claude Code、Codex、Cursor 用的 skill:敲一句 /graphify .,项目的代码、文档、PDF 被压成一张能查的知识图谱。
首页最上面那行粗体不是介绍,是「Cut agent token spend by 80%」。往下拉两屏,「Start a free 14-day trial」出现四次。YC S26,开源加云版。
留下我的是一句几乎没人敢写在首页的话:Every edge is explained。每条连接都带标签,EXTRACTED 是源码里明写的,INFERRED 是它自己推的。不是「我们检索很准」,而是「这条我读出来的,那条我猜的」——猜的还要给分。
问「谁调用了这个函数」,它信心十足报三个调用点,你去搜,两个不存在。它不是存心骗人,是分不清「我读到了」和「我觉得像」。把这两件事分开标,是这功能唯一的真价值。
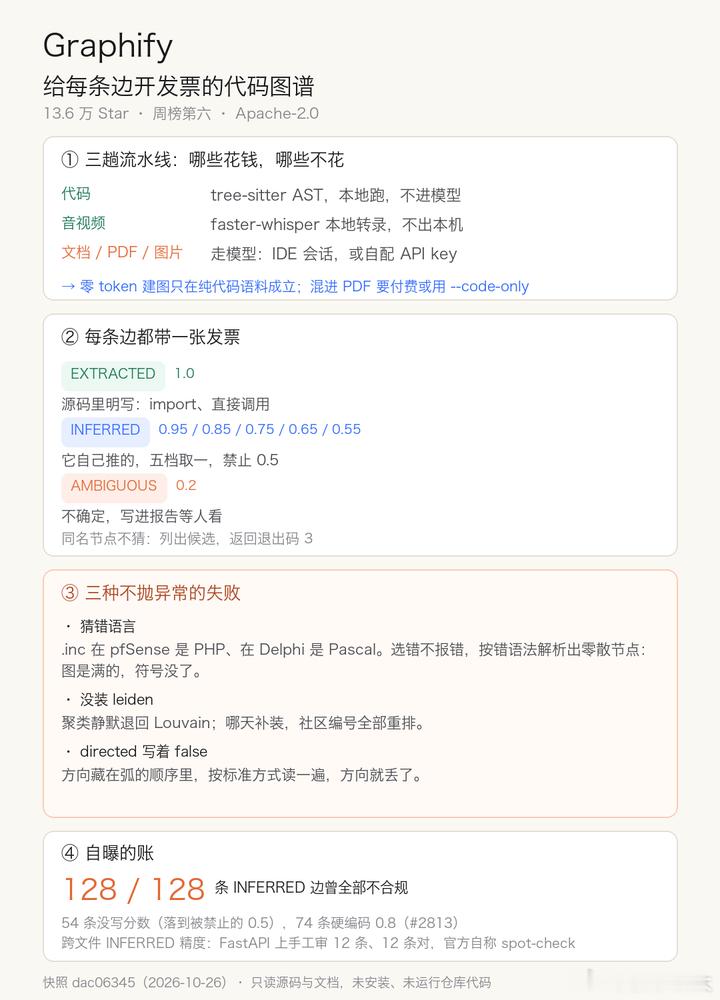
流水线三趟:代码走 tree-sitter,本地跑不进模型;文档、论文、图片走模型,用你 IDE 会话里那个,或自己配 key。所以「零 token 建图」只在纯代码语料成立,混进 PDF 就得付钱,或者 --code-only 把非代码文件跳过。
置信度真做了梯度:INFERRED 只能从 0.95、0.85、0.75、0.65、0.55 里挑,明令禁止 0.5;AMBIGUOUS 默认 0.2;EXTRACTED 恒为 1.0。同名节点它不猜,列候选给你,退出码 3。
然后在测试目录里看到更诚实的东西。tests/test_inferred_confidence_rubric.py 开头写着:在 graphify 自己的代码包上,128 条 INFERRED 边,128 条不合规——54 条没写分数,落到被明令禁止的 0.5;74 条硬编码 0.8(2813)。这套很专业的置信度曾是装饰品,还是它自己人先发现的。
真正让我坐直的不是准不准,是它怎么失败。
.inc 在 pfSense 是 PHP,在 Delphi 是 Pascal;.h 是 C 还是 C++。选错语言,文件不报错,它按错的语法解析,吐出一把零散节点——图看上去是满的,真正的符号没了。README 自己写:the graph looks populated while the real symbols are missing。同款还有两个:没装 leiden,聚类静默退回 Louvain,装上后社区编号全部重排;directed 写着 false,方向藏在弧的顺序里,按标准方式读一遍方向就丢。
三种都不抛异常,你得先怀疑它才会去查。文档那趟会编符号,处理方式是给编出来的节点打 verification: unverified,但不删——注释原话 never dropped。删了会误删真的;代价是那条边还在,旁边挂个你多半不会看的字段。
首页那个 0.497 的 recall真写在自家 harness 表里:mem0 是 0.048,supermemory 是 0.149,星号注明被自家 768 维英文 embedder 拖累。同一张表往下看,QA 准确率它 45.3%,supermemory 49.7%。它没藏。至于 INFERRED 跨文件边的精度,证据是在 FastAPI 上手工审了 12 条、12 条都对。十二。它自己叫 a dated manual spot-check——我尊重这份坦白,但 12 条撑不起「每条边都可信」,只撑得起「目前没抓到反例」。
README 还说 Not a vector index,No embeddings。翻到 BENCHMARKS.md 的公平性条款,「一个共享的本地 embedder:BGE-m3,1024 维」。不算撒谎,建图不花 LLM 的钱;但「没有 embeddings」这句,在它自己文档里不成立。基准页最后更新 2026-07-05,版本已经 0.9.96,账没空对。
我的判断:问「谁调用了谁、改这里会动到哪」,纯代码、零 token、每条边带出处,它目前最省事。想要「一个记忆层,把会议记录、代码、文档全塞进去,它什么都记得」——那正好是它首页在卖、开源版最勉强也最贵的部分。
第一步:--code-only 跑一次,打开 graph.json 数一数 INFERRED 占多少。占比高于预期,把 0.85 当参考,别当事实。图谱最像地图:危险的不是路线画歪,是整片街区被静默省略,你还以为看见了全城。
项目入口:Graphify-Labs/graphify。Apache-2.0,另附 MIT,PyPI 包名 graphifyy(双 y)。