百度的OCR又升级了,文心Unlimited OCR 2正式发布并开源!
这次,它直接挑战一口气读完整套小说。
7部《哈利·波特》,从《魔法石》到《死亡圣器》,连续识别、转写,3600+页一路读到最后。
换成《三体》全集,同样能一口气读完,三本书1200+页,几十万字,中间也不带喘的。
不过,连着读这么多页,模型得先过一道关:显存。
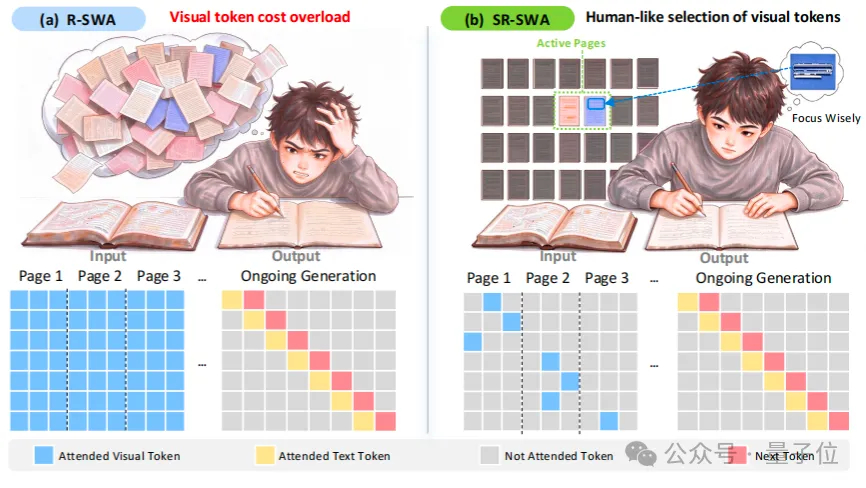
文档越长,推理时需要保留的中间信息(KV缓存)就越多——可以理解为模型边读边记的小抄,页数越多,小抄越厚。小抄厚重,不光占地方,翻起来也慢。
在技术报告的百页级单序列测试中,文心Unlimited OCR 2给出了一组对比:
峰值KV缓存占用从标准解码(将所有页面的视觉缓存同时保留在显存中)的47GB降至1.77GB,一口气减少了约96%。
47GB是什么概念?比不少笔记本电脑的整机内存还大。而这还只是KV缓存,模型权重等其他开销另算。
它的上一代Unlimited OCR,已经凭借多页文档连续解析能力,在开源社区积累了相当的人气:累计下载量超过1000万,在GitHub上收获约2.86万Star。
从社区制作在线Demo,到支持SGlang推理,围绕它的适配也在持续推进。
到了第二代,升级重点在于连续处理更长文档的同时,把计算和缓存负担降下来。
为此,文心Unlimited OCR 2提出稀疏参考滑动窗口注意力机制SR-SWA,让模型按需选取相关页面和视觉信息,减少重复计算。
配合持续解码机制,模型能够连续处理超长文档,单步解码开销也不会随着文档变长而水涨船高。
目前,文心Unlimited OCR 2已在Hugging Face和GitHub正式开源。
开源地址:
GitHub:网页链接
HuggingFace:网页链接
网页链接