在智驾圈,“堆算力”的通胀游戏终于踢到了硬石头。
很多车企买着几百上千 TOPS 的芯片,结果跑最新的端到端大模型时,硬件利用率常常惨不忍睹——纸面算力堆得像航母,实际跑起来却像老牛拉破车。
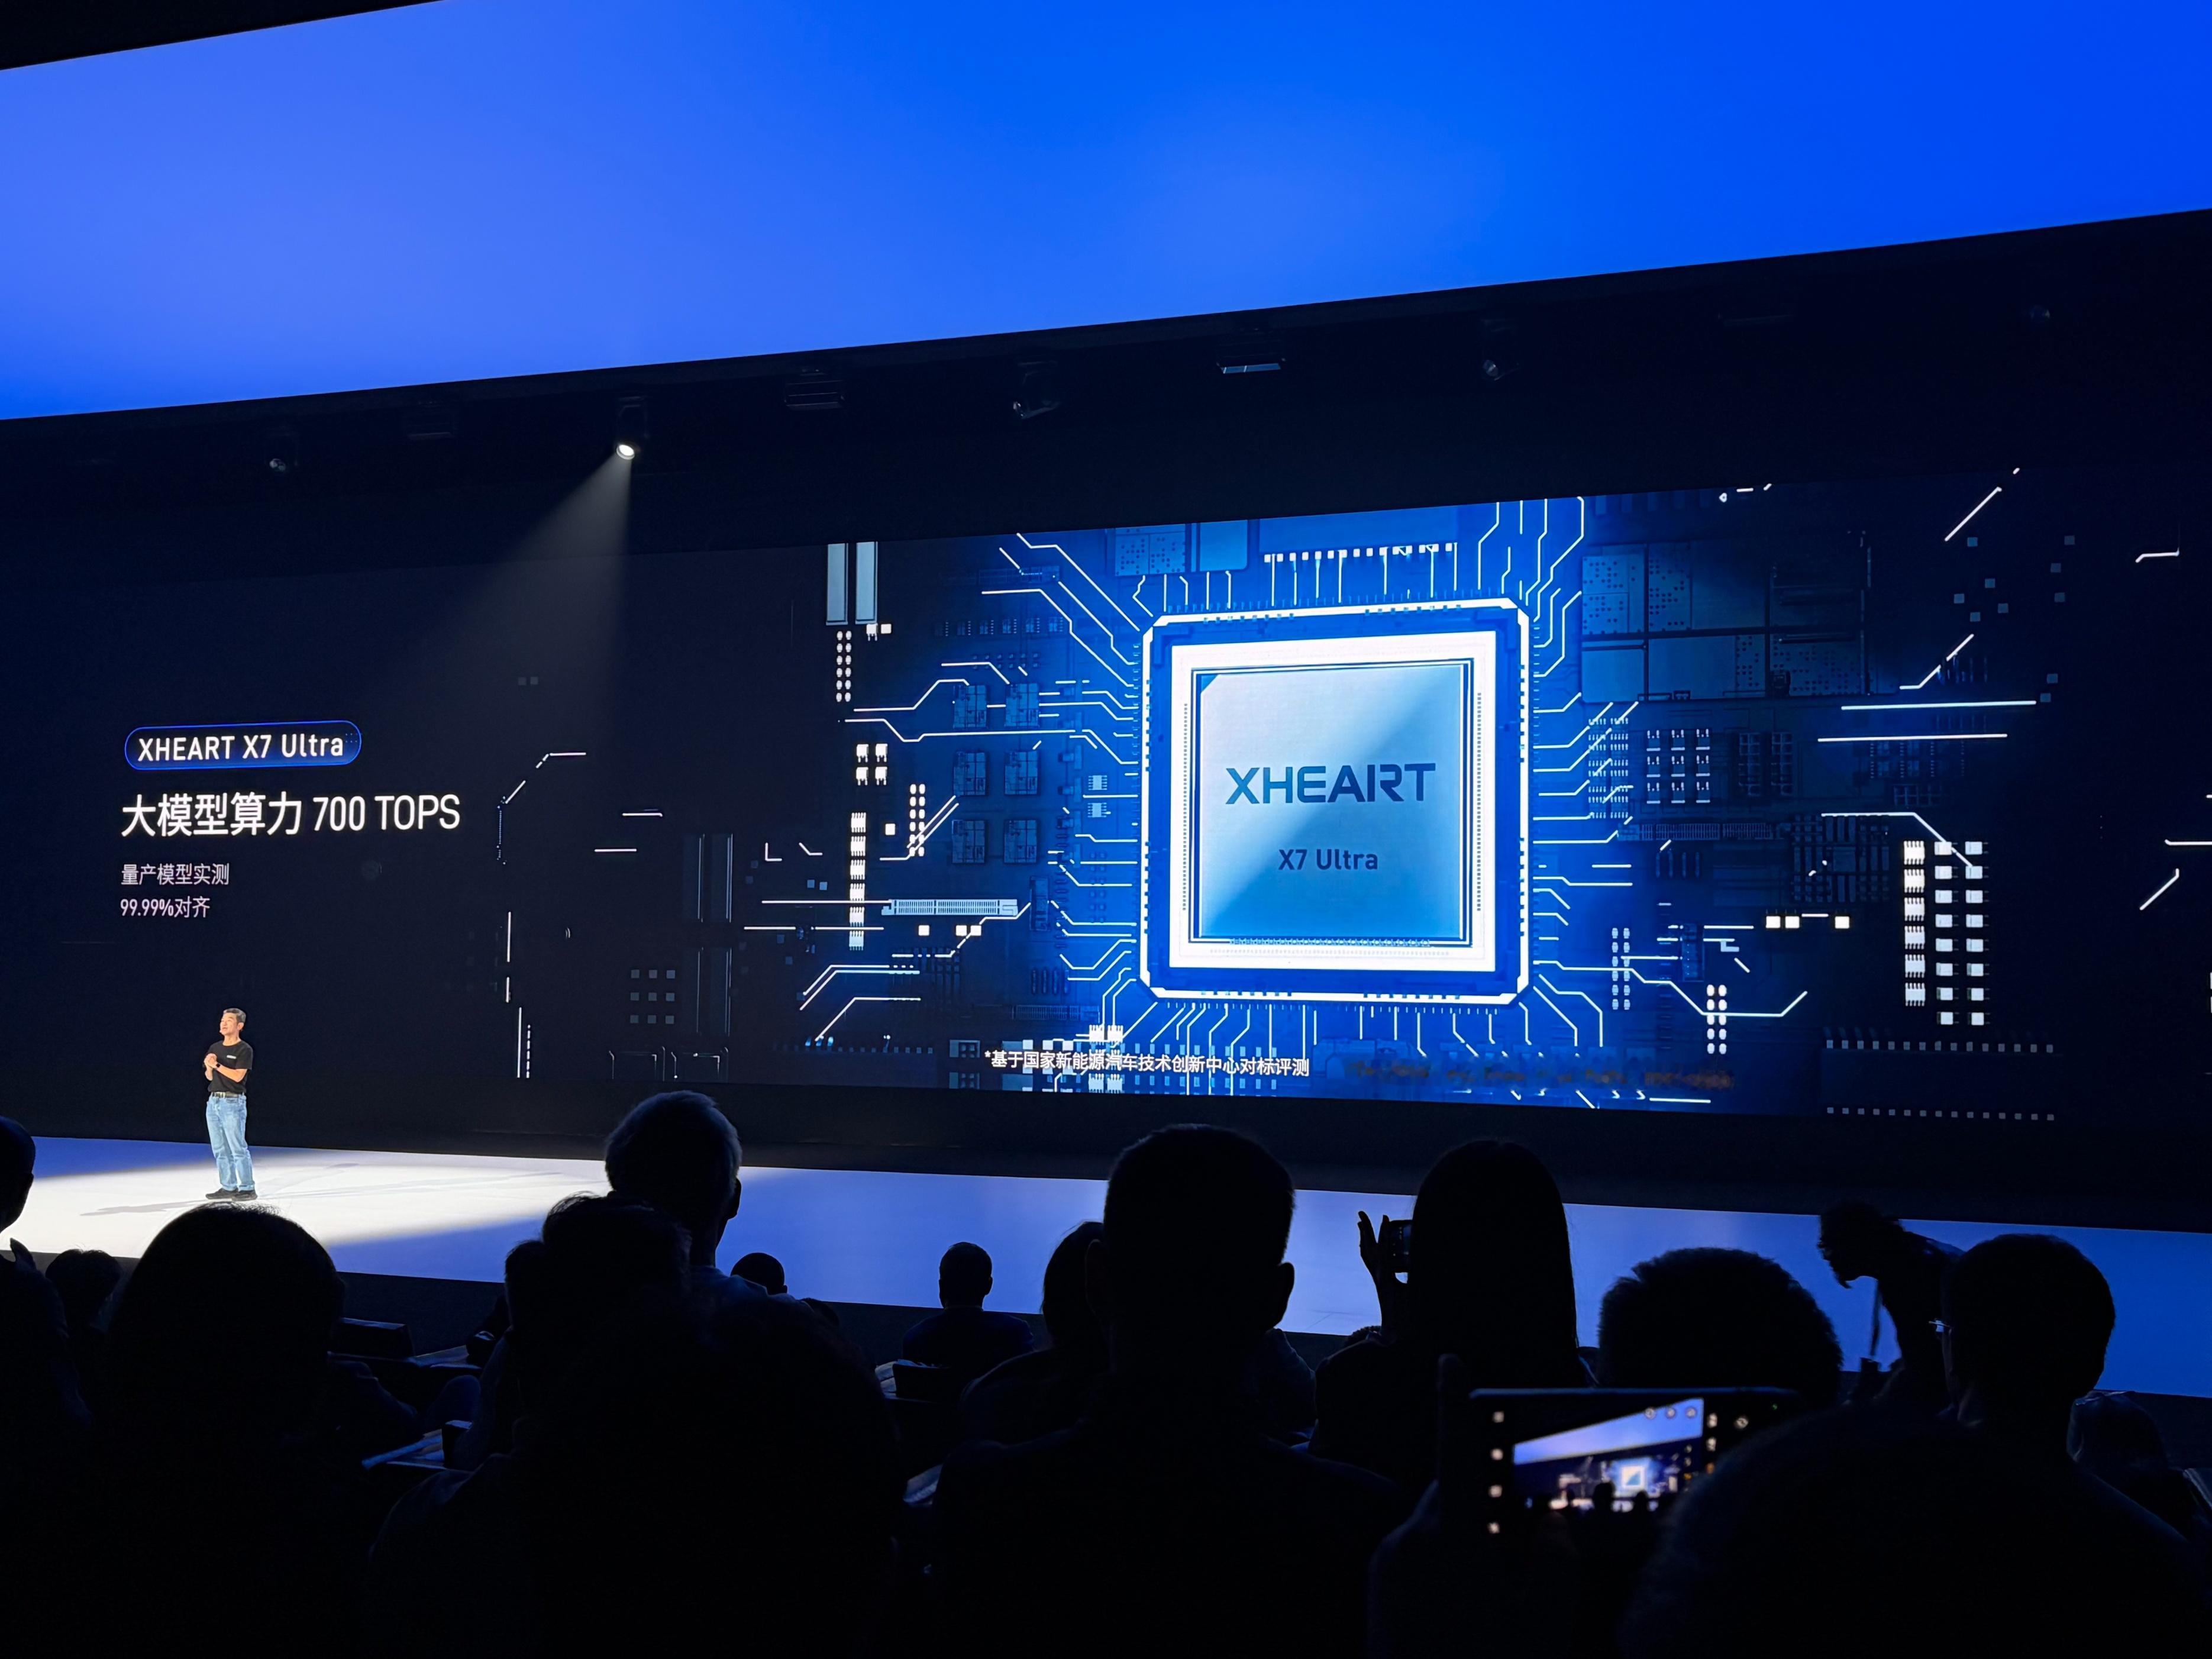
10月29日,XHEART 在发布会上把这个行业秘密给说出来了。
并且,他们给出了解决这个问题的技术路线:“大模型定义芯片”。
过去造芯片的逻辑是:芯片厂商先定义好硬件架构,把 TOPS 参数吹上天,然后扔给车企算法团队:“硬件做好了,模型怎么适配是你们的事。”
这给芯片行业砸过来了三道致命难题:
第一,算力虚标与利用率滑铁卢。
端到端大模型对数据吞吐和内存带宽的要求极其苛刻。许多芯片看似峰值算力惊人,但遇到真实模型中的矩阵运算与复杂数据流时,计算单元大量处于“饥饿状态”,实际有效算力往往低得可怜。
第二,时间的错位割裂。
一颗车规芯片从定义、流片到量产,动辄需要两到三年的周期;而大模型的架构演进是以月甚至以周来计算的。往往是芯片刚拿到量产车上,算法团队就已经抛弃了旧模型。今天造的“铁板”,根本装不下明天的“灵魂”。
第三,能效比的死结。
在车载有限的功耗和散热空间里,盲目靠堆物理面积换来的算力,只会让车载电池和散热系统不堪重负。
XHEART 从 2023 年创业时做出的选择,本质上是一场逆向重构:不再“先造鞋再挤脚”,而是直接拿真实量产场景中的大模型需求作为原点,去倒推芯片架构。
从数据流转路径、存储层级分布到计算逻辑全部重新组织,同时为未来的模型演进预留出足够的弹性空间。
过去大家常嘲笑“为了这碗醋才包的饺子”,但在 AI 智驾时代,芯片其实就是那个盛饺子的碗。碗的形状如果不对,算法再香也装不进车里。
智驾硬件的下半场,早已不是比拼谁的标称 TOPS 更高,而是比谁更懂大模型的演进方向。能把模型的进步毫无损耗地转化为产品的进步,才算把虚幻的“算力数字”,真正变成了跑在路上的“车路智商”。