DC娱乐网

慧然热聊科技的文章

ChatGPT Pro全档位额度翻倍:从砍半到加码凌晨一点,Codex 负责人 Tibo 突然发帖:所有 Pro 档位额度直接翻倍。

前一天大家还在互相提醒“最后一天赶紧用”。结果降额计划当场取消,Pro 100、200、500 和 Business Premium 四档用量全部乘二。Tibo 还特意发了句“We heard your kind feedback”,阴阳 ​
ChatGPT Pro全档位额度翻倍:从砍半到加码凌晨一点,Codex 负责人 Tibo 突然发帖:所有 Pro 档位额度直接翻倍。 前一天大家还在互相提醒“最后一天赶紧用”。结果降额计划当场取消,Pro 100、200、500 和 Business Premium 四档用量全部乘二。Tibo 还特意发了句“We heard your kind feedback”,阴阳 ​
ChatGPT Pro全档位额度翻倍:从砍半到加码凌晨一点,Codex 负责人 Tibo 突然发帖:所有 Pro 档位额度直接翻倍。 前一天大家还在互相提醒“最后一天赶紧用”。结果降额计划当场取消,Pro 100、200、500 和 Business Premium 四档用量全部乘二。Tibo 还特意发了句“We heard your kind feedback”,阴阳 ​
周末原本闲暇 于是跟久未闲聊的网友妹妹闲聊 突然就莫名其妙接了个单  也算是亲身尝试现在AI在行业的应用:把一本小说改成评书稿 要补充(就是AI瞎编)大量的内容 模仿特定说书人的语言特点 设计每回开篇定场诗和结尾的扣儿 还有史料事实核准 以及官衔称谓校验相互间的人物关系等等等等各种 最后跑脚本考 ​

周末原本闲暇 于是跟久未闲聊的网友妹妹闲聊 突然就莫名其妙接了个单 也算是亲身尝试现在AI在行业的应用:把一本小说改成评书稿 要补充(就是AI瞎编)大量的内容 模仿特定说书人的语言特点 设计每回开篇定场诗和结尾的扣儿 还有史料事实核准 以及官衔称谓校验相互间的人物关系等等等等各种 最后跑脚本考 ​

周末原本闲暇 于是跟久未闲聊的网友妹妹闲聊 突然就莫名其妙接了个单 也算是亲身尝试现在AI在行业的应用:把一本小说改成评书稿 要补充(就是AI瞎编)大量的内容 模仿特定说书人的语言特点 设计每回开篇定场诗和结尾的扣儿 还有史料事实核准 以及官衔称谓校验相互间的人物关系等等等等各种 最后跑脚本考 ​
Meta杀回第一梯队:Muse Wonder六周涨8分,六周前,Meta 的旗舰模型 Muse Spark 1.3 在智能指数上才 48 分。现在新出的 Muse Wonder Full 直接飙到 56 分,跟 Sonnet 5.5 平起平坐,把 GPT-6 Astra 的 53 分踩在了脚下。

真正拉开差距的是长任务编程。在要求 AI 持续读需求、改代码、跑测试的马拉松里 ​

Meta杀回第一梯队:Muse Wonder六周涨8分,六周前,Meta 的旗舰模型 Muse Spark 1.3 在智能指数上才 48 分。现在新出的 Muse Wonder Full 直接飙到 56 分,跟 Sonnet 5.5 平起平坐,把 GPT-6 Astra 的 53 分踩在了脚下。 真正拉开差距的是长任务编程。在要求 AI 持续读需求、改代码、跑测试的马拉松里 ​

Meta杀回第一梯队:Muse Wonder六周涨8分,六周前,Meta 的旗舰模型 Muse Spark 1.3 在智能指数上才 48 分。现在新出的 Muse Wonder Full 直接飙到 56 分,跟 Sonnet 5.5 平起平坐,把 GPT-6 Astra 的 53 分踩在了脚下。 真正拉开差距的是长任务编程。在要求 AI 持续读需求、改代码、跑测试的马拉松里 ​
三天,REA 在 GitHub 攒下近 8 万星。年初现象级项目 OpenClaw 同期才 6 万,Jev 前三天的 npm 下载量也就 3.5 万。

它补的是一层对话接口。以前用 Ghidra 反编译,输出是汇编,得花多年训练才能看懂。现在你直接下指令,Agent 调 REA 驱动工具拆解,最后用大白话汇报逻辑、附上重构代码。作者已经拿 ​

三天,REA 在 GitHub 攒下近 8 万星。年初现象级项目 OpenClaw 同期才 6 万,Jev 前三天的 npm 下载量也就 3.5 万。 它补的是一层对话接口。以前用 Ghidra 反编译,输出是汇编,得花多年训练才能看懂。现在你直接下指令,Agent 调 REA 驱动工具拆解,最后用大白话汇报逻辑、附上重构代码。作者已经拿 ​

三天,REA 在 GitHub 攒下近 8 万星。年初现象级项目 OpenClaw 同期才 6 万,Jev 前三天的 npm 下载量也就 3.5 万。 它补的是一层对话接口。以前用 Ghidra 反编译,输出是汇编,得花多年训练才能看懂。现在你直接下指令,Agent 调 REA 驱动工具拆解,最后用大白话汇报逻辑、附上重构代码。作者已经拿 ​
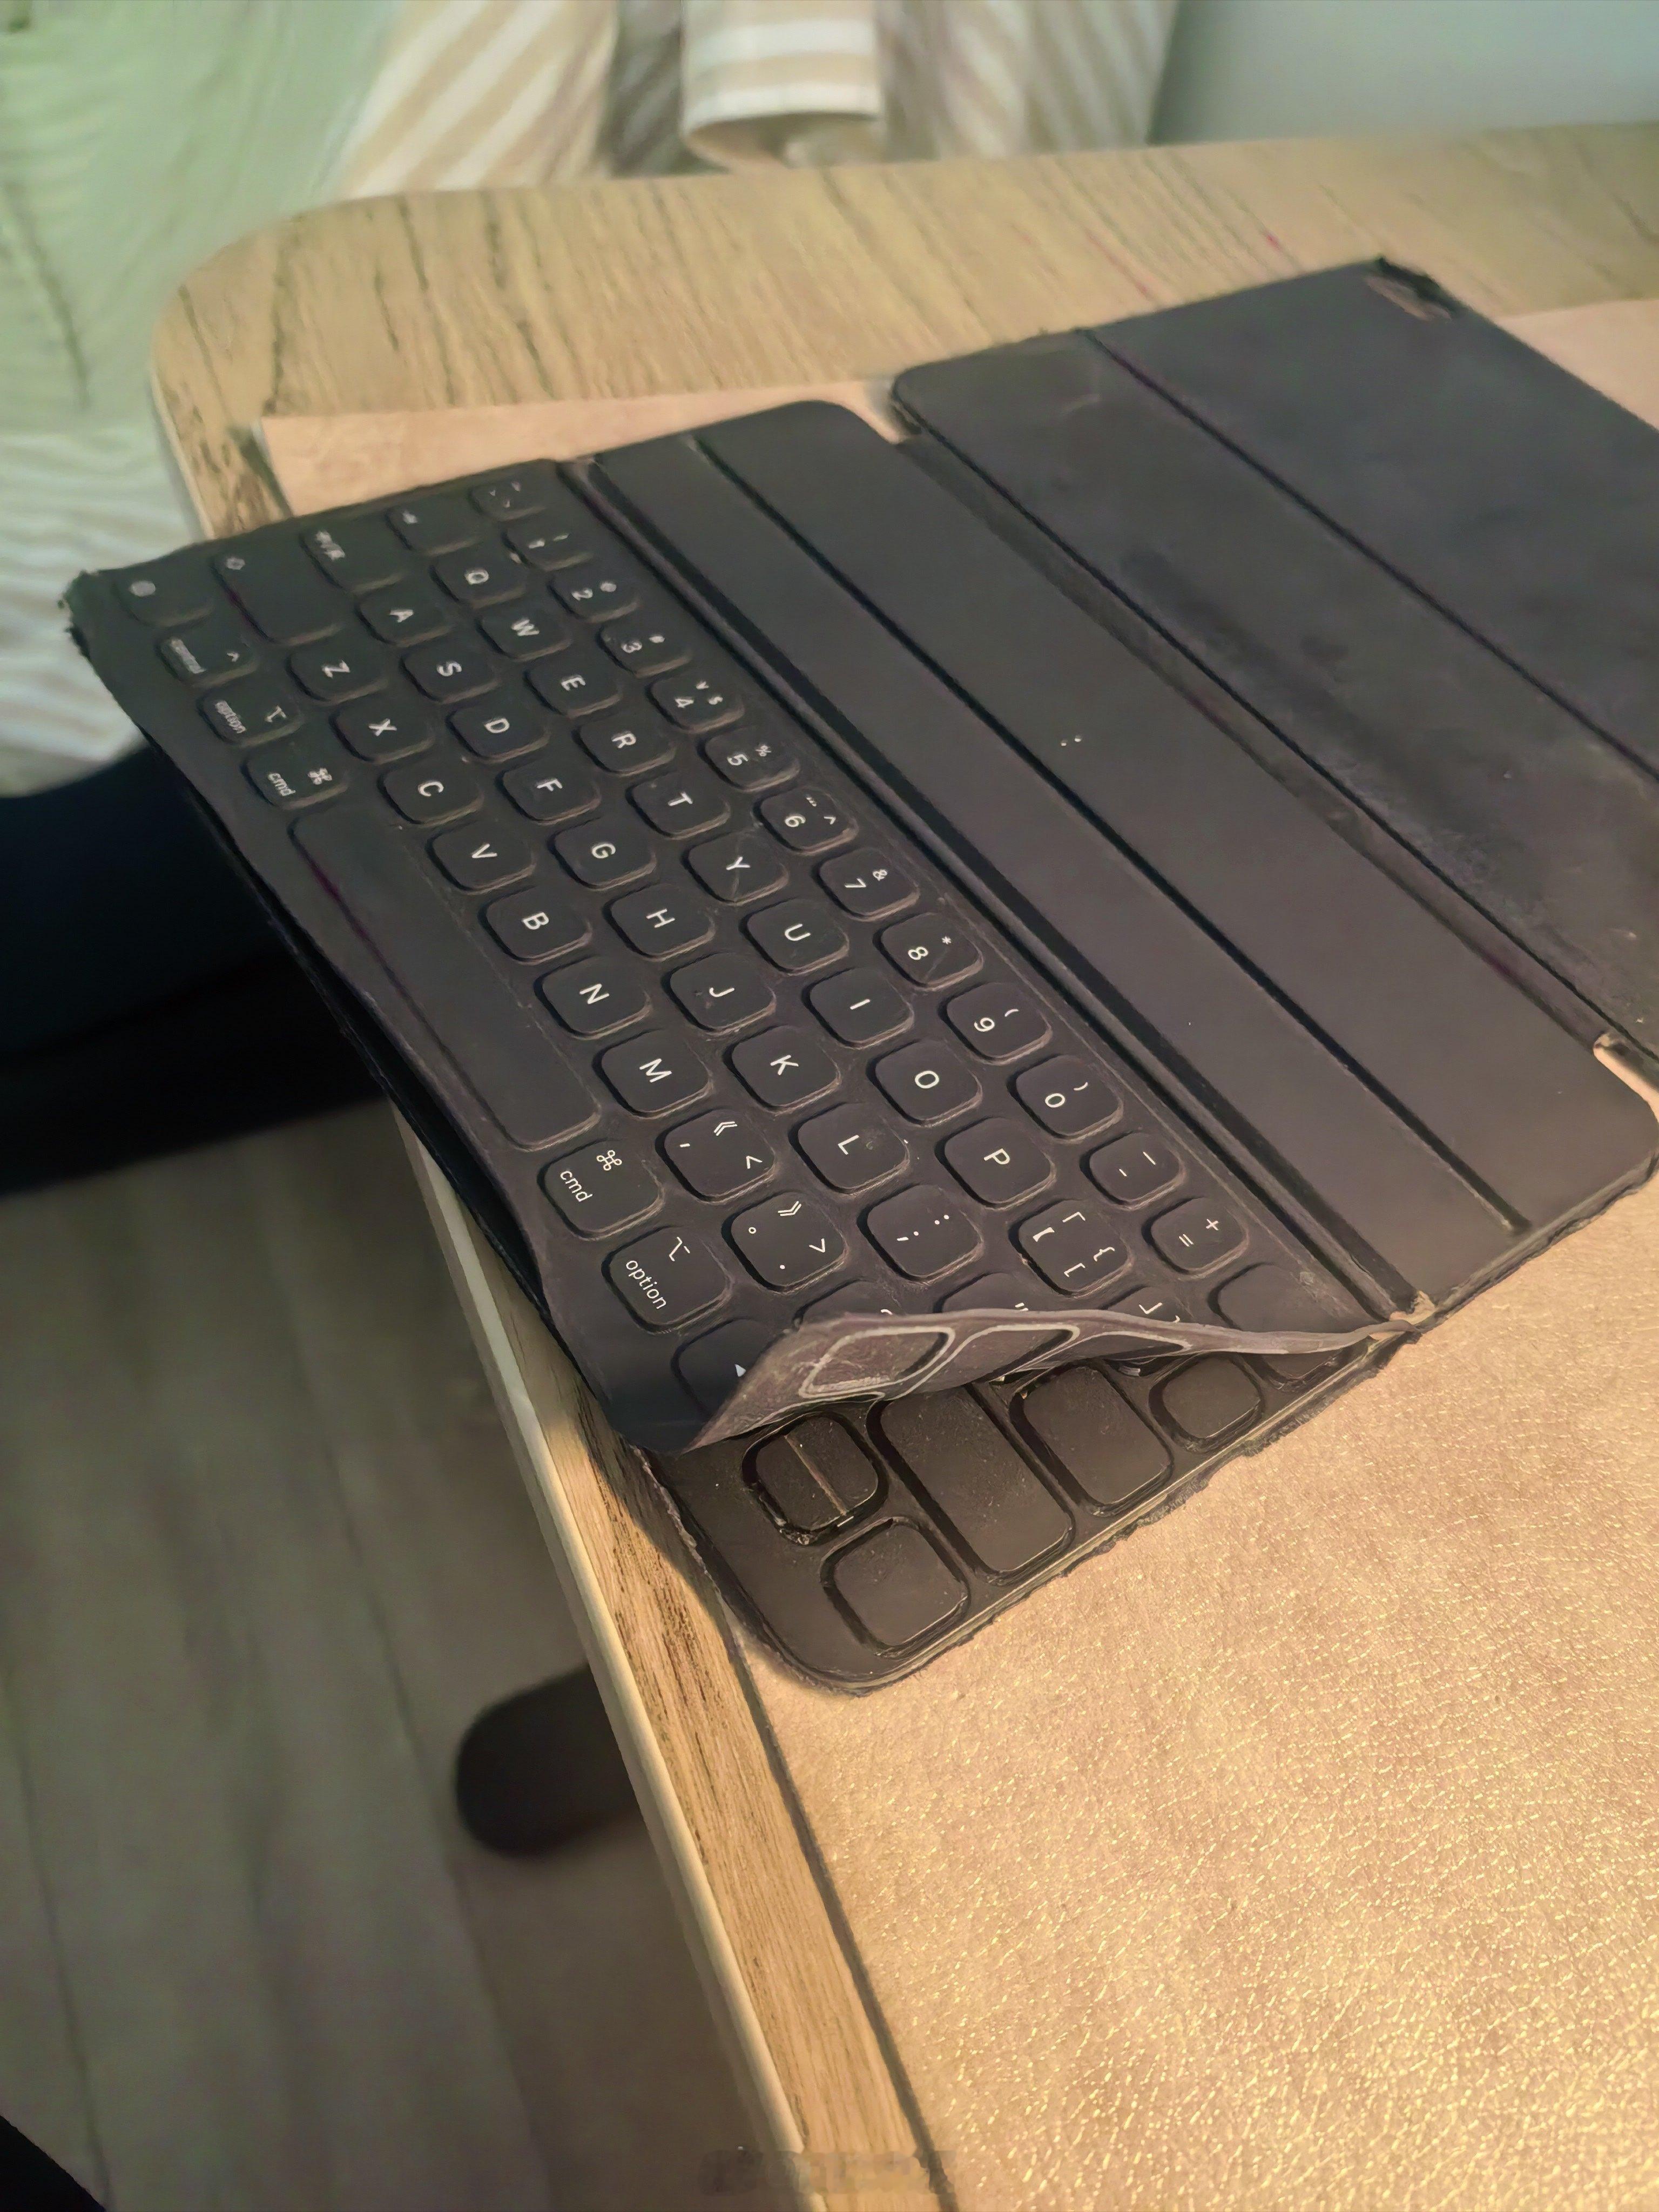
皮估计算可是iPad的重度用户 从还不认字就开始各种划拉 也十多年的用户体验了 从最开始的iPad2 到iPad Pro 10.5 到现在的c口Air 5 中间还有一段mini4当kindle用 练习手眼配合 认字认图识颜色 到后来看视频课玩游戏 现在主要是微信和deepseek 偶尔还有 pages xmind powerpoint classin 键盘用得实在是烂 ​

皮估计算可是iPad的重度用户 从还不认字就开始各种划拉 也十多年的用户体验了 从最开始的iPad2 到iPad Pro 10.5 到现在的c口Air 5 中间还有一段mini4当kindle用 练习手眼配合 认字认图识颜色 到后来看视频课玩游戏 现在主要是微信和deepseek 偶尔还有 pages xmind powerpoint classin 键盘用得实在是烂 ​

皮估计算可是iPad的重度用户 从还不认字就开始各种划拉 也十多年的用户体验了 从最开始的iPad2 到iPad Pro 10.5 到现在的c口Air 5 中间还有一段mini4当kindle用 练习手眼配合 认字认图识颜色 到后来看视频课玩游戏 现在主要是微信和deepseek 偶尔还有 pages xmind powerpoint classin 键盘用得实在是烂 ​
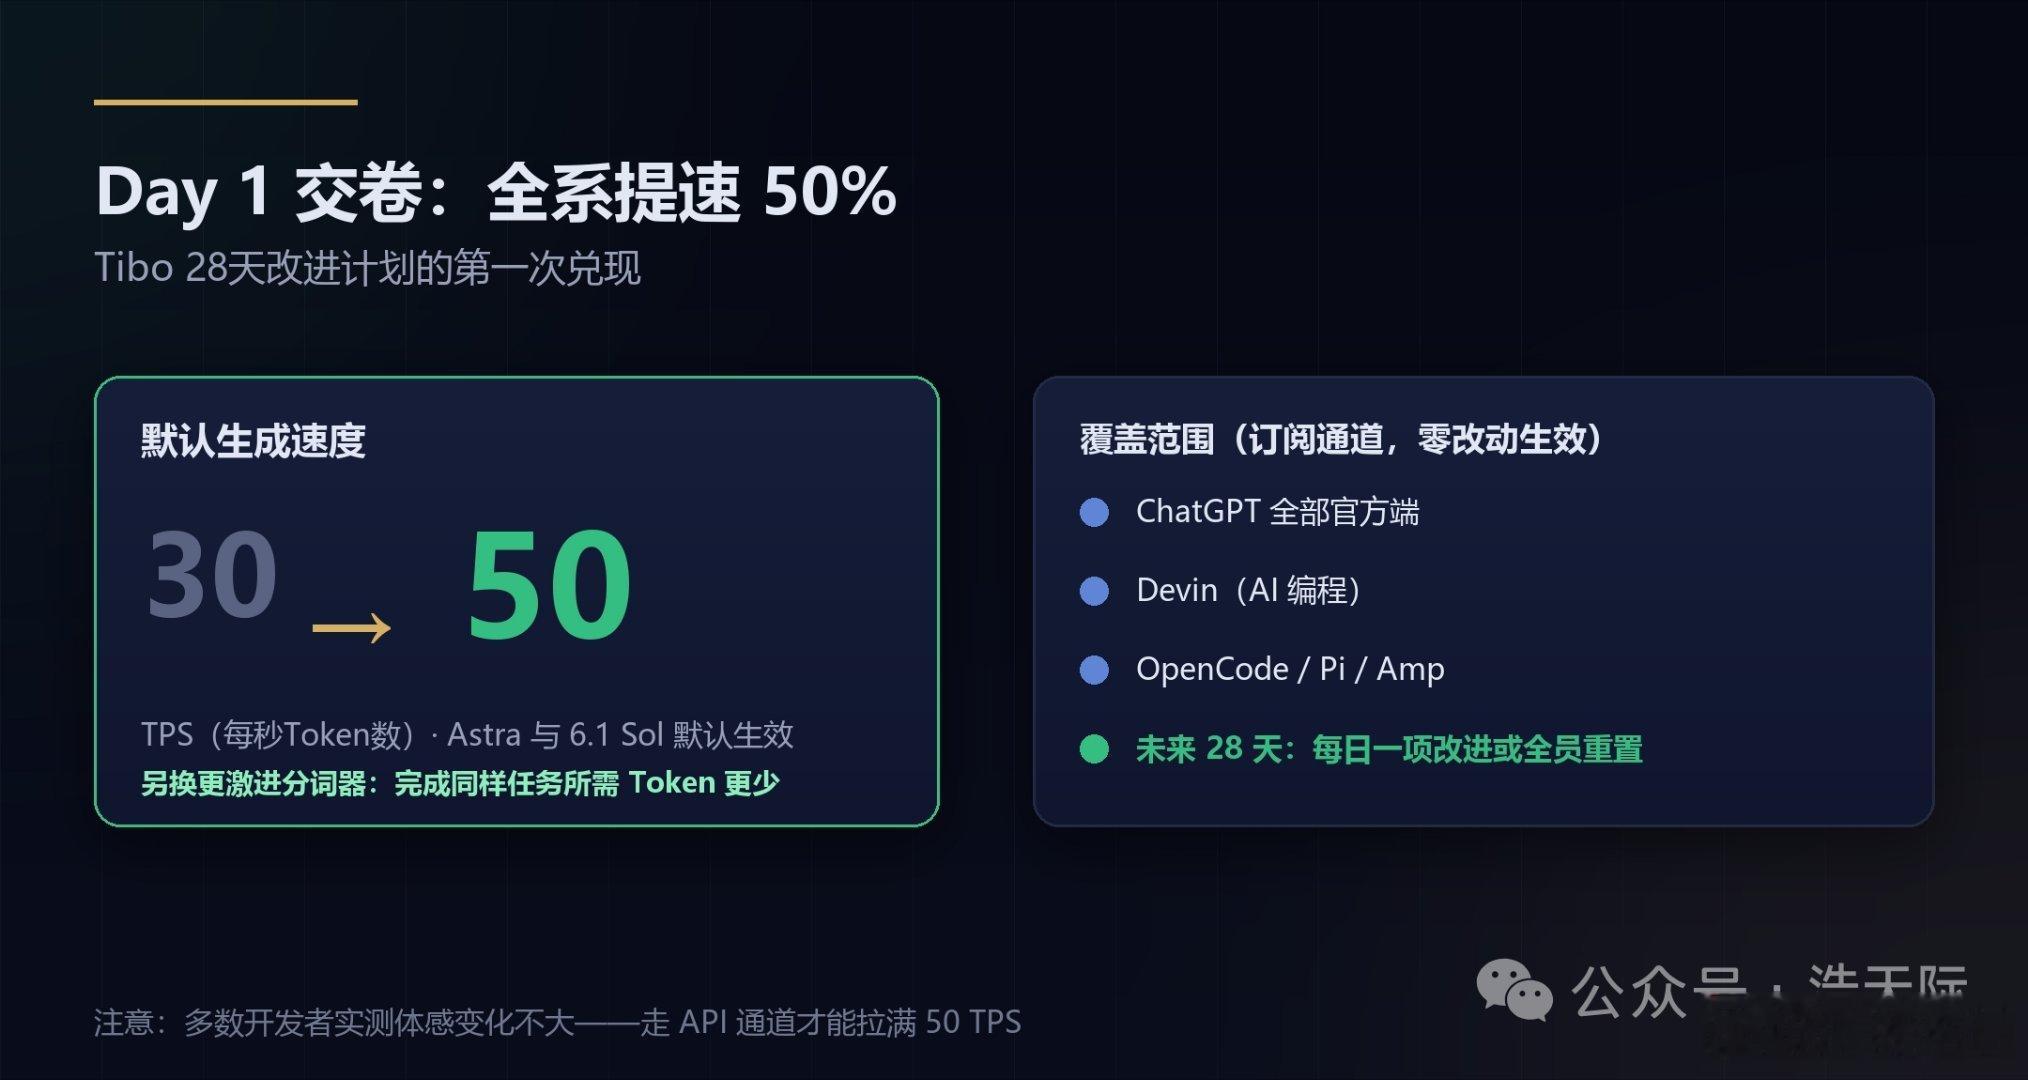
ChatGPT全系提速50%,但重度用户还是觉得Claude更值。

提速其实打了折扣:表面看生成速度涨了。底层换了分词器,同样任务耗的token更少。但多数人感觉没快多少。因为API通道确实拉满了,订阅通道还得排队。

Claude的订阅价值是它的5倍多:研究机构实测发现,200美元档的Claude,等效API价值约1.17万 ​

ChatGPT全系提速50%,但重度用户还是觉得Claude更值。 提速其实打了折扣:表面看生成速度涨了。底层换了分词器,同样任务耗的token更少。但多数人感觉没快多少。因为API通道确实拉满了,订阅通道还得排队。 Claude的订阅价值是它的5倍多:研究机构实测发现,200美元档的Claude,等效API价值约1.17万 ​

ChatGPT全系提速50%,但重度用户还是觉得Claude更值。 提速其实打了折扣:表面看生成速度涨了。底层换了分词器,同样任务耗的token更少。但多数人感觉没快多少。因为API通道确实拉满了,订阅通道还得排队。 Claude的订阅价值是它的5倍多:研究机构实测发现,200美元档的Claude,等效API价值约1.17万 ​

美国人一边让马斯克去死,一边疯狂的喜欢着他的制造的产品。#素材##凳子齐素材#​

美国人一边让马斯克去死,一边疯狂的喜欢着他的制造的产品。#素材##凳子齐素材#​
GPT-6 Astra用6小时破解了拿破仑密信,真正厉害的不是算力,而是它把跨学科的成本打下来了。

1809年拿破仑写给马尔蒙元帅的战报,217年来没人能读懂。唯一线索是一张极模糊的黑白复印图,平均每个符号只有19个像素。

AI是怎么破案的?
一个没碰过密码学的工程师把图丢给AI,分五步搞定:
视觉转录: ​

GPT-6 Astra用6小时破解了拿破仑密信,真正厉害的不是算力,而是它把跨学科的成本打下来了。 1809年拿破仑写给马尔蒙元帅的战报,217年来没人能读懂。唯一线索是一张极模糊的黑白复印图,平均每个符号只有19个像素。 AI是怎么破案的? 一个没碰过密码学的工程师把图丢给AI,分五步搞定: 视觉转录: ​

GPT-6 Astra用6小时破解了拿破仑密信,真正厉害的不是算力,而是它把跨学科的成本打下来了。 1809年拿破仑写给马尔蒙元帅的战报,217年来没人能读懂。唯一线索是一张极模糊的黑白复印图,平均每个符号只有19个像素。 AI是怎么破案的? 一个没碰过密码学的工程师把图丢给AI,分五步搞定: 视觉转录: ​
GPT-6.1 Sol突袭上线:1/5价格的「干活特化OpenAI悄悄上线了GPT-6.1 Sol,主打一个“便宜又耐造”。

价格直接砍到五分之一:输入每百万词2美元,输出10美元。最狠的是缓存读取只要0.1美元,比标准输入低了95%。这招明显是冲着批量干活去的。

智能没落下:它离最强的Astra只差1分。在代码和自动化测试 ​

GPT-6.1 Sol突袭上线:1/5价格的「干活特化OpenAI悄悄上线了GPT-6.1 Sol,主打一个“便宜又耐造”。 价格直接砍到五分之一:输入每百万词2美元,输出10美元。最狠的是缓存读取只要0.1美元,比标准输入低了95%。这招明显是冲着批量干活去的。 智能没落下:它离最强的Astra只差1分。在代码和自动化测试 ​

GPT-6.1 Sol突袭上线:1/5价格的「干活特化OpenAI悄悄上线了GPT-6.1 Sol,主打一个“便宜又耐造”。 价格直接砍到五分之一:输入每百万词2美元,输出10美元。最狠的是缓存读取只要0.1美元,比标准输入低了95%。这招明显是冲着批量干活去的。 智能没落下:它离最强的Astra只差1分。在代码和自动化测试 ​
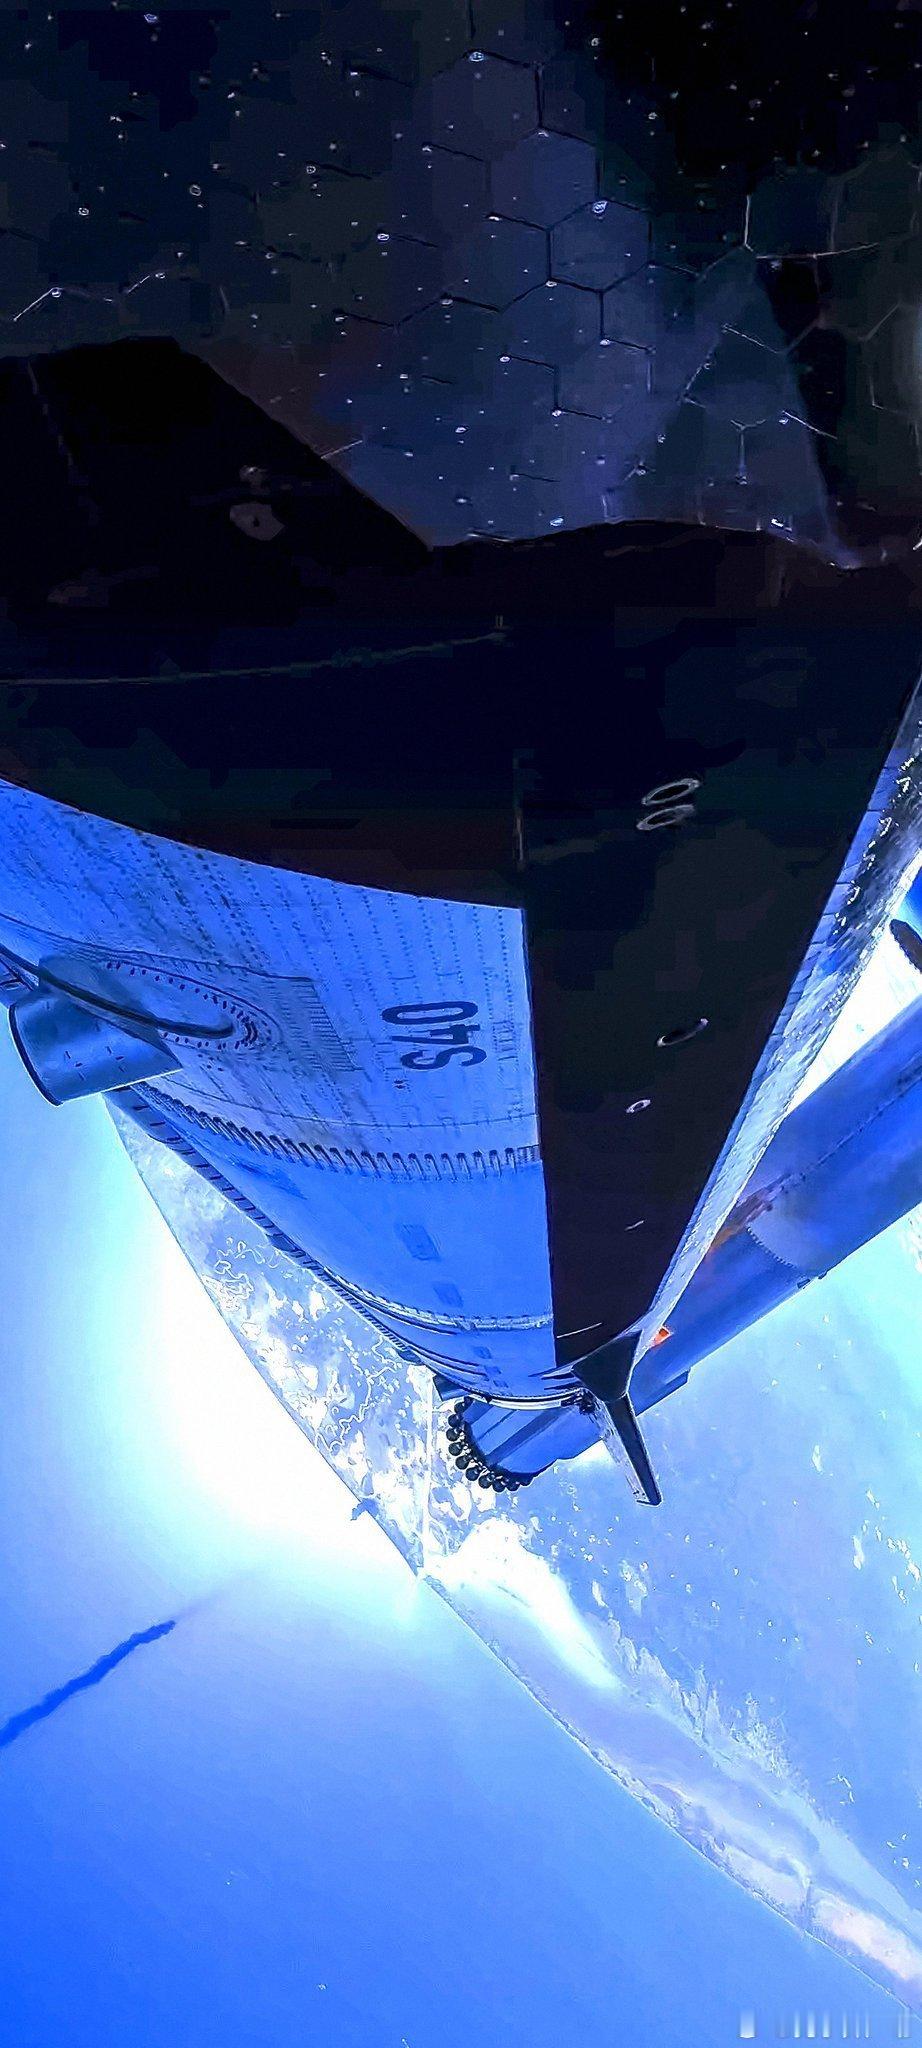
AMAZING 一颗赛艇 

#星舰成功入轨##素材##凳子齐##凳子齐素材# ​

AMAZING 一颗赛艇 #星舰成功入轨##素材##凳子齐##凳子齐素材# ​

AMAZING 一颗赛艇 #星舰成功入轨##素材##凳子齐##凳子齐素材# ​
Sonnet 5.5偷跑实锤:同价位性能压制Sol,Anthropic 疑似偷跑 Sonnet 5.5,性能强还便宜。

开发者在代码里扒出了新模型标识。实测它比刚出的 GPT-6 Sol 猛得多。

产出量直接碾压:同提示词跑测试,Sonnet 5.5 的代码产出是 Sol 的四倍多。它不仅写得多,还一直跑到 90 分钟上限才停。有老用户感慨, ​

Sonnet 5.5偷跑实锤:同价位性能压制Sol,Anthropic 疑似偷跑 Sonnet 5.5,性能强还便宜。 开发者在代码里扒出了新模型标识。实测它比刚出的 GPT-6 Sol 猛得多。 产出量直接碾压:同提示词跑测试,Sonnet 5.5 的代码产出是 Sol 的四倍多。它不仅写得多,还一直跑到 90 分钟上限才停。有老用户感慨, ​

Sonnet 5.5偷跑实锤:同价位性能压制Sol,Anthropic 疑似偷跑 Sonnet 5.5,性能强还便宜。 开发者在代码里扒出了新模型标识。实测它比刚出的 GPT-6 Sol 猛得多。 产出量直接碾压:同提示词跑测试,Sonnet 5.5 的代码产出是 Sol 的四倍多。它不仅写得多,还一直跑到 90 分钟上限才停。有老用户感慨, ​
OpenAI神秘「o」曝光:24小时在线的AI员工OpenAI 曝光了新 AI“o”:一个能替你干活的员工。

开发者从代码里扒出了它的底牌。它主打四个杀手锏:

后台一直跑:任务丢上去,它能连轴转几小时甚至几周。报错了自己改,不用你盯着。
干活贼快:多轮操作压到毫秒级,处理速度翻好几倍。
AI 自己组队:拆 ​

OpenAI神秘「o」曝光:24小时在线的AI员工OpenAI 曝光了新 AI“o”:一个能替你干活的员工。 开发者从代码里扒出了它的底牌。它主打四个杀手锏: 后台一直跑:任务丢上去,它能连轴转几小时甚至几周。报错了自己改,不用你盯着。 干活贼快:多轮操作压到毫秒级,处理速度翻好几倍。 AI 自己组队:拆 ​

OpenAI神秘「o」曝光:24小时在线的AI员工OpenAI 曝光了新 AI“o”:一个能替你干活的员工。 开发者从代码里扒出了它的底牌。它主打四个杀手锏: 后台一直跑:任务丢上去,它能连轴转几小时甚至几周。报错了自己改,不用你盯着。 干活贼快:多轮操作压到毫秒级,处理速度翻好几倍。 AI 自己组队:拆 ​
ChatGPT Pro Max曝光:月费500美元,买的是OpenAI 曝光了 ChatGPT Pro Max,月费高达 500 美元。

买的是算力插队权:它不增加使用量,只保证复杂任务跑得最快。重度用户最看重低延迟,这直接等于利润。

涨价是因为算力告急:新模型太吃算力,200 美元档成了重度用户的自助餐。平台扛不住亏损,干脆停 ​

ChatGPT Pro Max曝光:月费500美元,买的是OpenAI 曝光了 ChatGPT Pro Max,月费高达 500 美元。 买的是算力插队权:它不增加使用量,只保证复杂任务跑得最快。重度用户最看重低延迟,这直接等于利润。 涨价是因为算力告急:新模型太吃算力,200 美元档成了重度用户的自助餐。平台扛不住亏损,干脆停 ​

ChatGPT Pro Max曝光:月费500美元,买的是OpenAI 曝光了 ChatGPT Pro Max,月费高达 500 美元。 买的是算力插队权:它不增加使用量,只保证复杂任务跑得最快。重度用户最看重低延迟,这直接等于利润。 涨价是因为算力告急:新模型太吃算力,200 美元档成了重度用户的自助餐。平台扛不住亏损,干脆停 ​

#央视财经专访马斯克# fsd可以放行了吧。[不愧是你] ​

#央视财经专访马斯克# fsd可以放行了吧。[不愧是你] ​
马斯克喊出「全球第三」,我把账单放大三倍
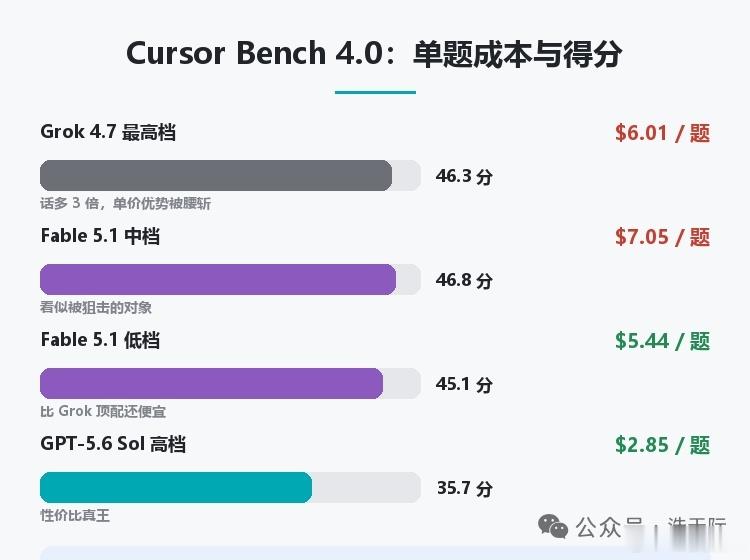
马斯克的 Grok 4.7 确实变强了,但“全球第三”的水分挺大。

跑分滤镜厚:综合智能指数只涨了2分。编程能排第三,全靠套了自家框架。换到中立榜单直接跌到第24名。

便宜是假象:单价看着只有竞品的零头。但它废话太多,输出长度是别人的三倍。算上废话,总 ​

马斯克喊出「全球第三」,我把账单放大三倍 马斯克的 Grok 4.7 确实变强了,但“全球第三”的水分挺大。 跑分滤镜厚:综合智能指数只涨了2分。编程能排第三,全靠套了自家框架。换到中立榜单直接跌到第24名。 便宜是假象:单价看着只有竞品的零头。但它废话太多,输出长度是别人的三倍。算上废话,总 ​

马斯克喊出「全球第三」,我把账单放大三倍 马斯克的 Grok 4.7 确实变强了,但“全球第三”的水分挺大。 跑分滤镜厚:综合智能指数只涨了2分。编程能排第三,全靠套了自家框架。换到中立榜单直接跌到第24名。 便宜是假象:单价看着只有竞品的零头。但它废话太多,输出长度是别人的三倍。算上废话,总 ​
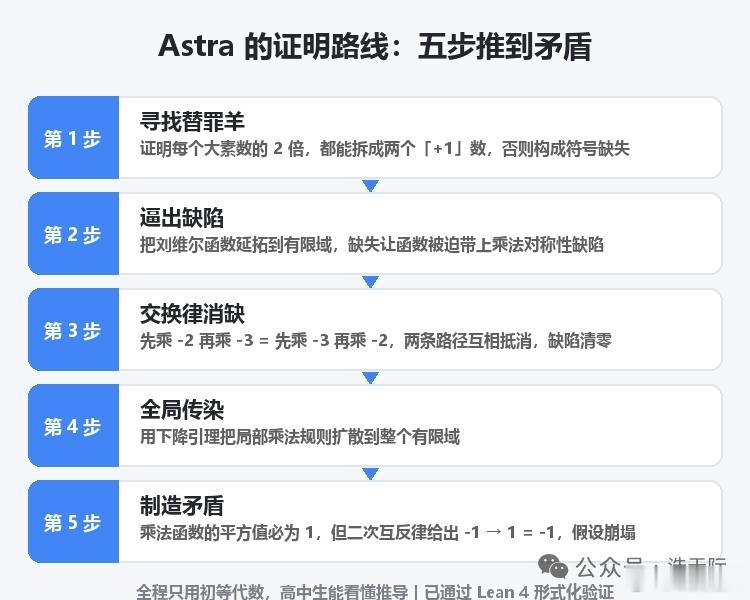
GPT-6 刚把哥德巴赫猜想的“替身版”证完了。

这篇两页纸的证明,已经通过了机器验证。逻辑上绝对没漏洞。

先说这个“替身”是怎么回事。
哥德巴赫猜想说:大偶数能拆成两个素数相加。
这问题悬了 284 年,太难啃。
数学家干脆换个思路,搞了个弱化版:
只要拆出来的两个数,“质因子个数是奇数”就 ​

GPT-6 刚把哥德巴赫猜想的“替身版”证完了。 这篇两页纸的证明,已经通过了机器验证。逻辑上绝对没漏洞。 先说这个“替身”是怎么回事。 哥德巴赫猜想说:大偶数能拆成两个素数相加。 这问题悬了 284 年,太难啃。 数学家干脆换个思路,搞了个弱化版: 只要拆出来的两个数,“质因子个数是奇数”就 ​

GPT-6 刚把哥德巴赫猜想的“替身版”证完了。 这篇两页纸的证明,已经通过了机器验证。逻辑上绝对没漏洞。 先说这个“替身”是怎么回事。 哥德巴赫猜想说:大偶数能拆成两个素数相加。 这问题悬了 284 年,太难啃。 数学家干脆换个思路,搞了个弱化版: 只要拆出来的两个数,“质因子个数是奇数”就 ​
ChatGPT 核心发明人辞职,转头造了个“哑巴”AI。

这 AI 叫 Jev。它不聊天、不写文章,只干三件事:在选项里挑一个、打个分、给个概率。

为啥要把嘴缝上?

作者觉得 ChatGPT 走偏了。以前的模型光顾着讨好人类,编瞎话还特别自信。Jev 只在划定选项里分配概率,想编都编不出来。

快得离谱,便宜到 ​

ChatGPT 核心发明人辞职,转头造了个“哑巴”AI。 这 AI 叫 Jev。它不聊天、不写文章,只干三件事:在选项里挑一个、打个分、给个概率。 为啥要把嘴缝上? 作者觉得 ChatGPT 走偏了。以前的模型光顾着讨好人类,编瞎话还特别自信。Jev 只在划定选项里分配概率,想编都编不出来。 快得离谱,便宜到 ​

ChatGPT 核心发明人辞职,转头造了个“哑巴”AI。 这 AI 叫 Jev。它不聊天、不写文章,只干三件事:在选项里挑一个、打个分、给个概率。 为啥要把嘴缝上? 作者觉得 ChatGPT 走偏了。以前的模型光顾着讨好人类,编瞎话还特别自信。Jev 只在划定选项里分配概率,想编都编不出来。 快得离谱,便宜到 ​
这一晚太疯狂:Fable 5.2 曝光,Opus 5.2
Anthropic 这周悄悄灰测了两款新模型,AI圈直接炸了。

Fable 5.2:质量反超,代价是又慢又贵。
它已经在部分用户后台悄悄上线。实测里,它的高推理能力压过了目前榜首的 GPT-6 Astra。不过想让它深度思考,就得忍受更长的等待和更高的账单。

Opus 5.2:断层 ​

这一晚太疯狂:Fable 5.2 曝光,Opus 5.2 Anthropic 这周悄悄灰测了两款新模型,AI圈直接炸了。 Fable 5.2:质量反超,代价是又慢又贵。 它已经在部分用户后台悄悄上线。实测里,它的高推理能力压过了目前榜首的 GPT-6 Astra。不过想让它深度思考,就得忍受更长的等待和更高的账单。 Opus 5.2:断层 ​

这一晚太疯狂:Fable 5.2 曝光,Opus 5.2 Anthropic 这周悄悄灰测了两款新模型,AI圈直接炸了。 Fable 5.2:质量反超,代价是又慢又贵。 它已经在部分用户后台悄悄上线。实测里,它的高推理能力压过了目前榜首的 GPT-6 Astra。不过想让它深度思考,就得忍受更长的等待和更高的账单。 Opus 5.2:断层 ​
谷歌把底牌扔了:Gemini 4 Pro 穿马甲偷跑谷歌下一代旗舰 Gemini 4 Pro 疑似提前曝光,主打一个“又强又便宜”。

底牌偷跑:Arena 上冒出一个同名新模型。外界普遍判断,这就是跳票半年的 Gemini 4 Pro。

跑分价格双杀:泄露图显示,它在编码等测试里压过 GPT-6 Astra。价格更是杀手锏:输入百万词元 ​

谷歌把底牌扔了:Gemini 4 Pro 穿马甲偷跑谷歌下一代旗舰 Gemini 4 Pro 疑似提前曝光,主打一个“又强又便宜”。 底牌偷跑:Arena 上冒出一个同名新模型。外界普遍判断,这就是跳票半年的 Gemini 4 Pro。 跑分价格双杀:泄露图显示,它在编码等测试里压过 GPT-6 Astra。价格更是杀手锏:输入百万词元 ​

谷歌把底牌扔了:Gemini 4 Pro 穿马甲偷跑谷歌下一代旗舰 Gemini 4 Pro 疑似提前曝光,主打一个“又强又便宜”。 底牌偷跑:Arena 上冒出一个同名新模型。外界普遍判断,这就是跳票半年的 Gemini 4 Pro。 跑分价格双杀:泄露图显示,它在编码等测试里压过 GPT-6 Astra。价格更是杀手锏:输入百万词元 ​
Claude 把几个入口合并成了一个,以后只开一个窗口就行。

不用再纠结任务发给谁。以前问答、复杂任务和做设计得切不同工具。现在全塞进一个框,AI 自己判断该用啥能力。

最实用的是能后台干活。你出门前丢个需求,它能在后台主动追问、查资料。等你坐下,几十页报告和配套 PPT 已经写好了。而且两边 ​

Claude 把几个入口合并成了一个,以后只开一个窗口就行。 不用再纠结任务发给谁。以前问答、复杂任务和做设计得切不同工具。现在全塞进一个框,AI 自己判断该用啥能力。 最实用的是能后台干活。你出门前丢个需求,它能在后台主动追问、查资料。等你坐下,几十页报告和配套 PPT 已经写好了。而且两边 ​

Claude 把几个入口合并成了一个,以后只开一个窗口就行。 不用再纠结任务发给谁。以前问答、复杂任务和做设计得切不同工具。现在全塞进一个框,AI 自己判断该用啥能力。 最实用的是能后台干活。你出门前丢个需求,它能在后台主动追问、查资料。等你坐下,几十页报告和配套 PPT 已经写好了。而且两边 ​