AI 如何重塑软件开发的每个环节;为什么模型之外的工程体系(Harness)才是关键。本文也在讲同一个事情:如何让AI写的代码在线上更「可控」?
最近,Anthropic 官方博客发了一篇 《The AI-Native SDLC playbook》(AI 原生的软件开发生命周期实战手册),正好把这件事给回答了。作者是 Louis Claxton,讲的是 Anthropic 自家 Applied AI 团队天天在客户打交道的一些方法。
废话不多说,看看 Anthropic 如何用 AI 写出生产级代码。
一、这篇手册的观点与谷歌如出一辙:AI 正在重塑软件开发的每一个环节今天的编码瓶颈,不全在AI,更在「写代码」前后那些还在"按人的速度"转的环节。
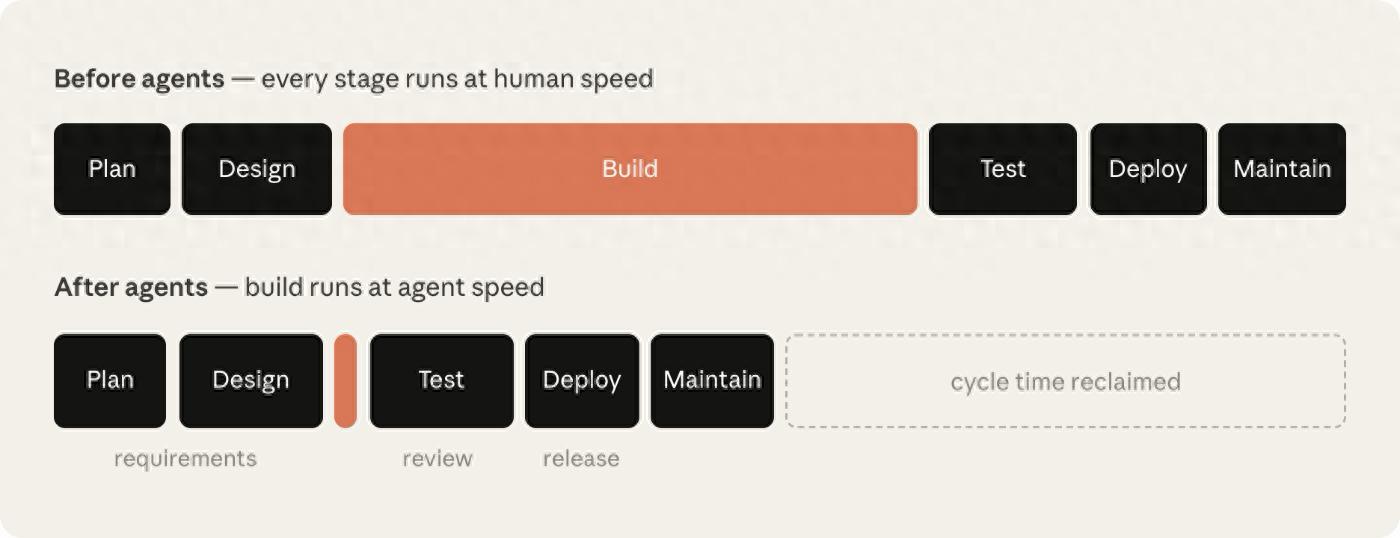
Anthropic给了对比:
传统 SDLC(软件开发生命周期,从想法到上线的全过程)是一套为"写代码最贵最慢"那个时代设计的流程。PRD、UI、需求评审、安全评审……这些繁文缛节,本质都是为了在长达数周的开发周期里"逼大家对齐"。
可一旦 AI 把构建阶段从几周压缩到几小时,问题就来了——写代码这一环已经飞快,可它前后那几环还是老流程、老速度,具体表现为:
瓶颈转移——写代码这一环快了,可它左侧的"规划"、右侧的"评审和部署"没快,还是人的速度,它们成了新瓶颈。审核失灵——人写的代码,一次就改那么几个文件,逐行审审得过来;现在 agent 一次改一大片文件,你还想逐行审,根本审不动了。代码审核成本上升——AI 吐出来的代码越多,需要审批、把关的地方就越多,可这些还在靠"一周才开一次"的评审会慢慢评,成本全堆上来了。官方示例图
plays-dependency-graph
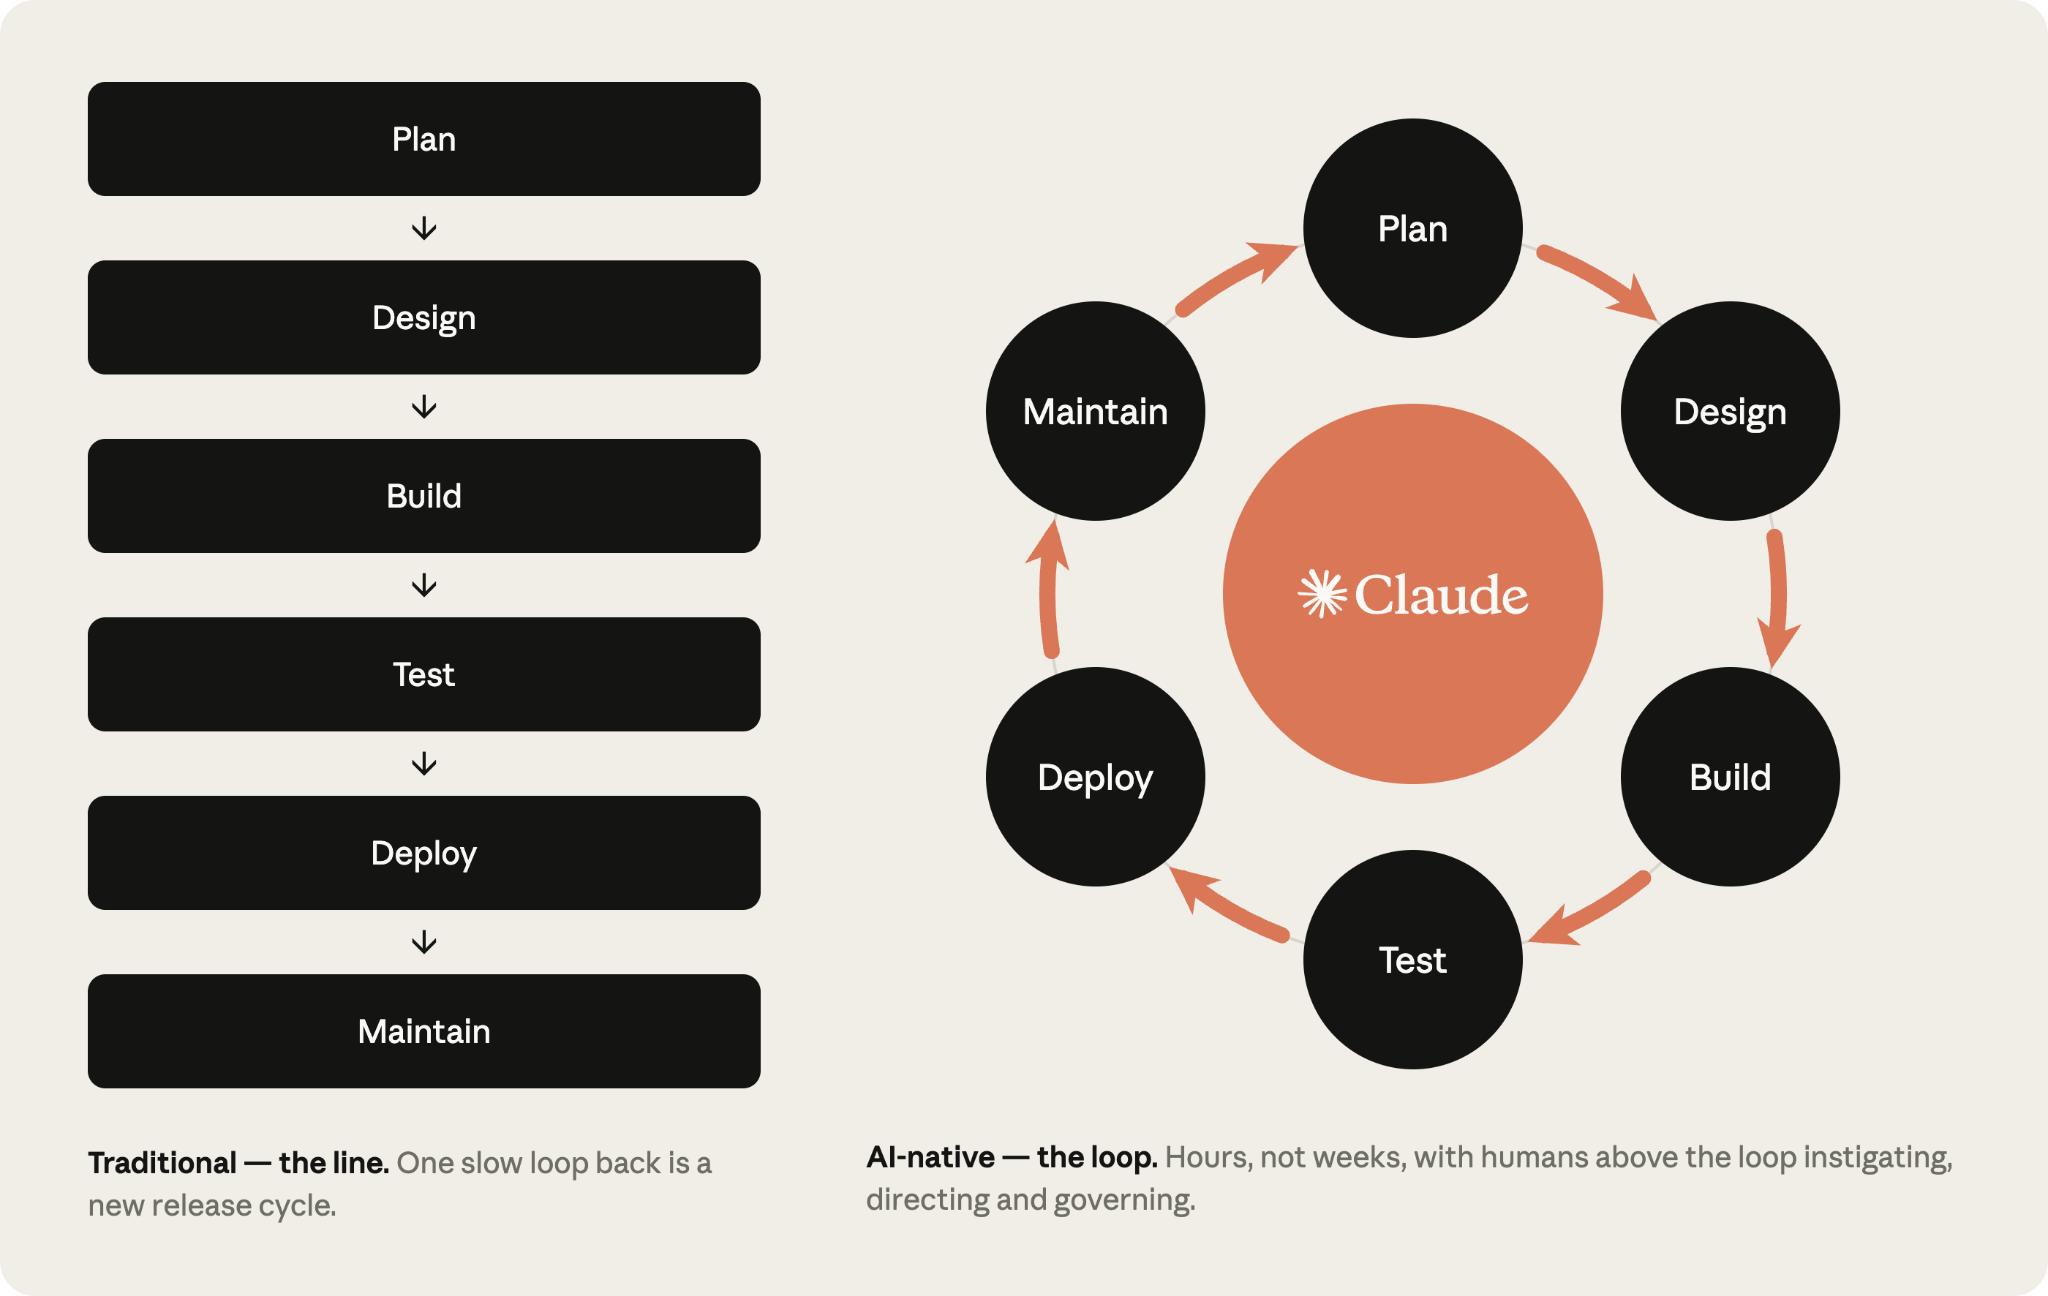
二、与传统 SDLC有什么区别?传统 SDLC 是直线:规划 → 设计 → 构建 → 测试 → 部署 → 维护,一个环节一个环节往下传,靠文档、工单、签字交接。
而AI Coding的出现不得不重构之前的路线和规则:
ai-native-sdlc-loop
这个循环里最核心的设计:
每个阶段都会有AI的参与;每个阶段都要提交一件「下一阶段能读」的产物。intent.md → 意图(要什么、为什么、约束是什么)
spec.md → 需求与设计规格
plan.md → 实施计划(改哪些文件、按什么顺序、怎么证明)
diff + 测试 → 代码和它的验证记录
PR + 评审 → 评审发现
缺陷记录 → 又写回成一份新的 intent.md注意没?最后一环又绕回了第一环。 生产环境出了事,agent 诊断完,把结论写成一份新的 intent.md,重新进入流程。这就是"闭环"。
作者管这条链路叫"审计轨迹"(audit trail):谁提的需求、agent 产出了什么、谁批准的,全在 git 提交链里,可查可审。
我把传统和 AI 原生这六个阶段的对决,整理成一张表,你一眼就能看懂差在哪:
阶段
传统 SDLC
AI 原生 SDLC
规划(Plan)
需求靠开会收集,人工写
Claude 从源头提炼痛点,写进
intent.md
设计(Design)
产品写需求,设计师再解读UI
需求+设计压缩成一次与 agent 的会话
构建(Build)
代码、测试、文档全靠手写
AI 生成代码和测试,知识写进
CLAUDE.md
和 skills
测试(Test)
代码靠工程师自检测试
贯穿全程的持续评估(evals)
部署(Deploy)
人逐行审代码,代码审查时有时无
多层 agent 评审,hooks 当审批关卡,人只审关键代码
维护(Maintain)
人盯着生产找 bug
agent 盯着,控制带一破就诊断并写回
intent.md
三、六个阶段的转变,一个一个说Anthropic 把它拆成了六个阶段:改变了什么、怎么开始、具体步骤、测试怎么做、怎么衡量是否奏效。下面是浓缩版。
阶段一:规划(Plan)——想法不再等人来"写需求"传统流程里,一个想法要先被记录,拆需求,想解决方案,挤破脑袋让接下来的人看懂。等传到工程师手里,已经和提出者的本意差了好几层。
AI 原生的做法特别朴素:让提出想法的人直接跟 Claude 聊,聊完把结果存成一份 intent.md。人可读、机器可执行、版本化。产品负责人只管评审和纠正,不用替人代笔。
下面是产品与理赔客户 聊完需求之后的产出的intent.md:
要做什么:理赔状态自助查询
作者:J. Ortiz(理赔运营)。状态:草稿。
问题
客户打电话到联络中心,问自己的理赔进展到哪了。
话务员约三分之一的话务时间都花在纯状态查询上。
拟议的结果
客户在门户里看到理赔状态、下一步、预计日期。
受影响的用户和系统
理赔话务员、门户团队、claims-core API。
约束
门户会话不新增 PII(个人身份信息)。只用现有认证。
待解决问题
第三方定损员是否也需要访问?写这份文件的人根本不懂代码,他只是在回答"想要什么、为什么、有什么限制"。而这些问题,恰恰是后面所有环节最需要的信息。记住 intent.md——它是整条链的起点,也是闭环的终点:线上问题的诊断,最后也写回成它。
阶段二:设计(Design)——需求和设计,一次会话搞定传统是需求、设计两个团队分开接力:产品团队先写一遍,设计团队再从头读一遍、重新理解,信息在来回交接里一点点损耗,又慢又容易走样。AI 原生里,产品负责人拿着 intent.md,让 Claude 一次性产出"需求+设计"的规格 spec.md;产出时,公司那套品牌规范、安全红线、合规要求、UX 标准,会提前注入给 Claude 当约束(做法是写成"skills"——给 Claude 读的规则文件,下一阶段细讲),同时让 Claude 把风险点标出来。
关键转变:这些规范在写 spec.md 的那一刻就注入进去了,而不是拖到几周后的评审里才被人翻出来。
阶段三:构建(Build)——先有计划,再动手这一步的手册里有一个我很想单独拎出来的点:默认从"计划模式"开始,而不是直接写代码。
工程师让 Claude 在计划模式里"面试"自己,比如现在非常火的mattpocock skill /grill-me。
产出一份 plan.md——要改哪些文件、按什么顺序、怎么证明它成立。计划没通过,Claude 连文件都不能改。 改方向的成本,从"改代码"转换为"改文档"。
接着上面那个"理赔自助查询"的例子,plan.md 长这样:
计划:理赔状态自助查询
要改的文件
- portal/src/claims/StatusPanel.tsx(新增)
- claims-api/routes/status.py
- claims-api/tests/test_status.py
工作顺序
1. 在现有认证之后加状态端点。
2. 让面板对接这个端点。
3. 接入门户导航。
风险
claims-core API 有 50 rps 限流;面板必须做缓存。
证明
test_status.py 覆盖四种理赔状态;截图与批准的稿子一致。看出来了吗——上一份文件说"要什么",这一份文件说"怎么改、有什么风险、怎么证明",一环扣一环。
而团队知识(约定、命令、架构、踩过的坑)则沉淀成两份东西:
CLAUDE.md——agent 每次会话开头必读的"新人入职手册"。手册给了一份"支付服务"的示例,最有味道的是最后一段: 支付服务
约定
- 金额一律用 BigDecimal,绝不用 double。
Claude 容易出错的地方
- 不要升级依赖版本;这是平台团队的事。
- 遗留的 v1/ 包已冻结;改动放在 v2/ 里。一句话原则就是:同一个错犯两次,就写进 CLAUDE.md——这就是团队里"老师傅的经验"变成文件的样子。
skills(技能)——把必须一致执行的制度,写成一个会触发的 SKILL.md。比如"安全 API 评审"这条制度,写成 skills 后是: 安全 API 评审
当你创建或修改 API 端点时:
1. 认证:每个端点都要求网关 JWT;/health 之外不允许匿名路由。
2. 输入校验:按 OpenAPI schema 校验请求体,拒绝未知字段。
3. 审计:每个改变状态的端点都发审计事件。
4. 数据分类:标记为 pii 的字段绝不出现在日志或错误消息里。这两样,本质上是把"存在人脑里、wiki 上"的知识,变成了"agent 读的文件"。
阶段四:测试(Test)——让 agent 自己检查自己的活核心一句话:永远给 Claude 一个验证自己的方式,让它把人看到之前,先修掉自己的错。
对修 bug 尤其狠的一招是:先让 Claude 把 bug 复现成一个失败测试,提交它;然后才让它改代码、且禁止它改测试文件。一个"修复前就存在、agent 又改不了"的测试,才是 bug 真正消失的证据。
更高一层是持续评估(evals):把 20~50 个真实任务做成回归套件,CLAUDE.md、skills、hooks 一改,套件就跑一遍,看 agent 是不是还能按老标准干活。驾驭 agent 的配置,本身也要像代码一样被回归测试。
阶段五:部署(Deploy)——agent 做到生产上线为止,一步都不越过去部署阶段的两个关键词:评审双向化、hooks 当关卡。
Claude 既评审别人的 PR(按 REVIEW.md 定义的政策跑 bug/安全/合规三关),也处理自己 PR 上的 @评论。人不再逐行看代码,只判断两件事:意图对不对、风险能不能接受。
而"治理"这件事,从"靠人盯着"变成了"代码强制执行"——hooks(钩子)能在 Claude 行动前允许、询问、阻止。手册直接给了一段真实的 hooks 脚本,就这么几行:
.claude/settings.json
{
"hooks": {
"PreToolUse": [
{
"matcher": "Bash",
"hooks": [
{ "type": "command",
"command": "${CLAUDE_PROJECT_DIR}/.claude/hooks/production-gate.sh" }
]
}
]
}
}.claude/hooks/production-gate.sh
!/bin/bash
生产部署需要指定的发版授权
cmd=$(jq -r '.tool_input.command' < /dev/stdin)
if [[ "$cmd" == *"deploy"* && "$cmd" == *"production"* ]]; then
if [ -z "$RELEASE_APPROVAL" ]; then
echo "生产部署需要发版授权。" >&2
exit 2 阻止该动作;消息传回 Claude
fi
fi
exit 0看懂了:只要命令里带着 deploy + production、而又没有发版授权,就一律拦下。 这不是"提醒",是硬卡。
手册里给受监管企业的那段"托管设置"示例更狠:一层层 deny、沙箱、凭证隔离、插件白名单……翻译成人话就是——既要让 AI 放手干,又要让它碰不到任何不该碰的东西,而且这些限制连工程师自己都关不掉。
阶段六:维护(Maintain)——闭环并且进入正循环,agent 值夜班前五个阶段,都还需要人先"启动"一步。第六阶段,把启动这一步也去掉了:
一个确定性的脚本盯着生产指标(比如 CI 失败率、部署后 5xx 率),设好控制带——1σ 只记日志,2σ 让 Claude 只读诊断,3σ 才允许它行动(但也只能是开 PR 或触发预先批准的 runbook)。这三级控制,就是一份不到十行的配置:
metric: ci_test_failure_rate
baseline: rolling_30d
rules: western_electric
tiers:
1sigma: { action: log }
2sigma: { action: diagnose,
tools: "Read,Grep,Bash(gh run view *)" }
3sigma: { action: propose,
routes: [pull_request, runbook:rollback-deploy] }看到 σ 别慌,一句话讲透:σ(sigma,读"西格玛")是"标准差",你可以把它当成"异常程度"的刻度——指标偏离平时正常水平越远,σ 就越高(配置里的 western_electric,就是一套判断"什么算异常"的统计规则)。于是这套"控制带"分三级:1σ 是"有点不对劲",只记个日志别烦人;2σ 是"明显出问题了",放 Claude 进来只读诊断;3σ 是"出大事了",才允许 Claude 动手——也只能开 PR,或跑一条预先批好的 runbook(应急预案)。
告警分级越细,人越敢放手。 控制带一旦被突破,Claude 被自动唤起,诊断、写 intent.md、重新进入流程——而且"检测"这一步从头到尾是纯确定性脚本,不掺一点模型,尽可能保证它稳。
配上一个 Claude Tag(当前在 Slack 公开 beta):让 Claude 以独立身份进你的缺陷清单。半夜 10 点一条"紧急问题",它先顶上。
四、最后,对比一下两篇文章Anthropic 的 六个阶段,其实就守着一个原则——围绕 AI Agent 重建软件开发流程,同时确保人始终在循环中:
Google 那篇白皮书说"根据任务的风险,决定给 AI 多少自由、加多少道把关";
Anthropic 这篇手册,就是手把手告诉你:把关最多、最严谨的那一套,具体长什么样、怎么一层层搭起来。
两篇放在一起,刚好是一对:
Google 告诉你:为什么 AI 时代的开发必须变,以及尺度该怎么拿捏。Anthropic 告诉你:最严谨的那套,具体怎么做、怎么一步步落地。