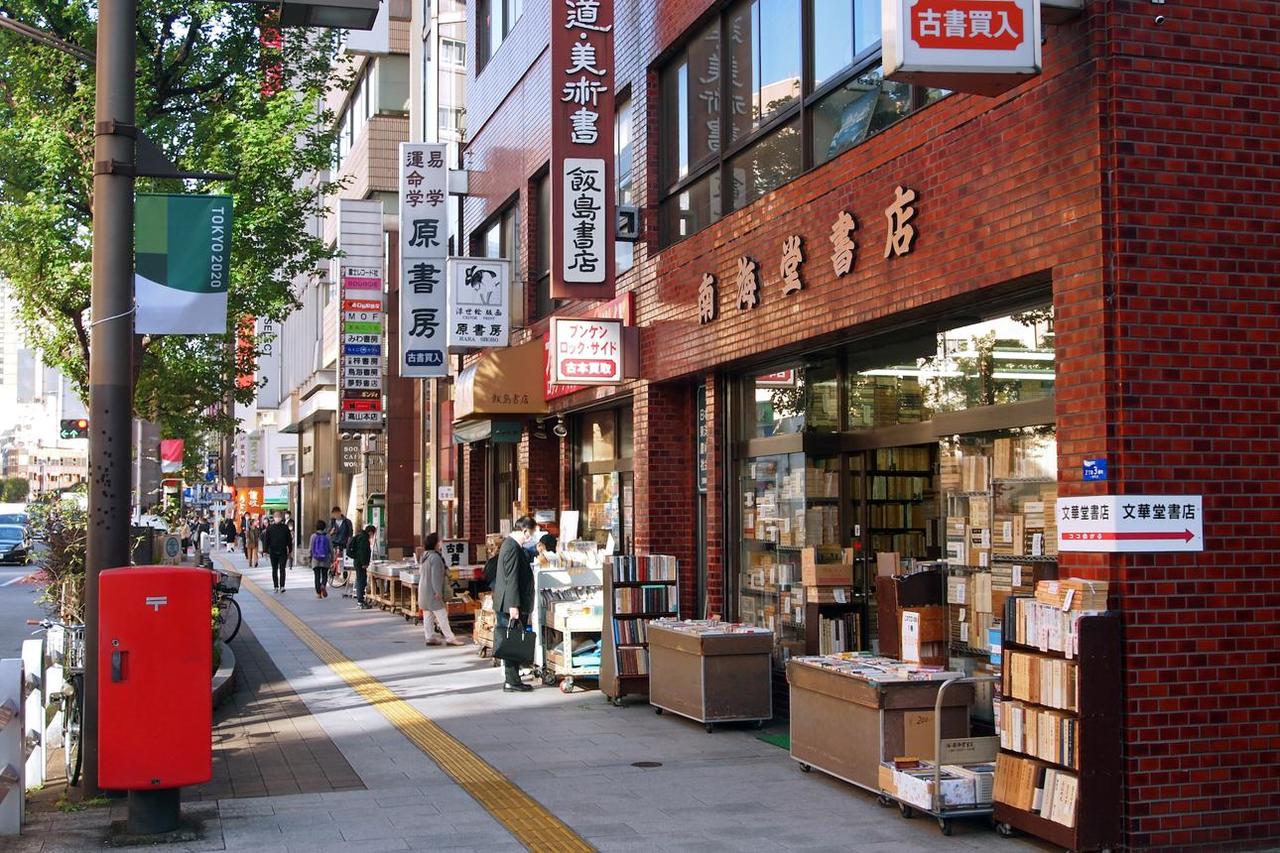
大模型终于露出了最原始的獠牙:它们开始吃纸了!你敢信吗?现在硅谷的AI巨头,已经不满足抓取互联网上的文字了,转头跑到全世界各地扫荡二手旧书。日本著名古书店街,大批神秘买家大批量扫货,不管是老地方志、旧判例集,还是几十年前的行业小册子,只要上面有字就全部买走,一年就有足足50吨旧书,打包运往美国,差不多是10万册纸质读物。这些买家根本不是藏书爱好者,这些书也不会被摆上书架阅读,它们的最终归宿,是被切掉书脊、拆开装订,完成高速扫描工序后实体书籍直接被销毁,提取出的文字内容作为大模型的训练素材,该事件被公开后不少人都觉得十分不可思议。不少人都感到很费解,线上的各类信息资源如此充足,AI为什么偏要耗费大量成本专门收购纸质旧书呢?最核心的缘由一共就两点:互联网上的高质量人类原创文字几乎快被搜刮殆尽,当下全网各处都遍布AI生成的低质内容。早些年大模型的快速发展,完全依托爬虫爬取全网资源,百科、论坛帖子、新闻、网友评论所有内容都被拿来做训练素材。但互联网当中现存的全部高质量人类创作文本,整体存量是存在明确上限的。据科研机构EpochAI的估算,以当前的消耗节奏来看,公开网络中的优质人类文本很快就会被耗尽,业内将这一困境称作“数据墙”。比数据短缺更让人忧虑的状况,是数据已经遭到了“污染”。如今互联网上存在大量营销文案、灌水内容,不少这类文章本身就是由AI生成的。曾有研究在《Nature》刊发相关结论,将AI产出内容用来继续训练AI,数轮迭代后,模型输出就会逻辑失序、内容离谱。业内叫“模型塌陷”,通俗讲就像复印件反复复印,越到后面画面越模糊,属于AI界的近亲繁殖,越训越笨。互联网上可获取的完全出自人类原创的纯净内容越来越少,行业巨头便将目光投向了尚未完成数字化的纸质老书籍。这些数十年前印刷的书籍,全都是人类思考沉淀下来的内容,完全没有AI相关内容污染,是品质极高的训练素材。这当中来自日本的旧书籍尤其受到大众欢迎。一方面近代日本印刷工艺水平出色,页面字迹清楚,机器识别文字的准确率非常高;可推进数字化的整个过程,其粗放的程度实在令人感慨。知名AI厂商Anthropic曾有代号为“巴拿马计划”的项目被披露,在采购了数百万册图书之后,并没有采用讲究的无损扫描方式。他们直接操作工业切纸机一刀切下书脊,整本书散开为独立单页,高速扫描仪快速完成扫描,OCR工具提取文字生成电子文档,完成扫描的实体书直接被回收销毁。由作者花费多年精力创作完成的书籍,仅用短短几十秒就失去了原有物理形态,留存下来的只有对应的数字文本内容。这其中也暗藏版权相关的考量,根据美国的部分司法判例,企业合法购买纸质图书,完成扫描后销毁原物,仅保留唯一的数字备份,往往会被判定为构成“合理使用”,躲开了直接下载盗版电子书籍的相关法律风险,可该操作在科技领域和藏书界都引发了极大争议。整件事后续还出现了一个颇具戏剧性的反转走向。很长一段时间里,大家都普遍认为,采用数字化手段搭配云端存储,就是留存知识的最优方案。人们将书籍扫描生成PDF文件,把各类笔记上传至云端,都认为硬盘存储要比实体纸张更可靠。可现实却来了一次轮回:在数字世界充斥AI垃圾内容的今天,那些落满灰尘、安放在书架上的纸质书,反而成了没有被AI触碰过的知识净土。高科技企业拼技术、拼算力,现在还要比拼谁能拿到更多没有被污染的旧书。日后当我们和AI对话交流时,它输出的某一段知识内容,很有可能就来自某本被切碎销毁的昭和年代旧书。大家完全无需过度焦虑,这种情况并不意味着纸质书马上就会被抢购一空。批量采购的大多是流通量大的二手旧书,珍贵孤本、善本并不会大规模流入这个流水线。只是这件事值得我们思考:当大量人类知识被AI拿走消化,实体书本不复存在之后,人类对这些内容的解释权,会不会悄悄发生变化。现在我们家里书架上那些旧书,只要书本还完好地摆在那里,这份知识的解释权,就还牢牢握在我们人类手里。