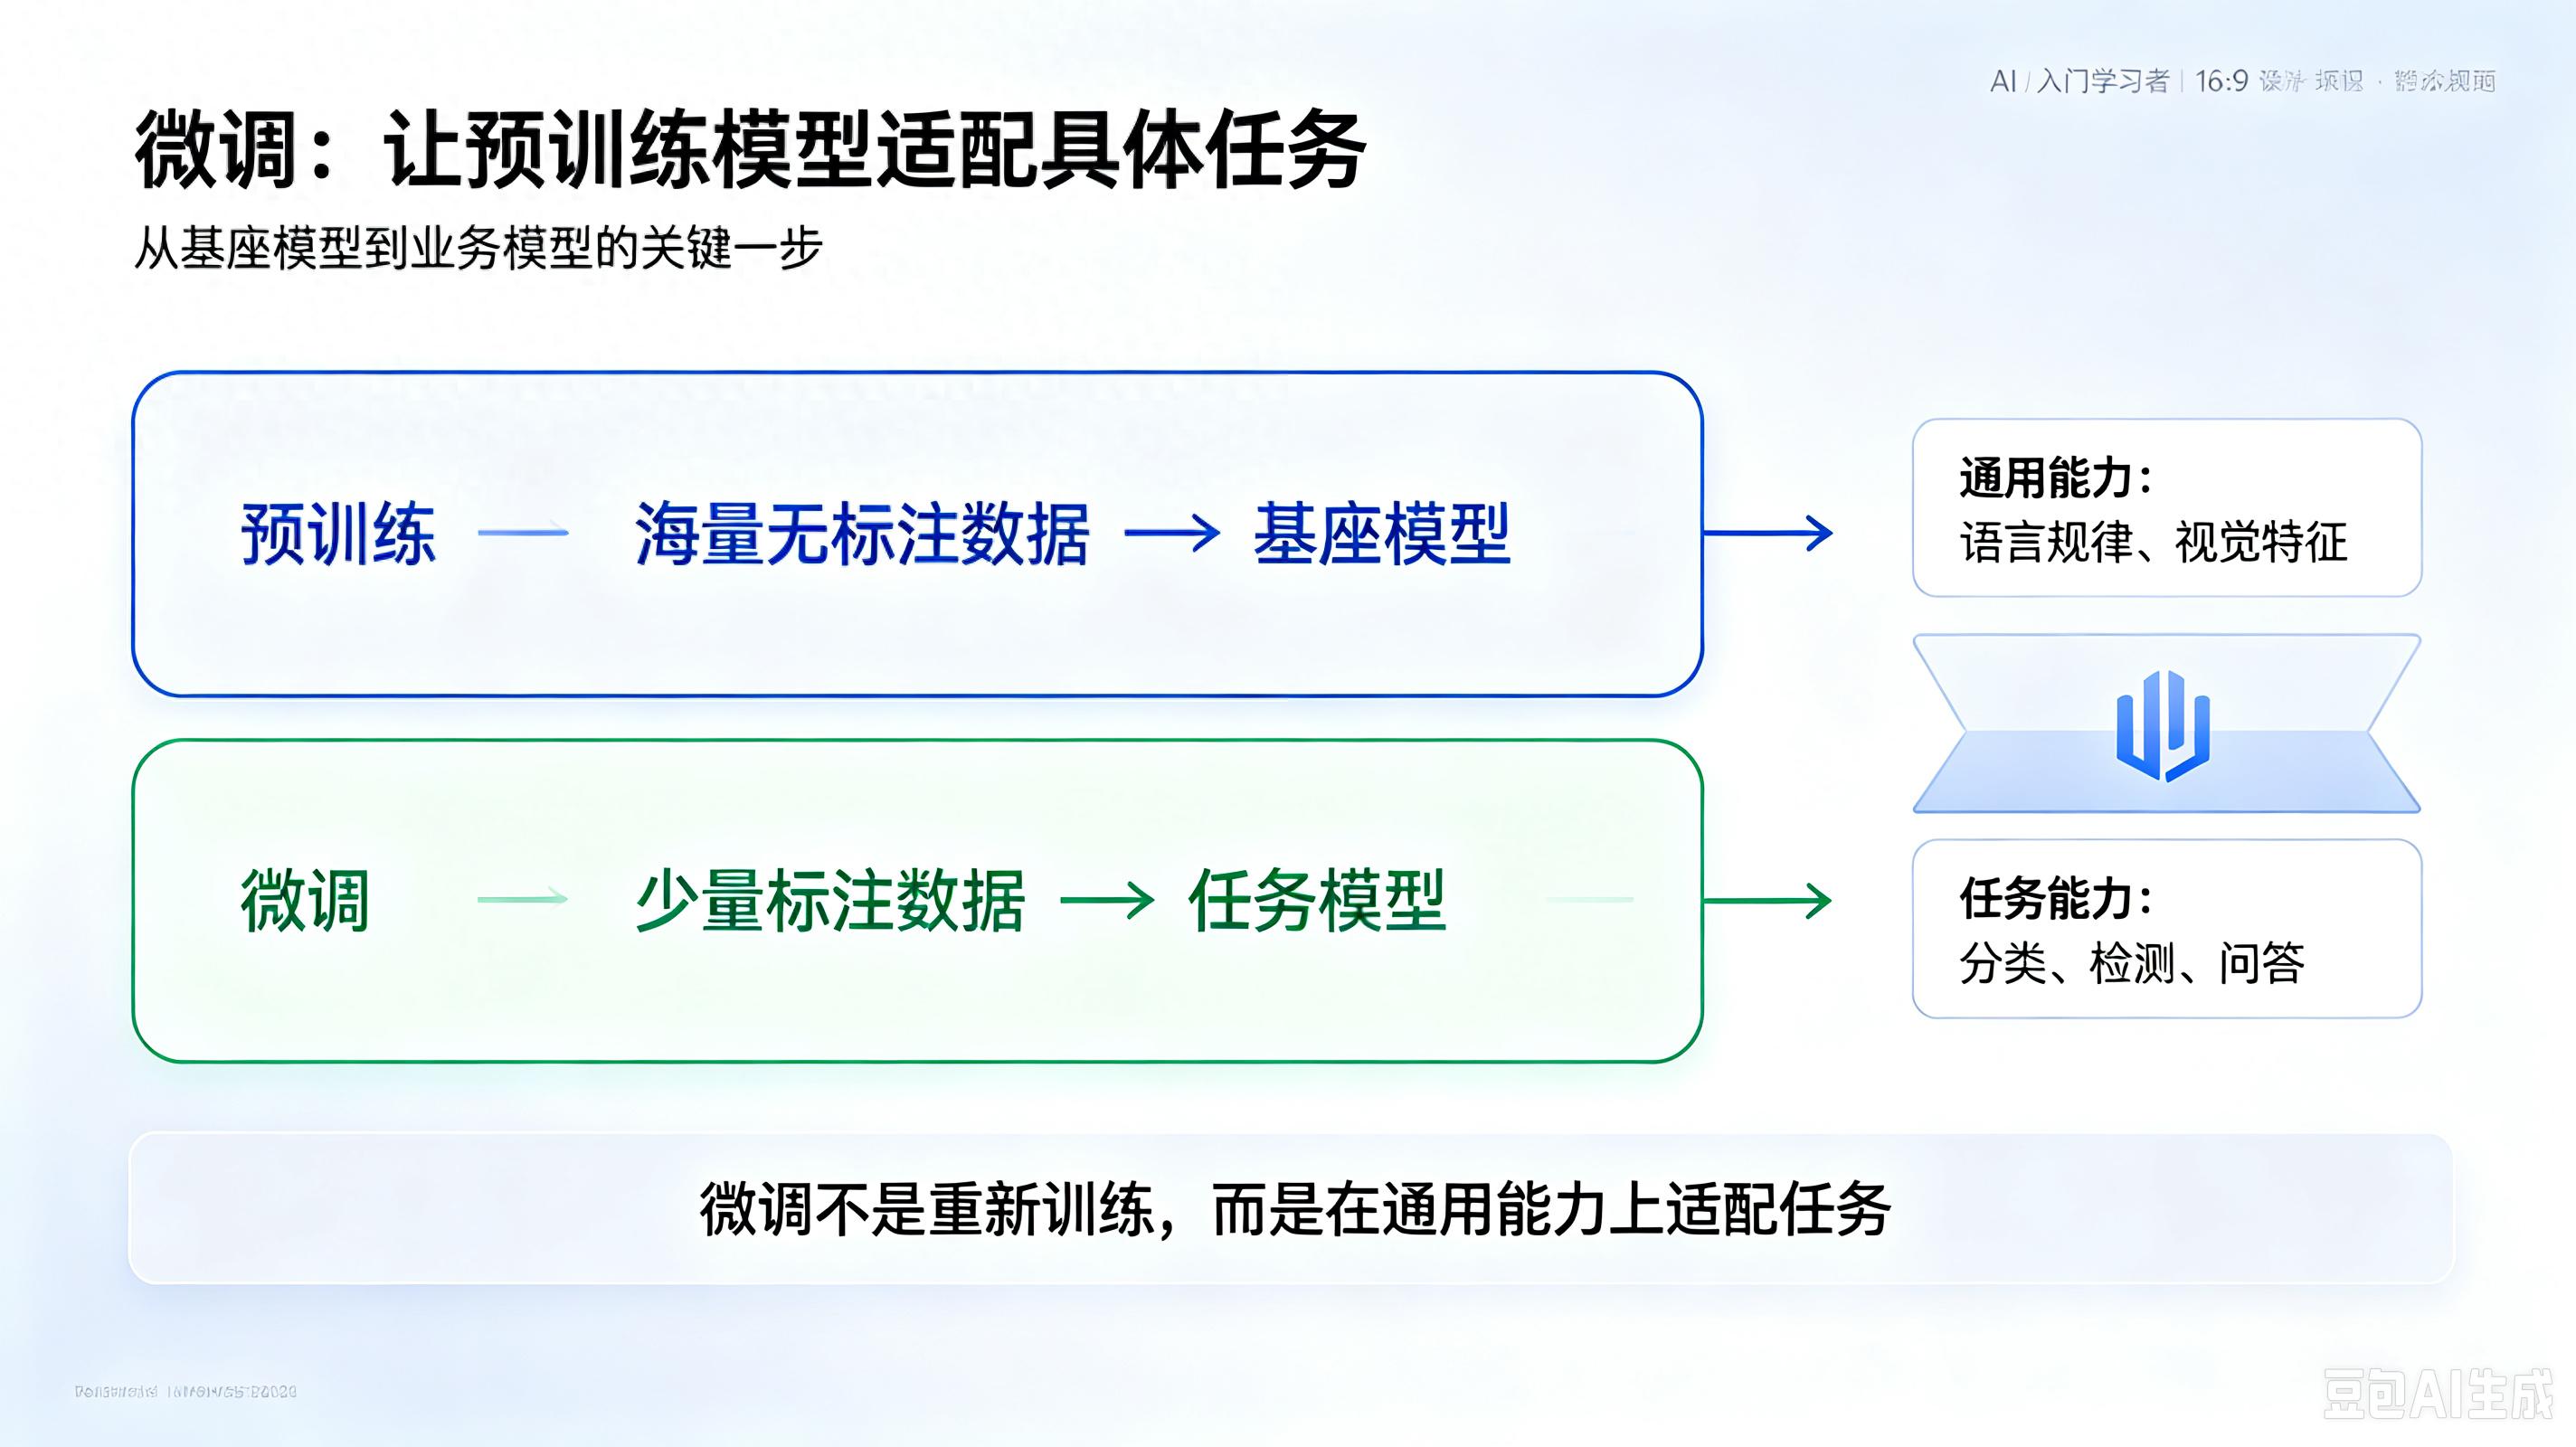
预训练后的基座模型具备广谱泛化能力,能理解基础语义与视觉特征,但没有针对性的任务认知,无法适配细分场景需求,存在输出随意、贴合业务度低、指令跟随弱等问题。而微调的核心价值,就是在不破坏模型通用能力的前提下,教会模型专属任务规则、行业知识和输出格式,弥补通用模型的场景短板,让模型从“全能通用”变为“精准专用”。
微调的核心逻辑是小范围、针对性迭代。不同于预训练海量数据的大规模权重更新,微调依托高质量、小体量的标注数据集,对Transformer的自注意力、前馈网络等模块权重进行精细调优。训练过程中,模型会摒弃通用场景的冗余输出逻辑,固化专属任务的识别、推理与生成逻辑,精准适配文本分类、专属问答、图像细分识别等各类下游任务。
目前主流微调方式分为两类,一是全量微调,更新模型全部权重,适配高精度场景但算力成本较高;二是参数高效微调,仅更新少量专属参数,低成本、高效率完成场景适配,是当下工程落地的主流选择。微调与预训练、提示工程相辅相成,预训练筑牢基础,微调固化场景能力,提示工程规范实时输出,共同支撑AI模型高效、稳定落地各类实际应用。