刚才看了看国产大模型公司智谱的财报,顺便聊一聊。
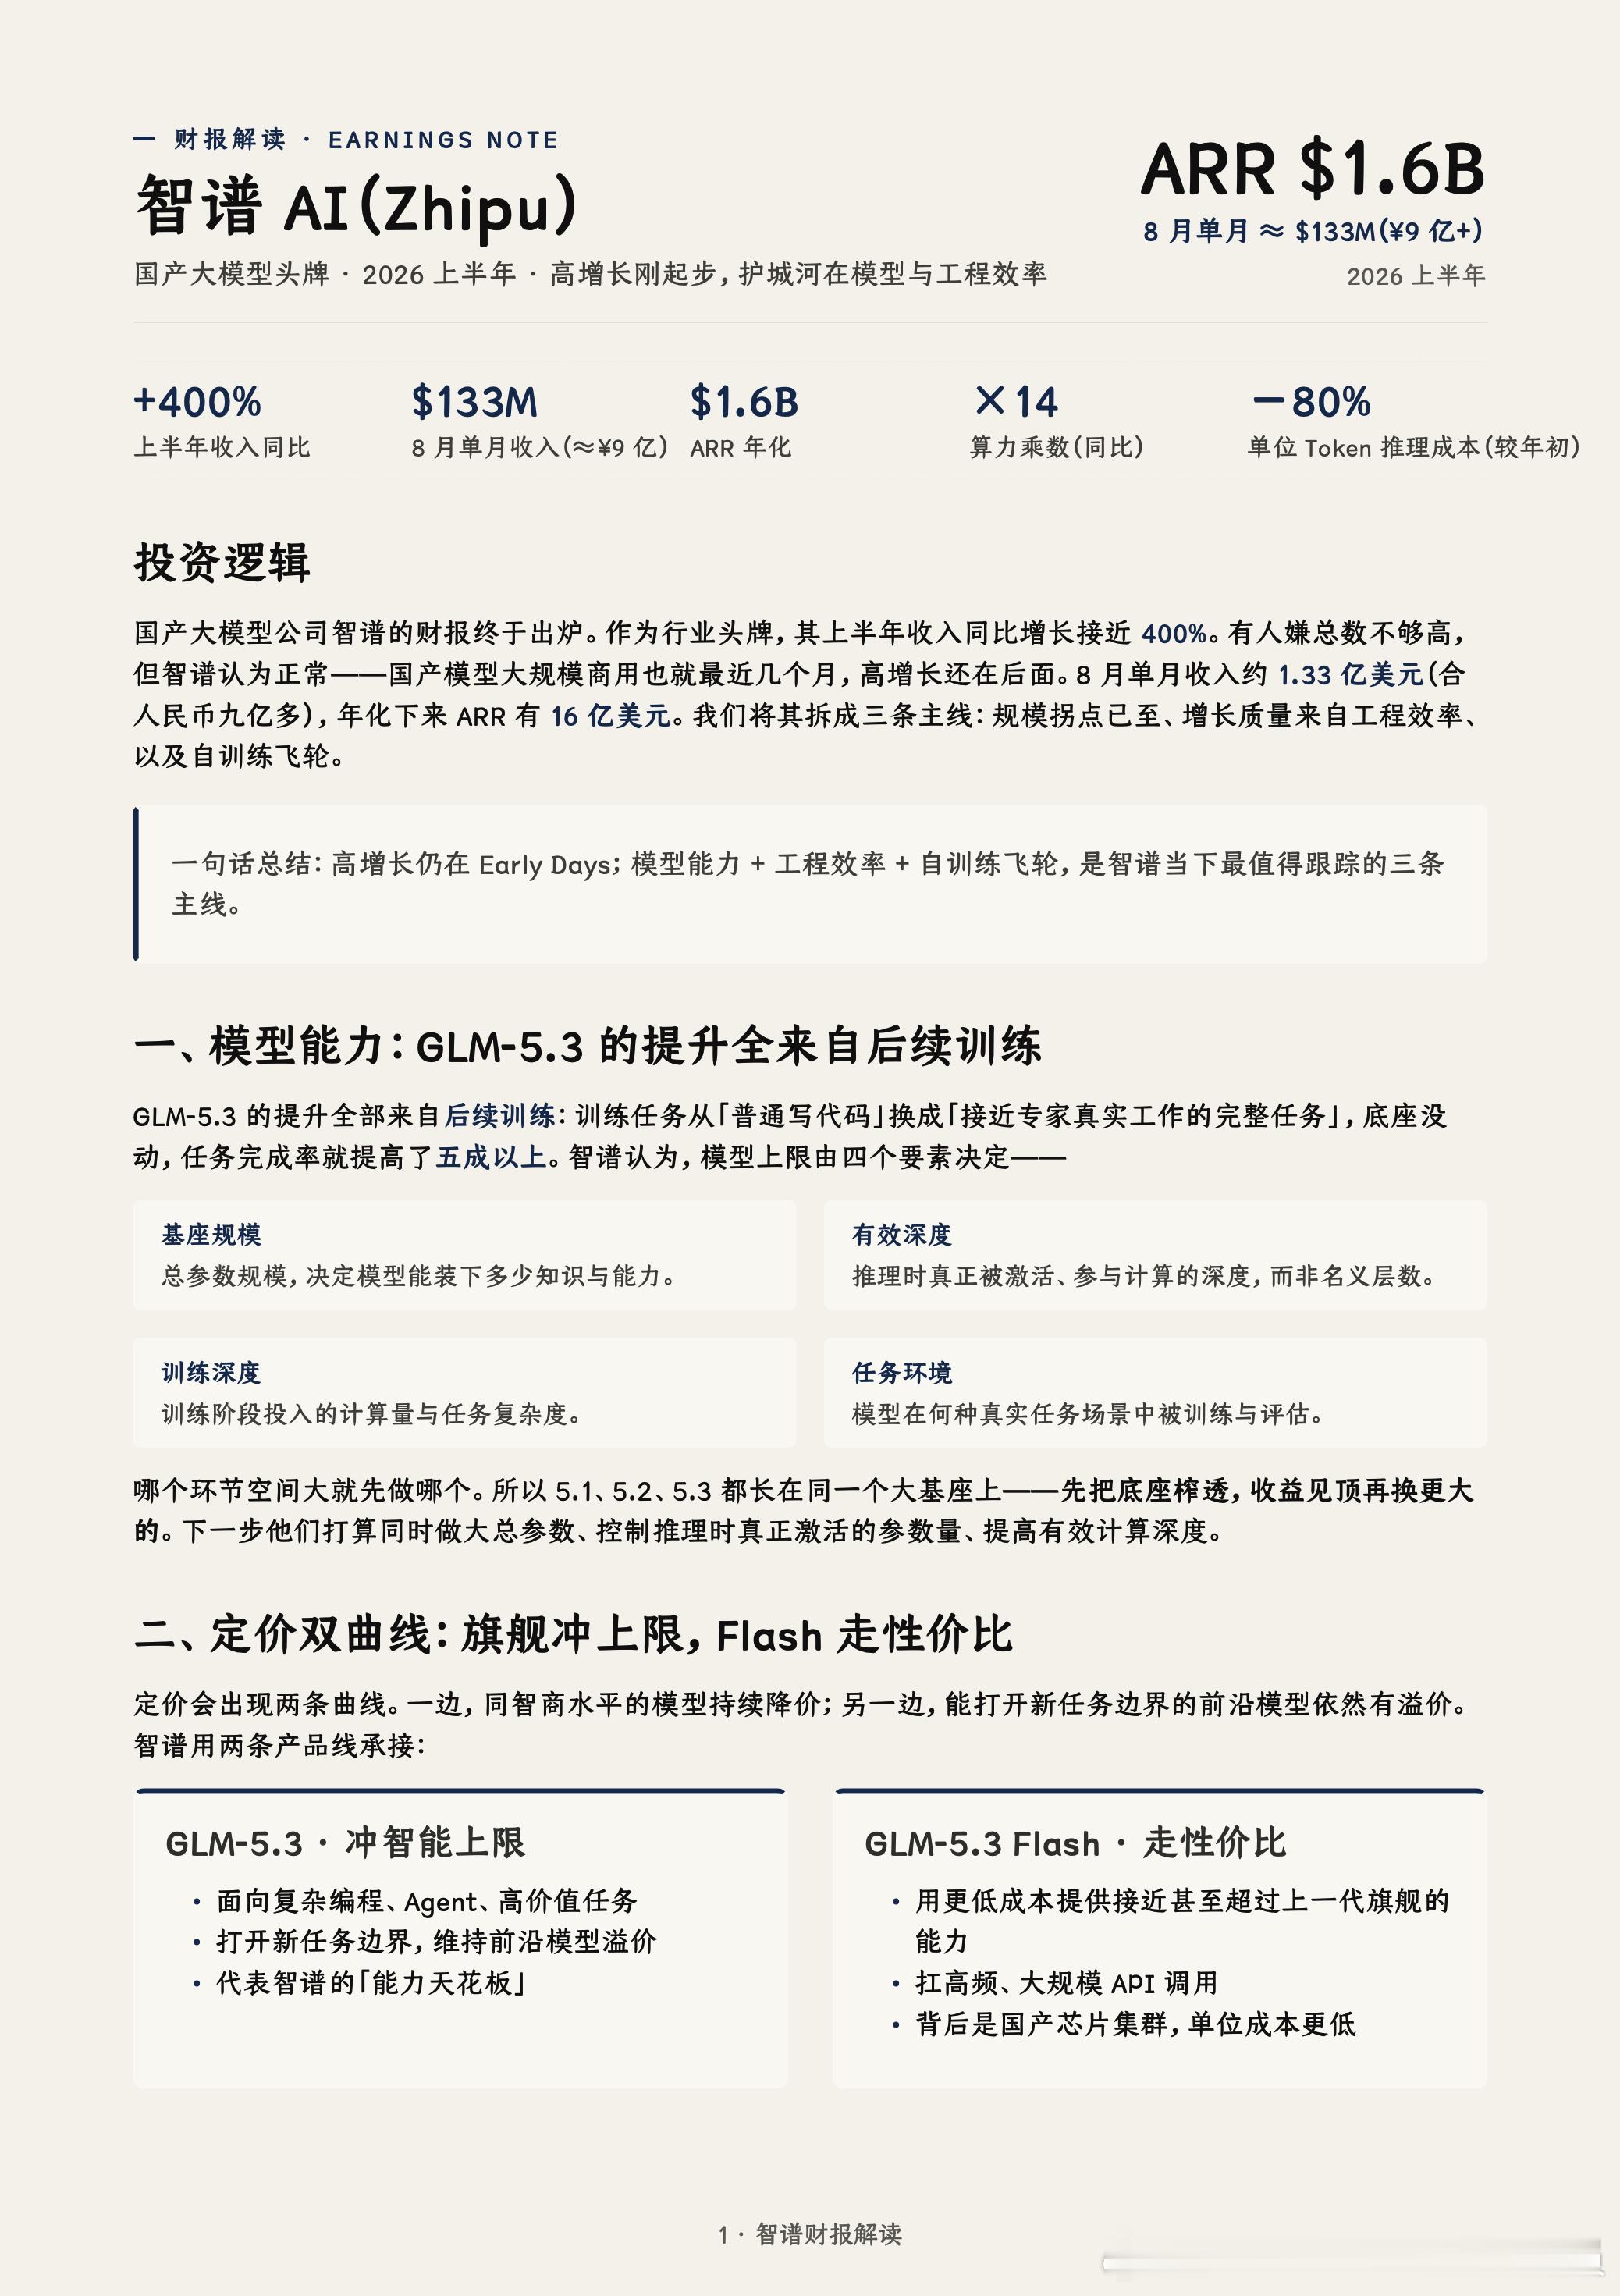
作为行业头牌,它上半年收入同比增长接近 400%。有人嫌总数不够高,我倒觉得正常,国产模型大规模商用也就最近几个月,高增长还在后面。智谱说,8 月单月收入约 1.33 亿美元,合人民币九亿多,年化下来 ARR 有 16 亿美元。
信息量很大,挑几个重点说。
先说模型。GLM-5.3 的提升全来自后续训练:训练任务从普通写代码,换成接近专家真实工作的完整任务,底座没动,任务完成率就提高五成以上。智谱认为,模型上限由基座规模、有效深度、训练深度、任务环境四要素决定,哪个环节空间大就先做哪个。所以 5.1、5.2、5.3 都长在同一个大基座上,先把底座榨透,收益见顶再换更大的。下一步他们打算同时做大总参数、控制推理时真正激活的参数量、提高有效计算深度。
定价会出现两条曲线。一边,同智商水平的模型持续降价,GLM-5.3 Flash 就用更低成本提供接近甚至超过上一代旗舰的能力;另一边,能打开新任务边界的前沿模型依然有溢价。所以 5.3 冲智能上限,做复杂编程、Agent 和高价值任务;Flash 走性价比,扛高频大规模调用。
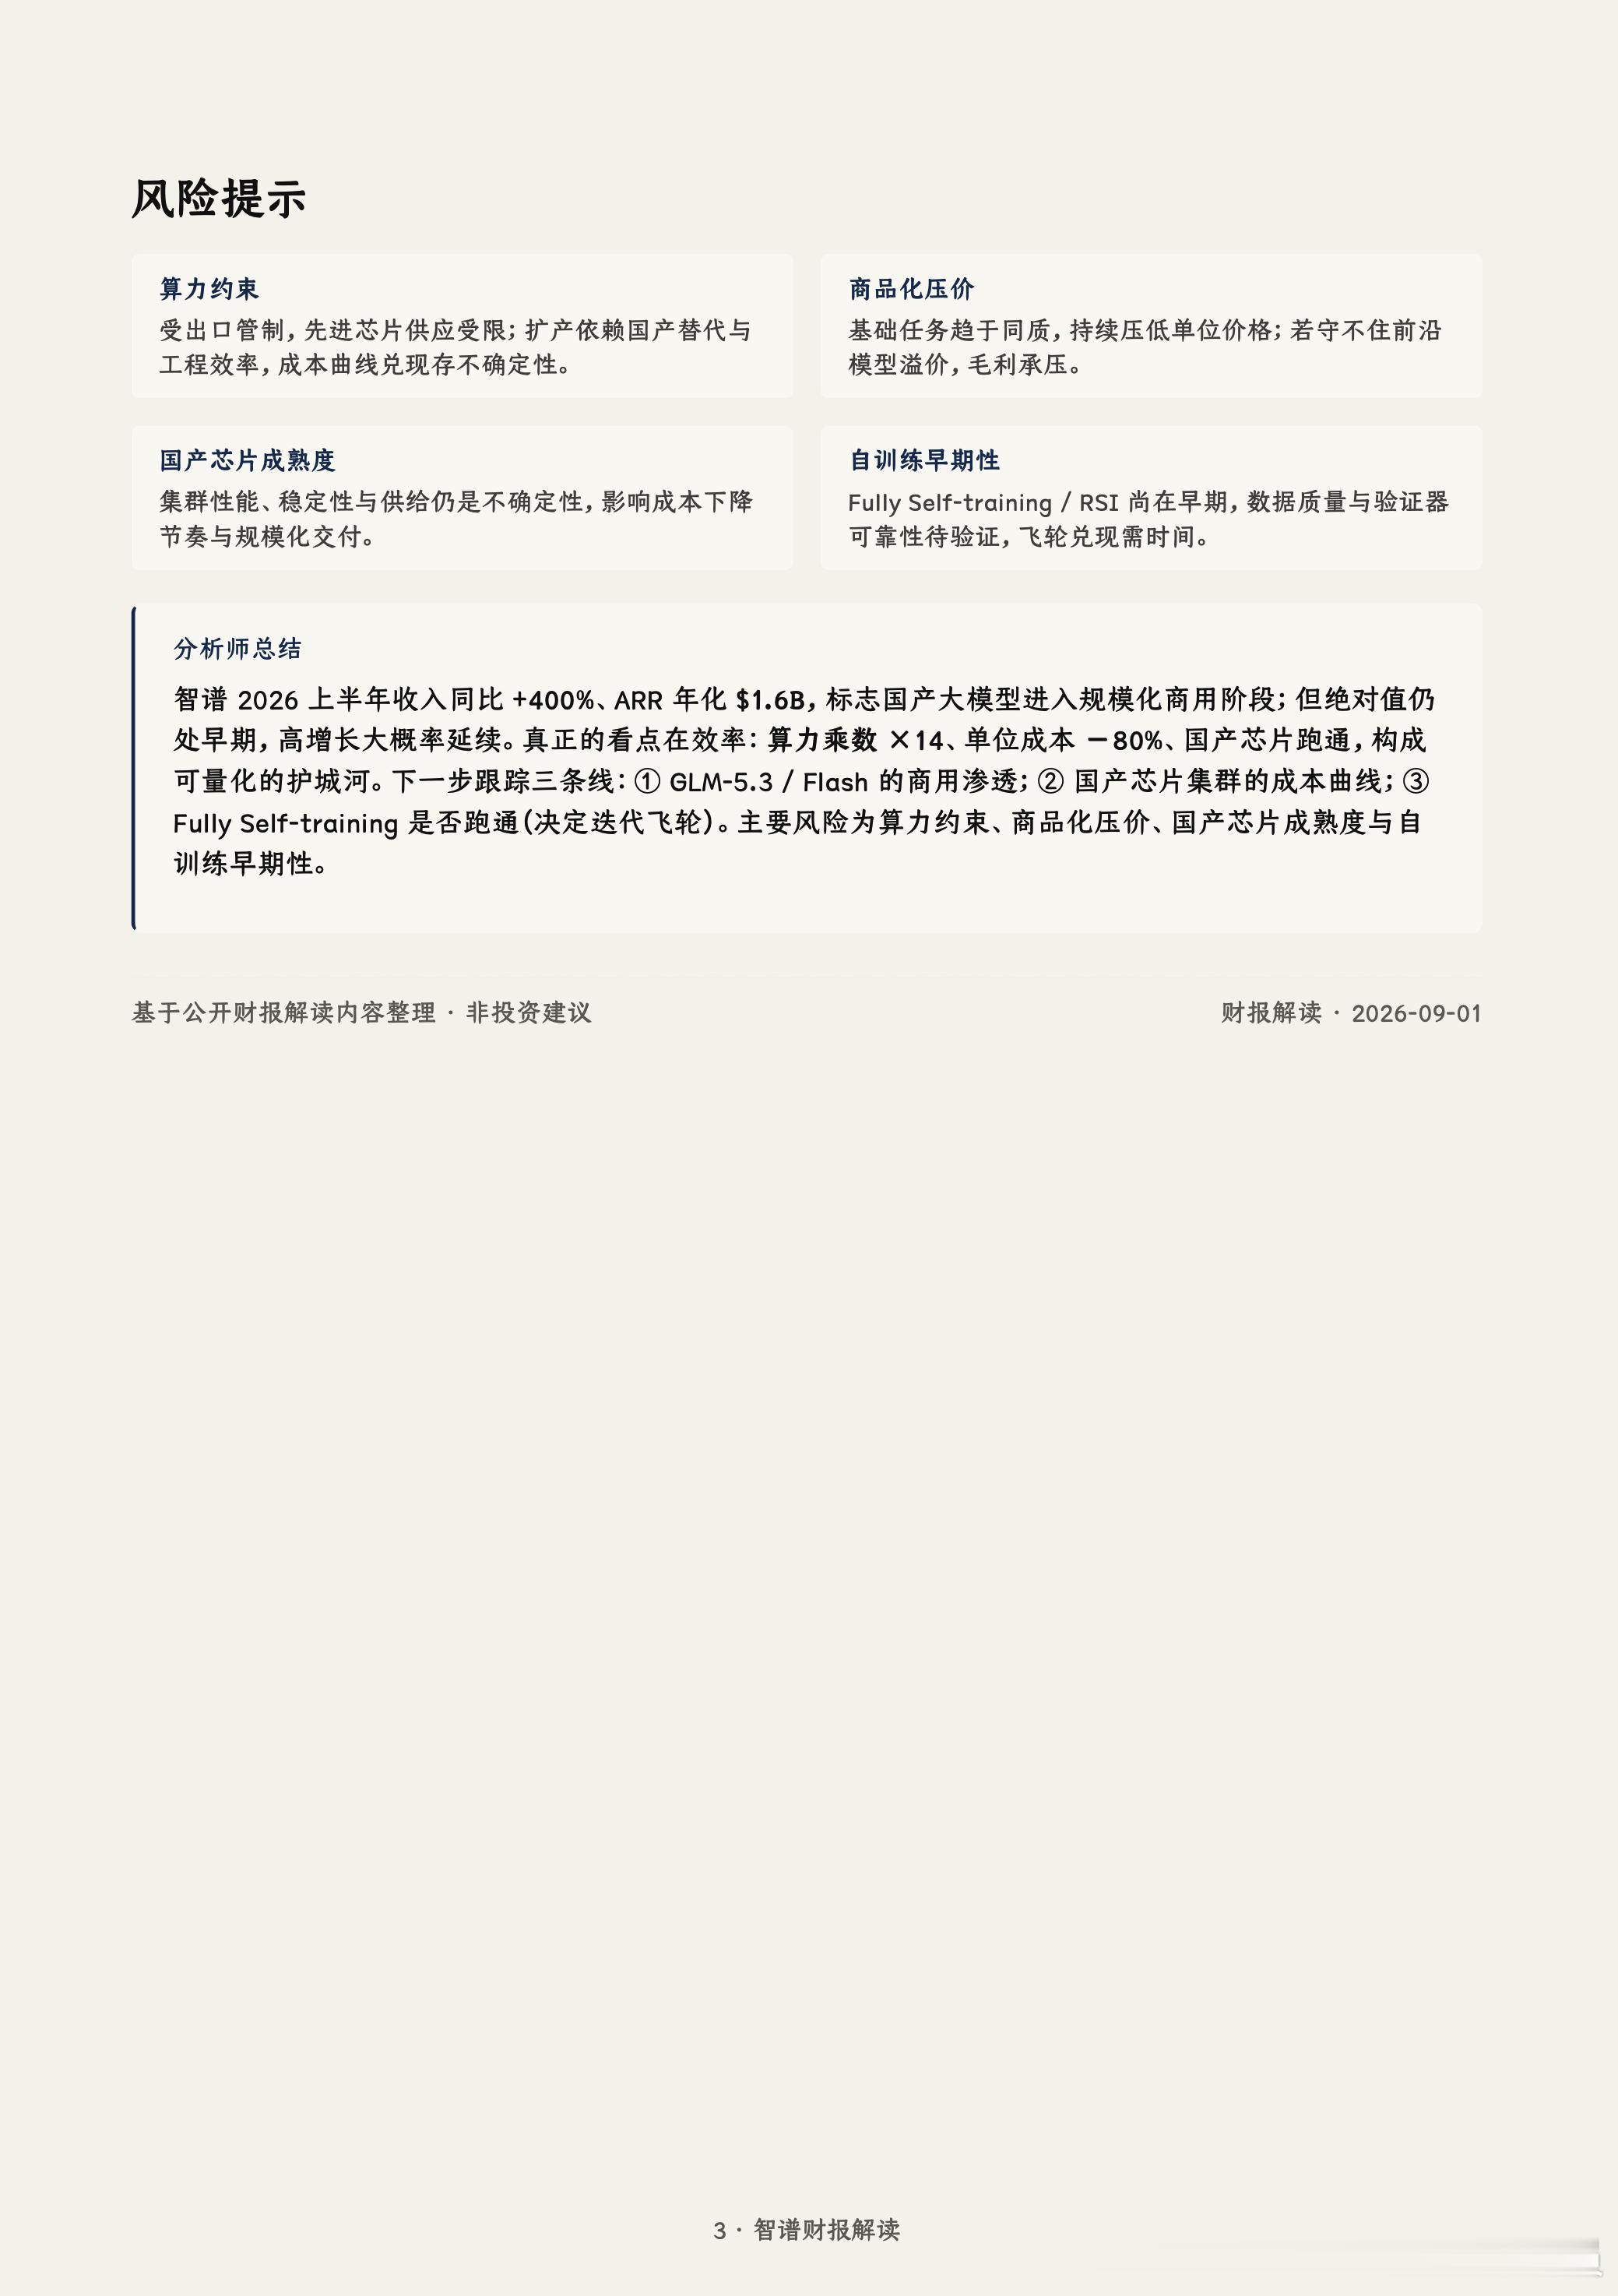
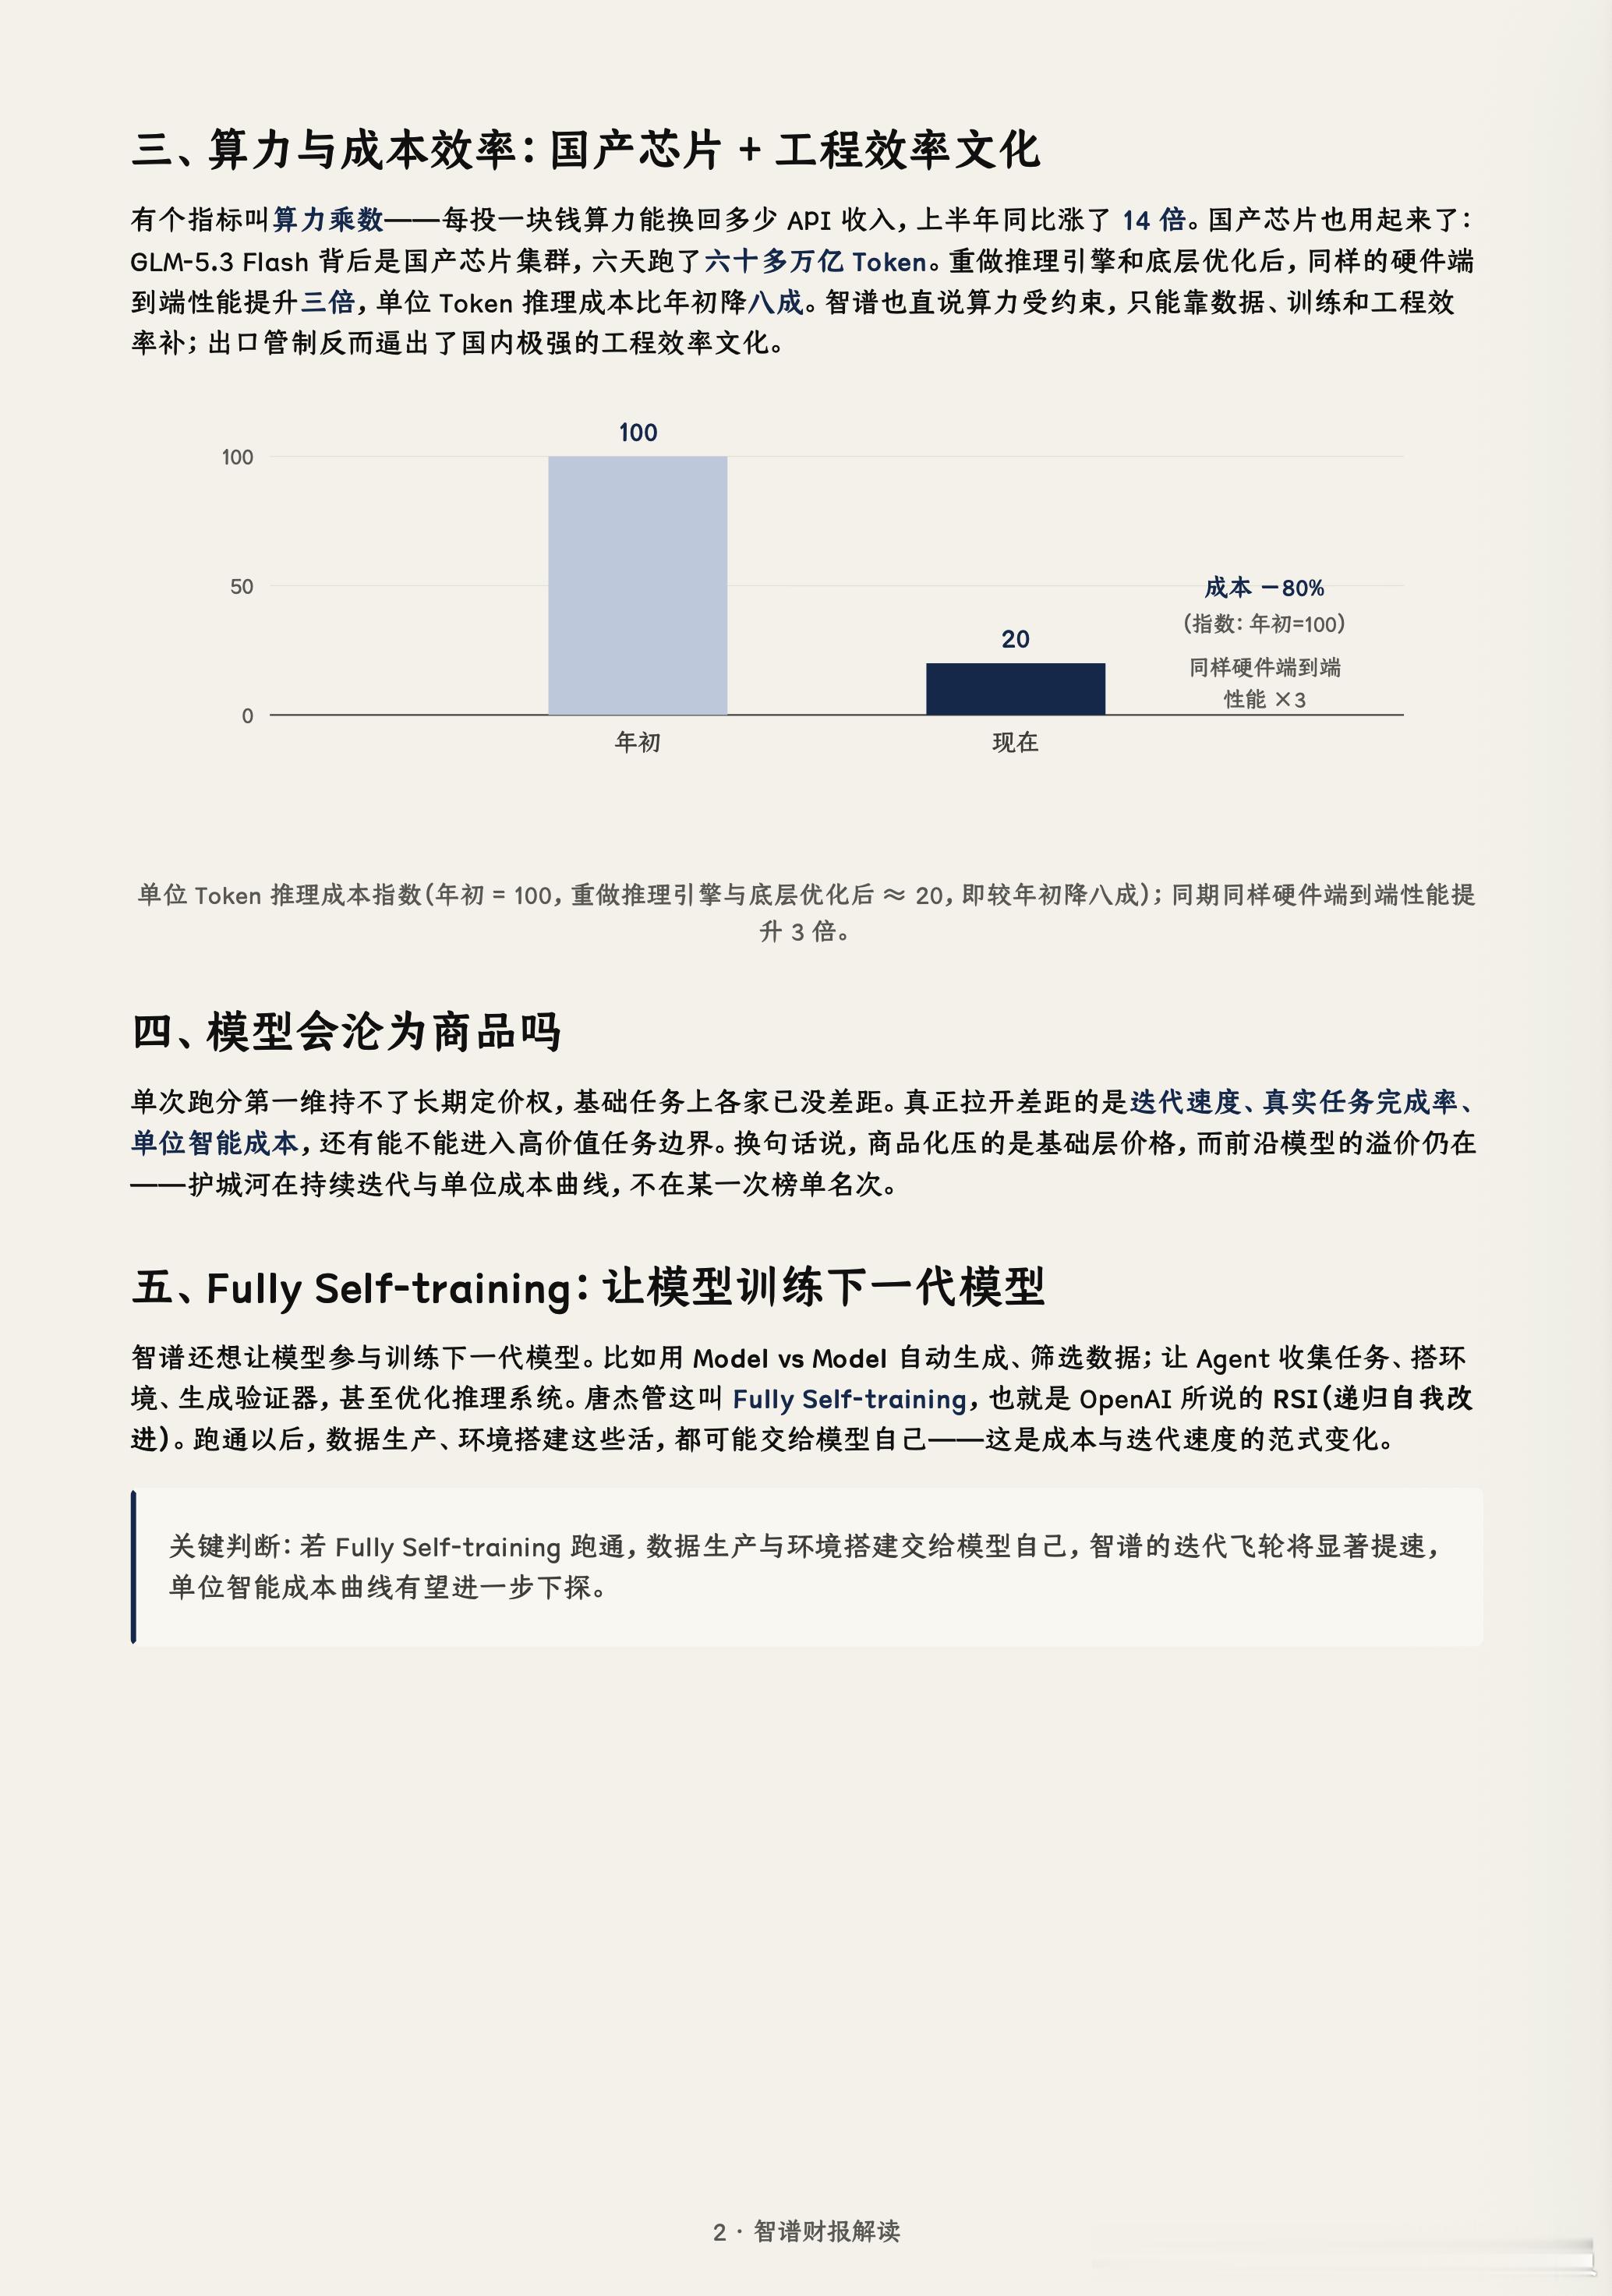
还有个指标叫算力乘数,指每投一块钱算力能换回多少 API 收入,上半年同比涨了 14 倍。国产芯片也用起来了,GLM-5.3 Flash 背后是国产芯片集群,六天跑了六十多万亿 Token;重做推理引擎和底层优化后,同样的硬件端到端性能提升三倍,单位 Token 推理成本比年初降八成。智谱也直说算力受约束,只能靠数据、训练和工程效率补,出口管制反而逼出了国内极强的工程效率文化。
模型会不会沦为商品?单次跑分第一维持不了长期定价权,基础任务上各家已没差距。真正拉开差距的是迭代速度、真实任务完成率、单位智能成本,还有能不能进入客户的工作流。任务越长差距越明显,答一道题可能只差几分,但连续跑几小时的软件工程任务,要调工具、处理失败、重新规划,能不能干完就高下立判。模型进了客户的代码库,换模型就不只是换 API 地址,迁移成本会越来越高。所以简单能力越来越商品化,能进真实工作流的前沿模型依然有定价权。
智谱还想让模型参与训练下一代模型,比如用 Model vs Model 自动生成筛选数据,让 Agent 收集任务、搭环境、生成验证器,甚至优化推理系统。唐杰管这叫 Fully Self-training,也就是 OpenAI 说的 RSI。跑通以后,数据生产、环境搭建这些活都可能交给模型自己。
科技先锋官How I AI