211本硕 | 自学AI算法开发day39
自学 AI 算法开发 Day 39
今天继续深入学习 Transformer 中的 Masked Attention(掩码注意力机制)。在前一天理解基本作用的基础上,今天重点把 Mask 在注意力计算中的位置、原理以及实际意义又梳理了一遍。
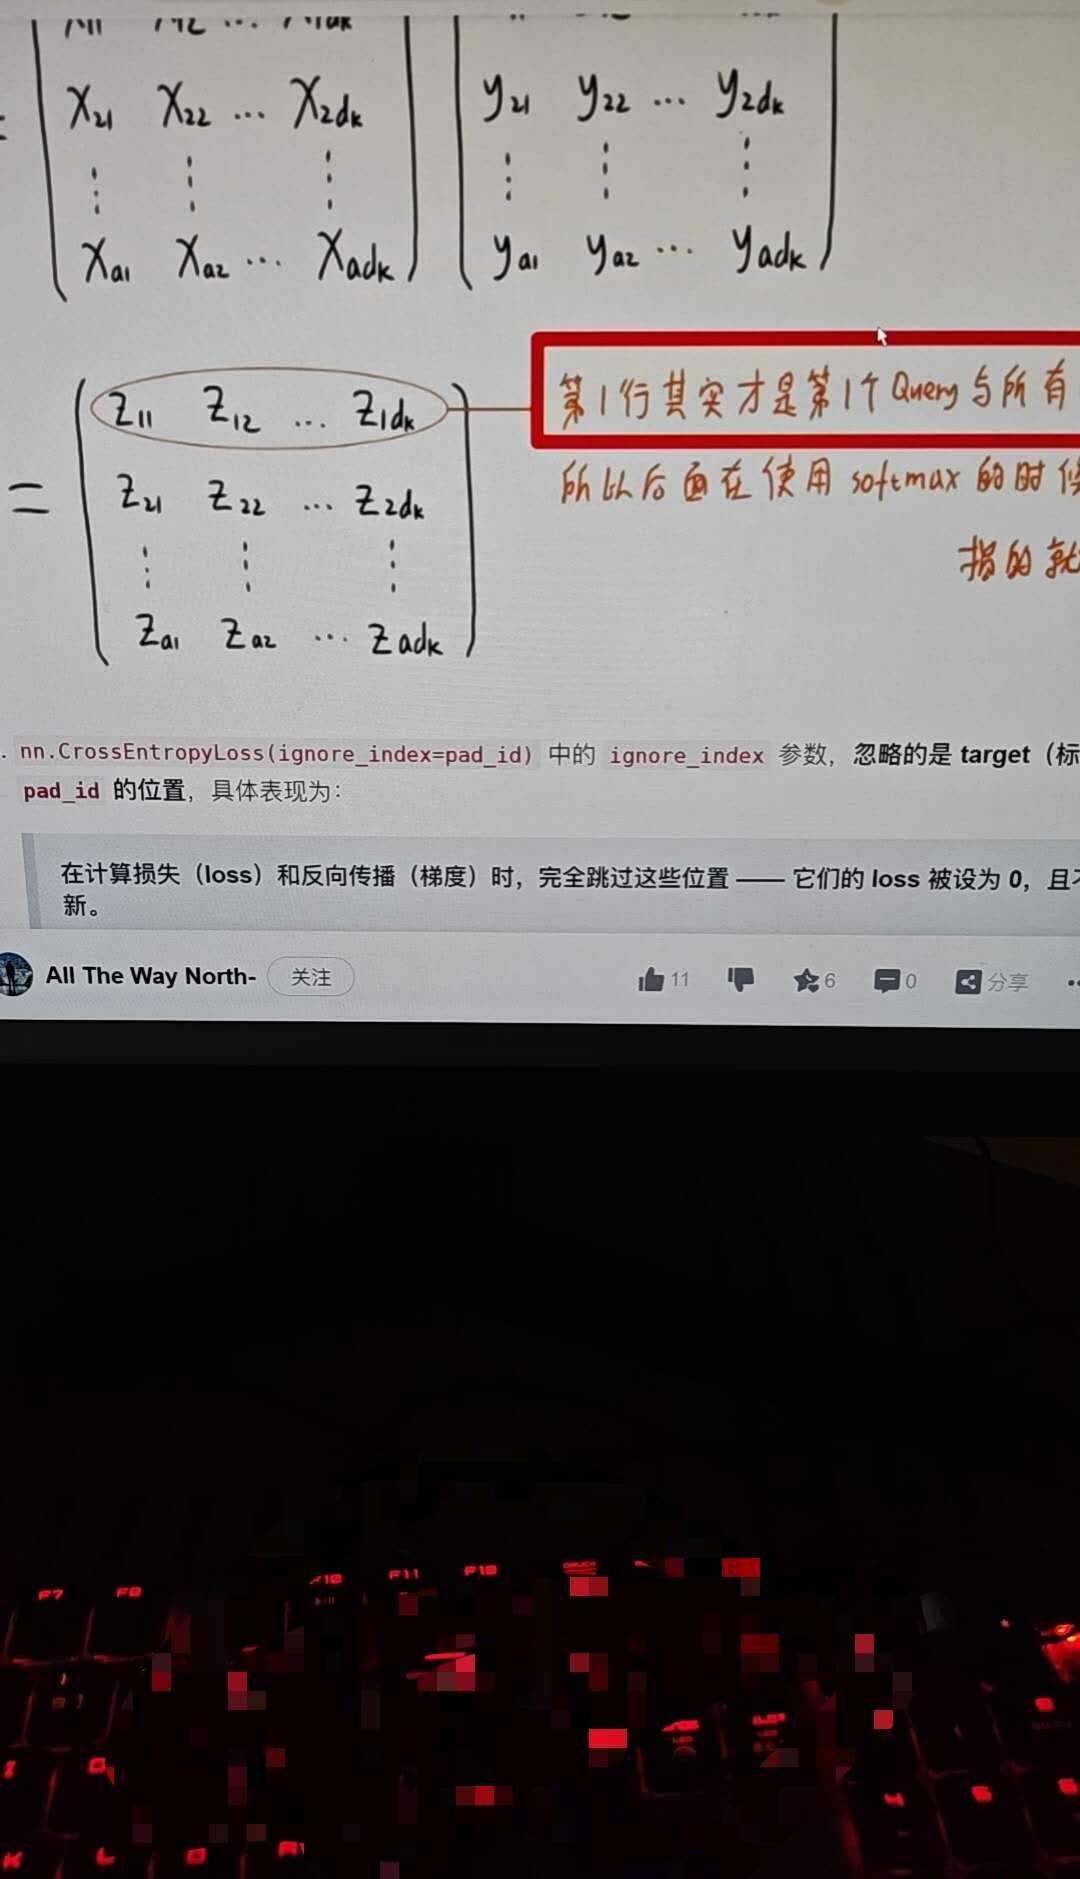
我进一步理解了,Mask 通常是在计算完 `QKᵀ / √d_k` 之后、进入 Softmax 之前加入。对于不允许关注的位置,可以把对应的 Attention Score 设置成 `-inf` 或一个非常小的数,这样经过 Softmax 以后,这些位置对应的权重就会变成 0,从而真正实现“看不到”这些 Token。
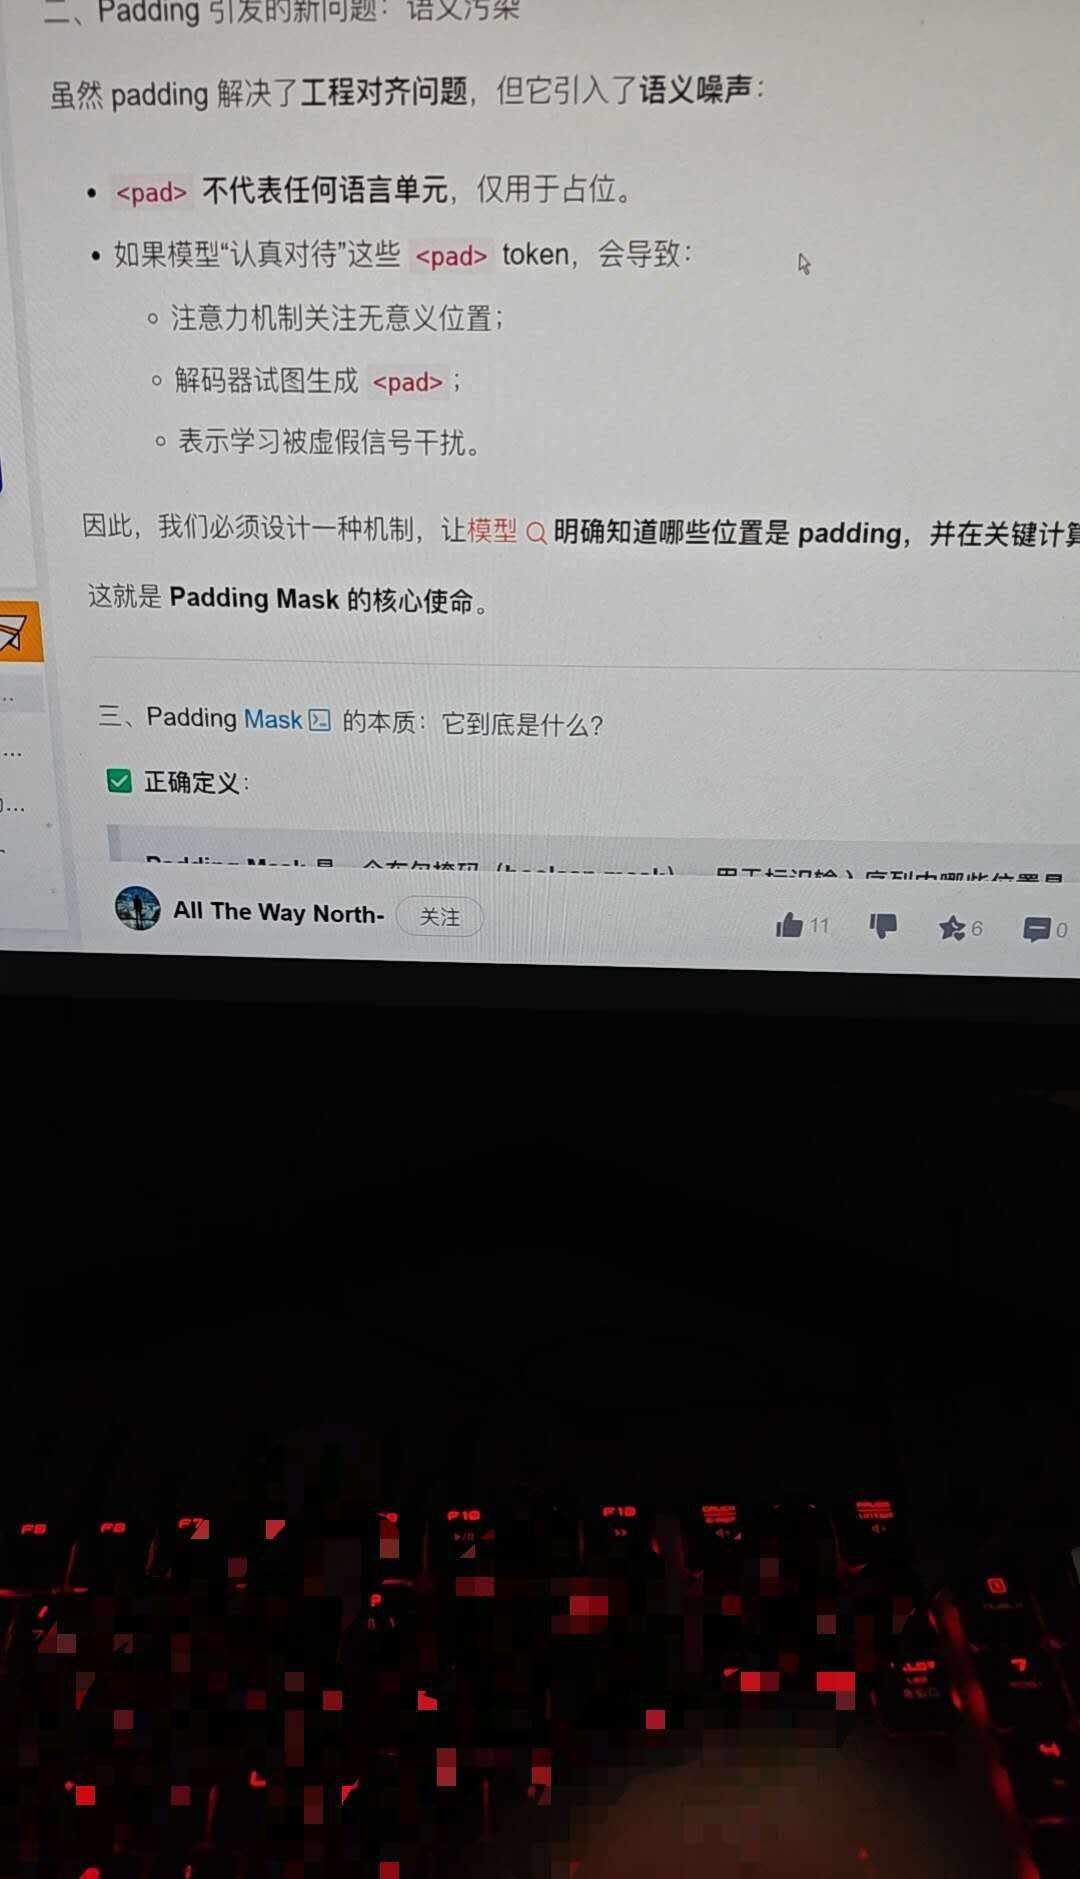
今天也进一步区分了不同类型的 Mask。像 Decoder 中常见的 Causal Mask,主要是为了防止当前 Token 偷看未来信息;而在实际批量训练中,还可能会使用 **Padding Mask**,把补齐长度时产生的无效 Token 屏蔽掉。
通过今天的学习,我对 Masked Attention 的理解已经不只是“加一个三角矩阵”,而是开始理解它实际上是在控制 Attention 的信息流向。模型能够看到谁、不能看到谁,都是通过 Mask 来约束的。这个机制也是理解 Transformer Decoder、GPT 自回归生成以及后续大模型训练过程非常重要的一环。
自学AI AI算法 Transformer MaskedAttention CausalMask PaddingMask SelfAttention PyTorch 大模型开发 学习打卡 @山羊算法(AI算法训练营)