最近,OpenAI 的 Astra 被曝用了 Loop Transformer 技术来提高智能的上限!
Loop Transformer 这条路线,我先前就挺关注的,应该是今年3月初火了一阵子。原理很好理解:让模型在输出前,先在内部多循环几轮。
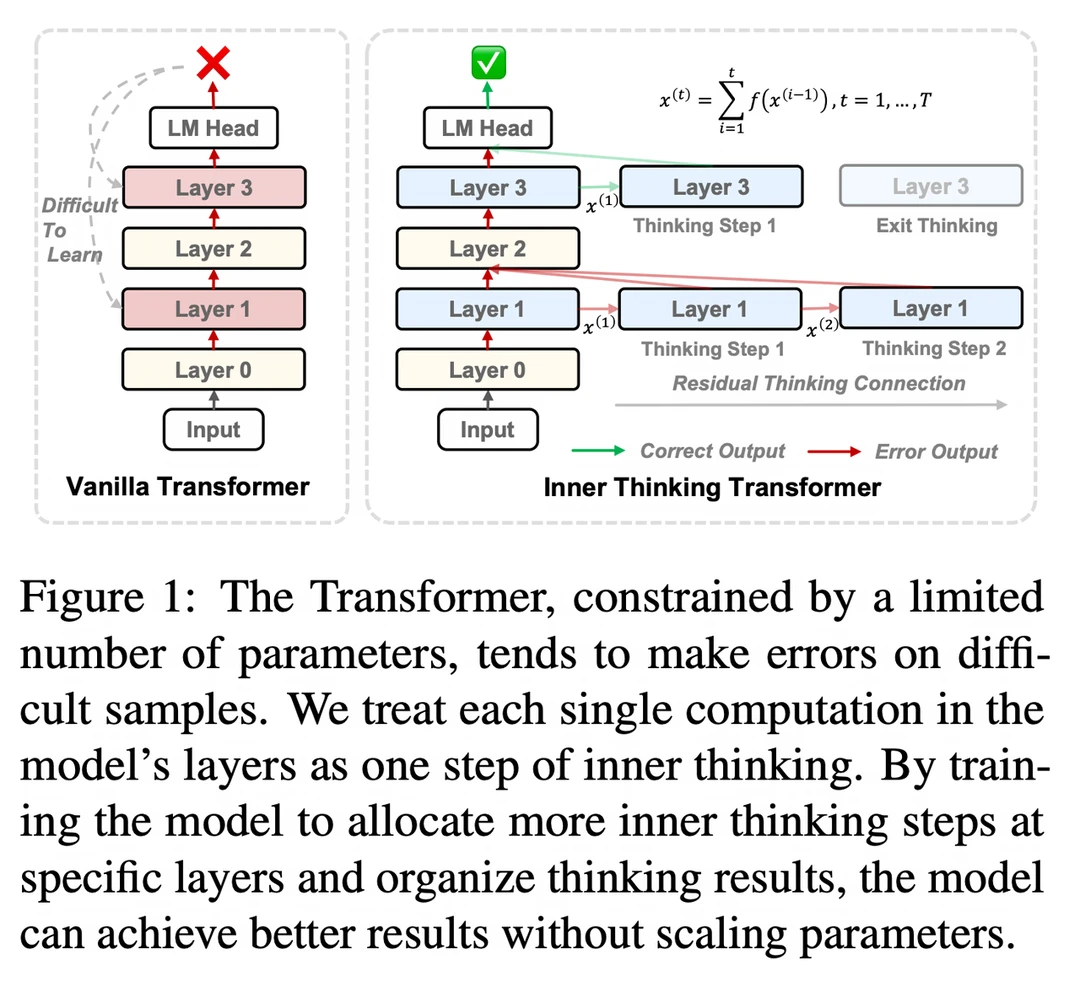
普通 Transformer 可以粗略理解成一条流水线,信息经过一层又一层加工,最后输出。
Loop Transformer 则让其中几组层重复计算:上一轮算出的结果,送回来继续加工。同一套参数反复用,实际思考就能走得更深。
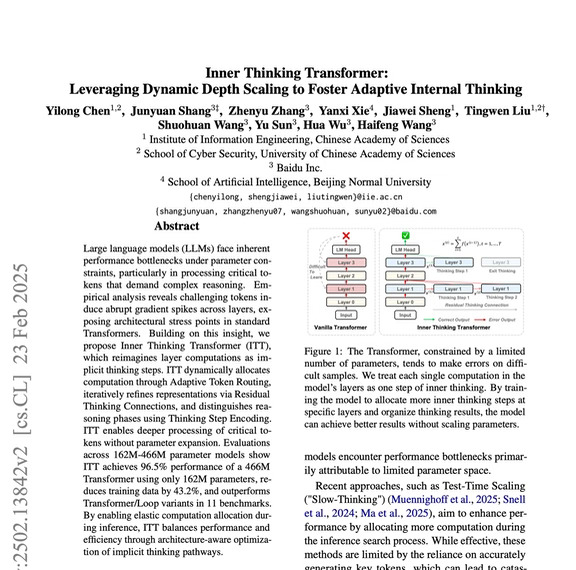
但其实百度文心在 ACL 2025 就中稿了 Loop Transformer,百度把它叫做 ITT,全名 Inner Thinking Transformer。
百度和中科院、北师大的研究员在 2025 年 2 月就公开了这项工作,后来入选 ACL 2025 主会。看到这个时间,我确实有点感慨:百度对前沿技术的嗅觉,真的很敏锐,不愧是 AI 界的黄埔军校。
这篇论文在海外也有回响。知名 AI 研究者、技术作者 Sebastian Raschka 梳理 2025 年初 12 篇值得关注的推理研究时,就专门介绍过 ITT。后来 Google DeepMind、Google Research 参与的 MoR 论文也引用了它。
ITT 的做法,我觉得可以拆成三件事。
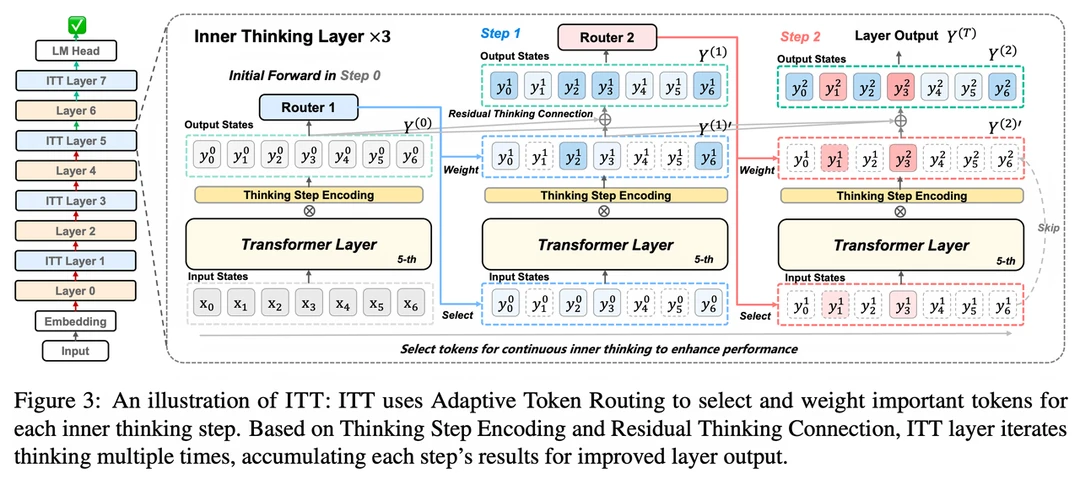
第一,让一些层多算几轮。同一层处理完,还可以接着加工刚得到的结果。这样,模型能在局部增加计算深度,参数也能重复利用。
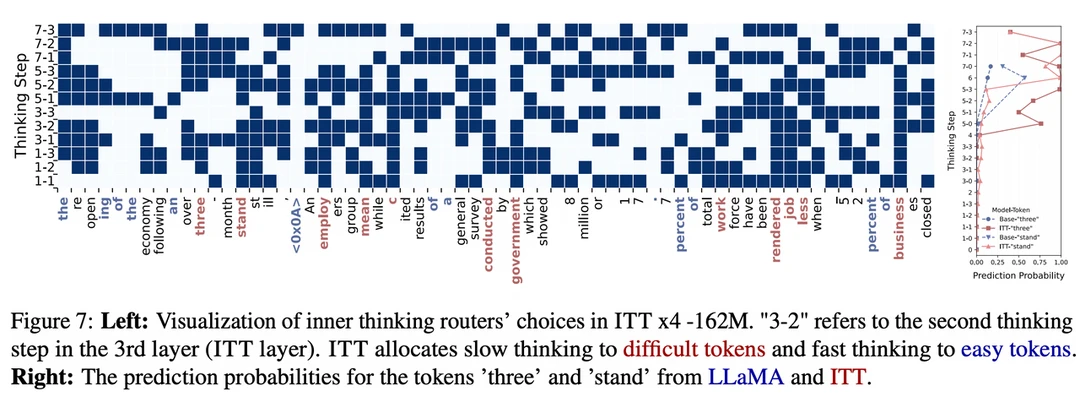
第二,挑重点算。文本会被拆成一个个 token,可以粗略理解成小块文字。每轮由路由器打分,选出一部分继续加工,其余保留当前结果。路由器会在训练中学习怎么挑,有点像做题时把时间留给卡住的地方。
第三,把前几轮的结果用起来。ITT 会把各轮结果加权累积,让下一轮接着已有信息继续更新。它还给不同轮次加上标记,帮助模型区分“这是第几遍了”,让反复计算有机会各有分工。
我喜欢这个思路,参数有限,就研究如何将算力用得更充分,把算力花在关键位置。当然,多算几轮依然有成本。
看到百度这么早就在研究这件事,我也会对百度多一点期待,方向看得这么早!
#百度 #文心 #文心大模型 #循环深度 #循环Transformer #ITT #howto入门codex #AI搞学习howto #AI反常识howto