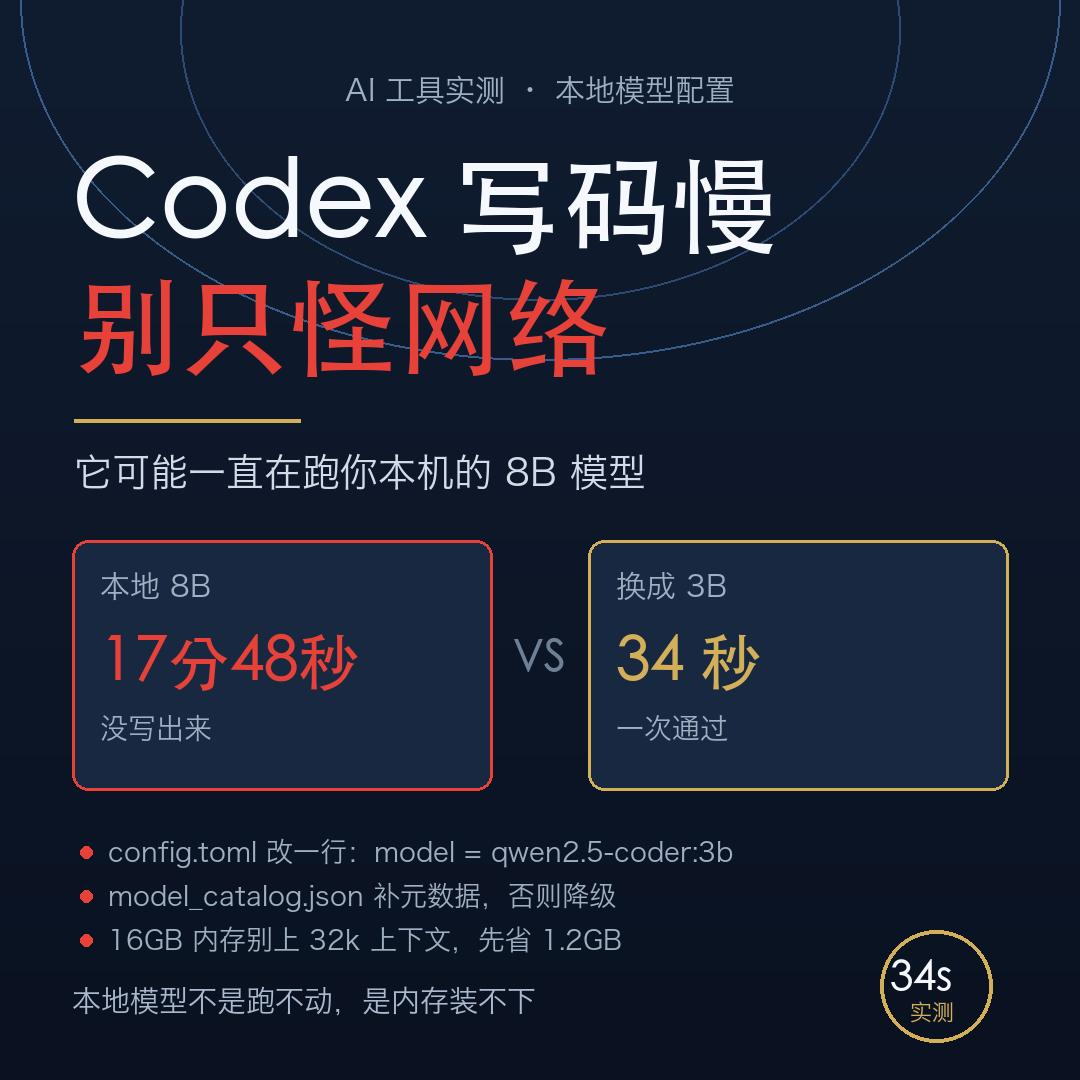
让 Codex 写个快速排序,它跑了 17 分 48 秒,一个字没写出来。
换个模型,同一个任务,34 秒写完。
问题不在 ChatGPT,也不在我这台 Mac——是我的 Codex 压根没连云端。
一、先看 Codex 到底在跑谁
打开 ~/.codex/config.toml,看 model_provider 那行。
我的是 model = "qwen3-8b-local:latest",model_provider = "ollama"。
也就是说,我以为在用 ChatGPT,其实请求全打在本机 11434 端口。
二、不是 GPU,是内存
日志里 offloaded 37/37 layers to GPU,显卡全速在跑。
真正卡的是 16GB 内存:8B 模型常驻就吃 7.9GB(权重 4.5 + 32k KV cache 2.4 + 计算图)。
内存一满,4.5GB 权重要从磁盘换回来,实测重载一次 270 秒,正常 SSD 十秒内完事。
Codex 还自带 4 千多 token 的系统提示和工具定义,8B 光读完就够呛。
三、我的配置,照抄可用
✅写代码主力:qwen2.5-coder:3b,1.9GB,没有思考开销
✅要质量时:qwen3-8b-16k,上下文 32768 降到 16384,省 1.2GB
✅别再用原版 8B + 32k,它就是这次的元凶
改两个地方:
👉config.toml → model = "qwen2.5-coder:3b"
👉model_catalog.json → 补一条 3B 元数据,不补会报 metadata not found 然后降级
改完 Cmd+Q 退 ChatGPT 重开,不是点红叉。
四、两个坑,我替你踩过了
⚠️brew services restart ollama 会按模板重写 plist,把你手配的环境变量清掉
⚠️改前先 cp 一份 .bak,我留了三份能退
💡本地模型不是跑不动,是 16GB 装不下 32k 的野心。
👉你的电脑多大内存?回复 1:16GB|回复 2:32GB 及以上|回复 3:还没试过本地模型
Codex 本地大模型 Ollama AI工具 程序员 效率工具
(技术配置仅供参考,硬件不同效果差异很大;改配置前务必备份,风险自担。)