机器人看人收纳一遍,就能照着做吗?RoboReel没有急着宣布“学会了”,而是搭了一套测试,检查不同方法究竟学到了什么。
这篇来自亚利桑那州立大学,NVIDIA研究者Peter Karkus参与。基准把真实人类视频、配对机器人仿真环境和机器人训练轨迹放在一起,覆盖10项桌面任务。
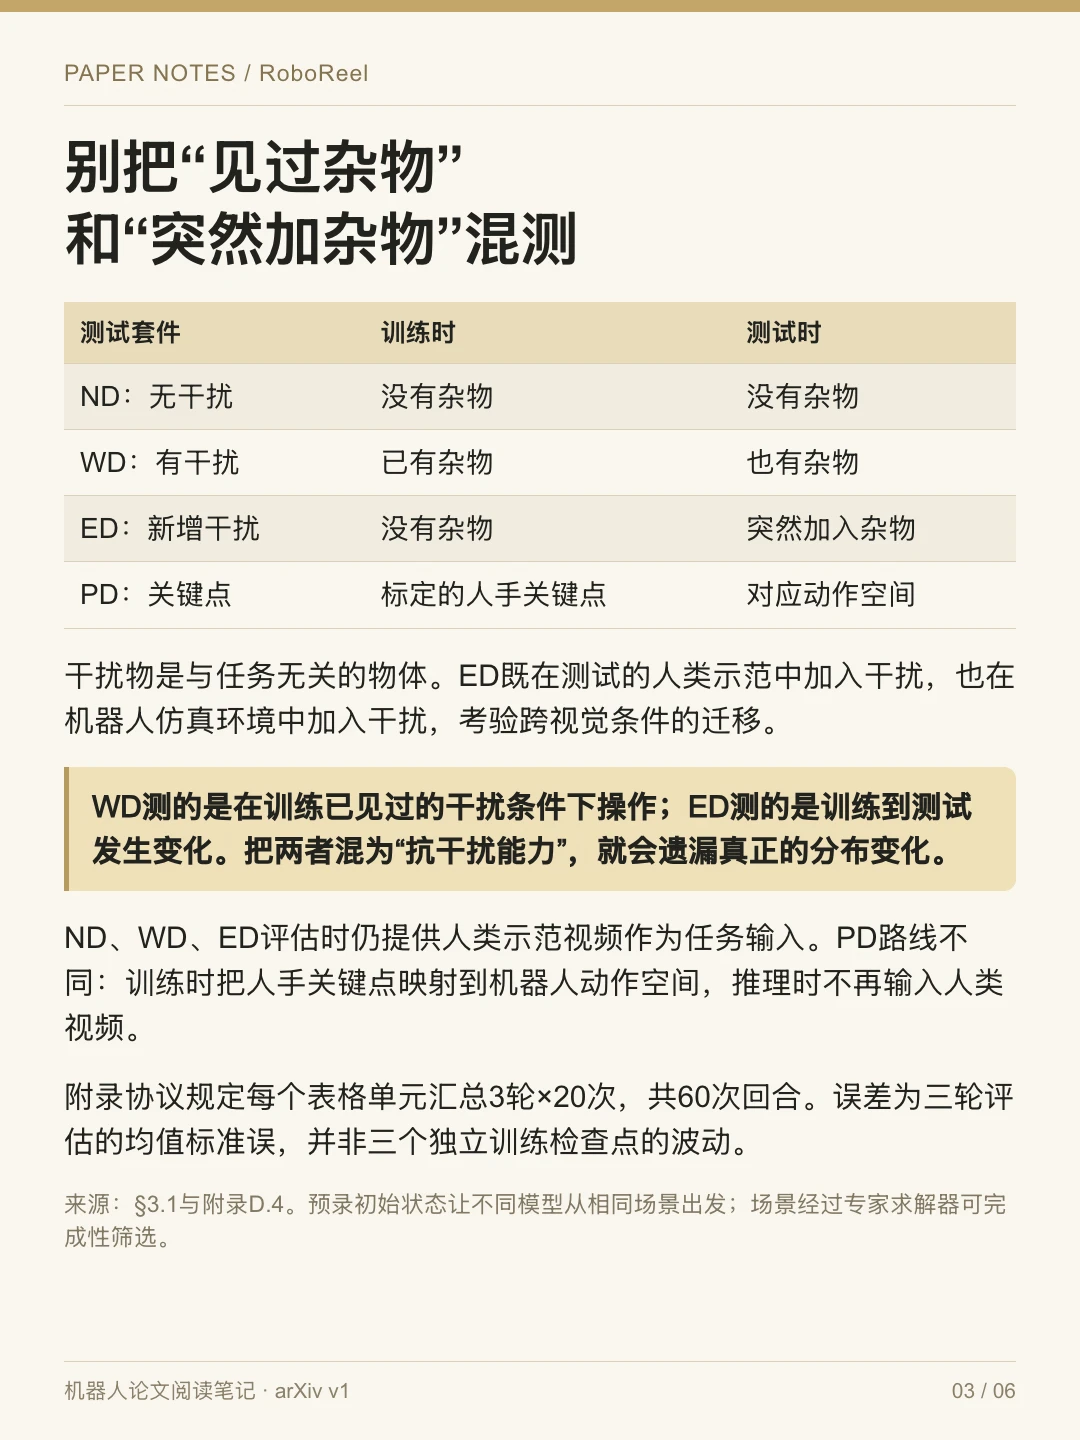
先区分三种条件:
ND:训练和测试都没杂物。
WD:训练和测试都有杂物。
ED:训练没杂物,测试突然加入。
另有使用标定人手关键点的PD套件,训练和推理协议不同。
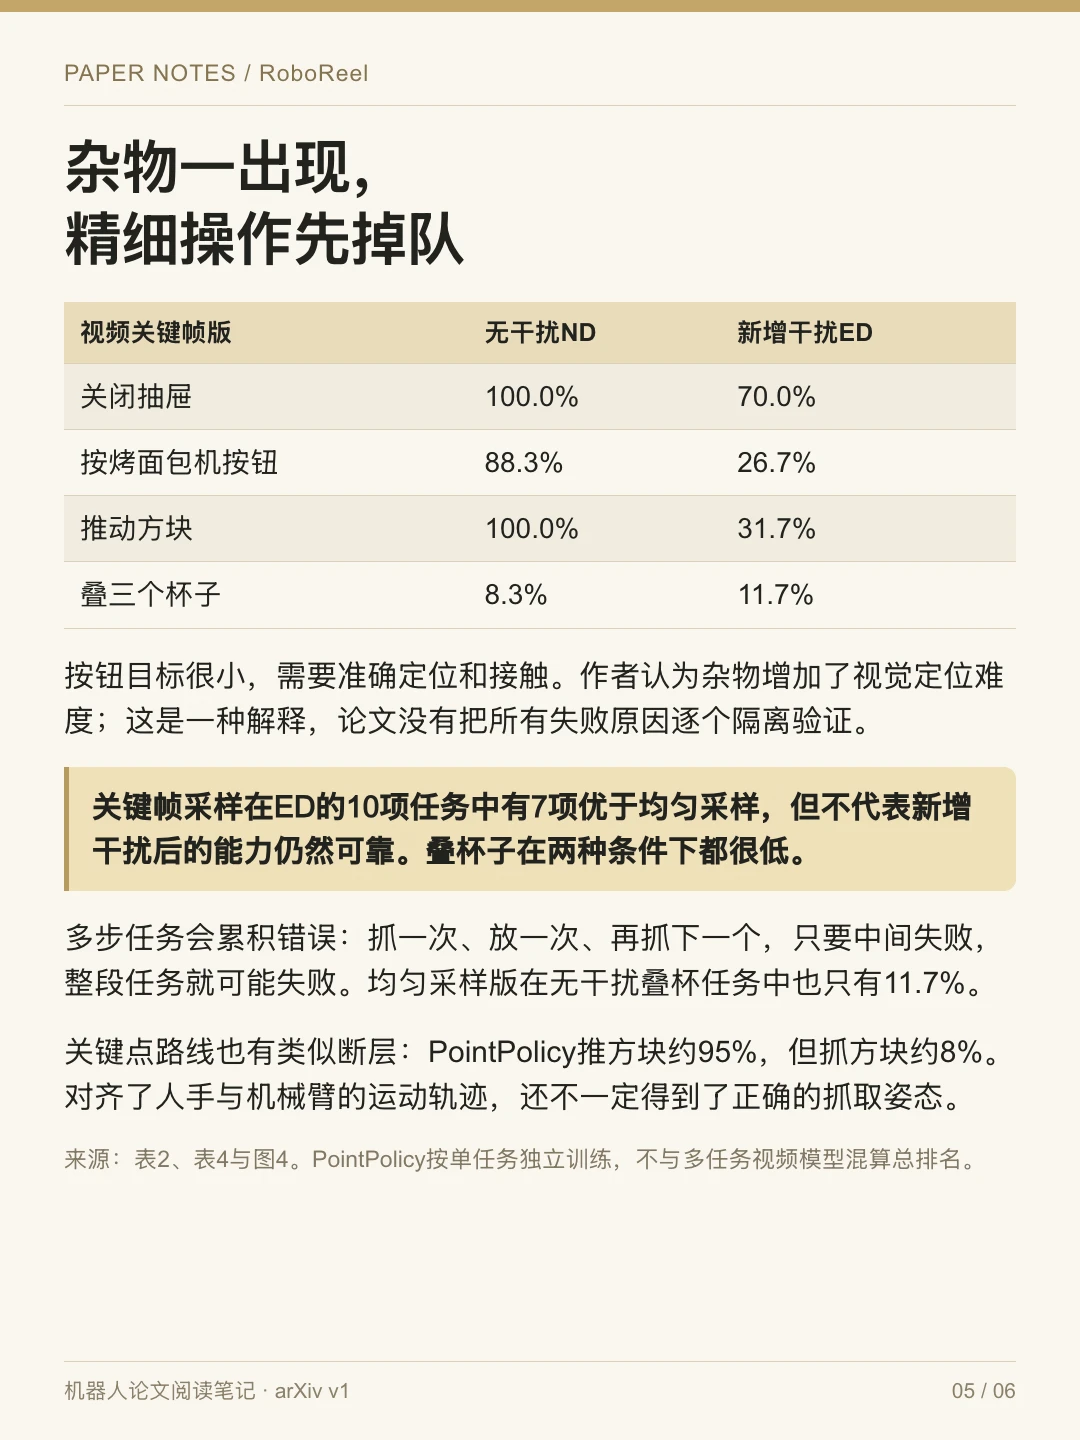
无干扰时,视频条件π0.5关键帧版关闭抽屉100%,叠杯子却只有8.3%。会做一个短动作,离连续做完整件事还有明显距离。
新增干扰后,同一关键帧路线按烤面包机按钮从88.3%降到26.7%,推方块从100%降到31.7%。关键帧在ED的10项任务中有7项优于均匀采样,但整体仍不够可靠。
另一个发现:先把视频总结成语言,再交给π0.5,多项任务弱于直接用视频特征。不过两条路线的训练预算和实现也不同,不能把全部差距都归因于“语言丢信息”。
几个容易误读的点:
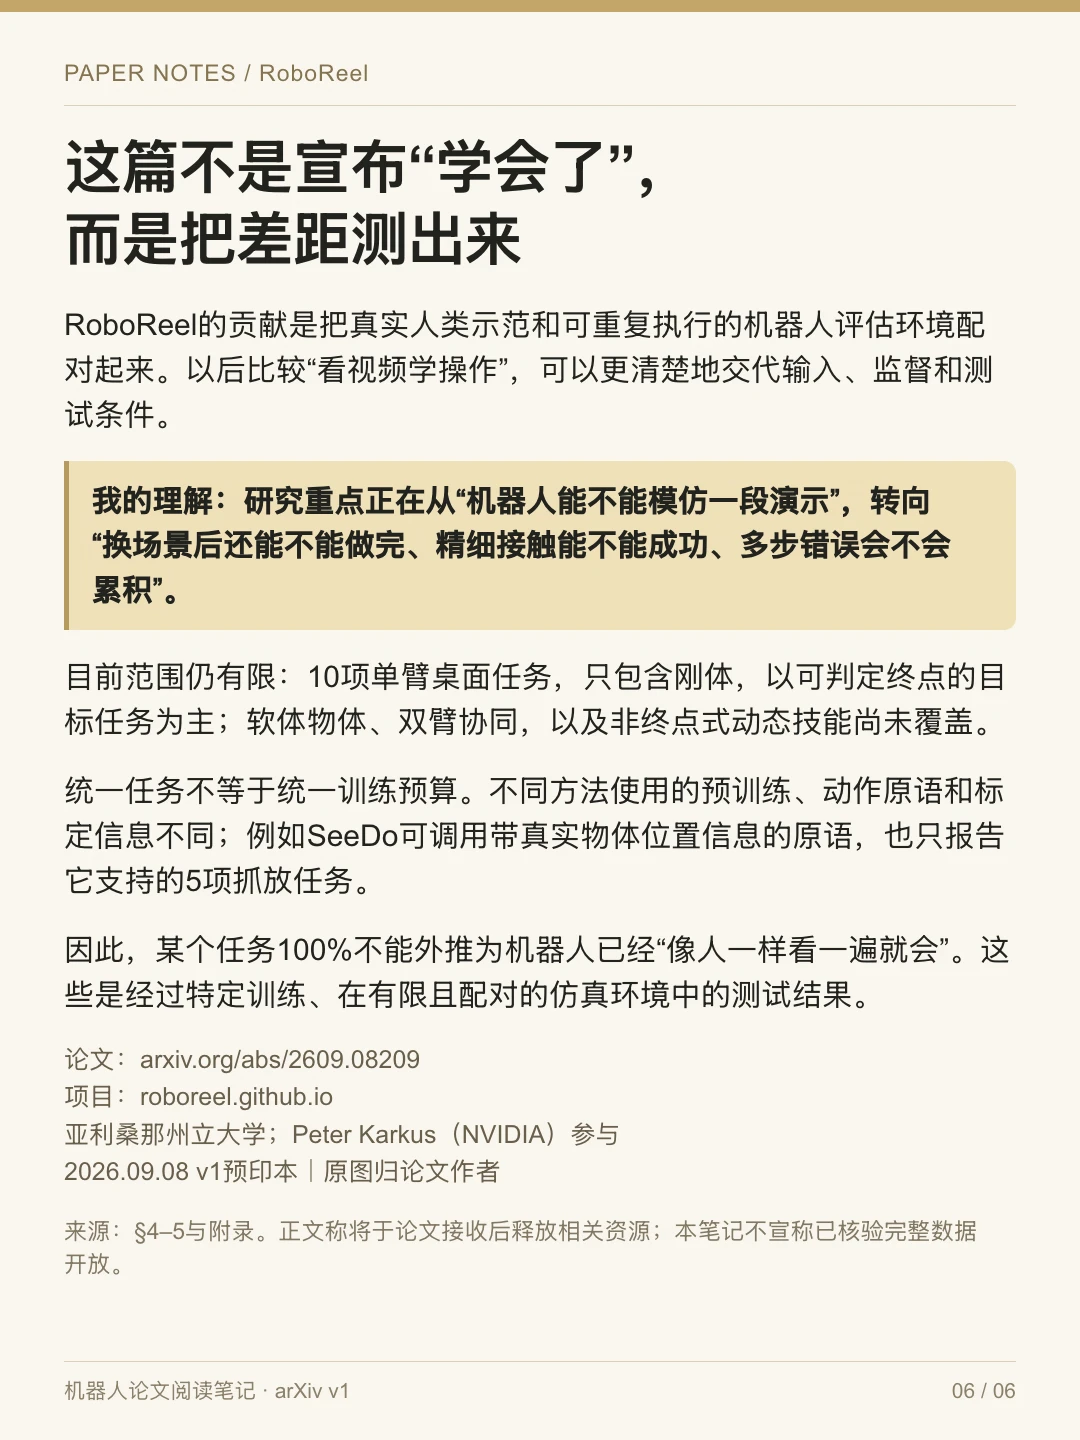
• 人类视频来自真实世界,机器人结果在仿真中评测。
• 多数视频基线还用机器人动作轨迹训练,不是完全只看人类视频。
• 主要协议每格3轮×20次评估,误差不是多个独立训练种子的波动。
• 目前只覆盖单臂、刚体、目标明确的桌面任务。
我更看重这套评测提出的问题:模型能不能抗干扰、完成精细接触,并在多步任务里控制错误累积?
论文:arxiv.org/abs/2609.08209
项目:roboreel.github.io
基于2026.09.08 v1;含论文原图,文字由HTML渲染。
#具身智能 #机器人马拉松 #模仿学习 #视频学习 #论文解读 #人工智能