视频模型能生成“拿起杯子”的画面,机器人就知道该怎么动了吗?OpenWAM把这个问题拆开做了系统实验。
这篇来自新国大、清华、北大等高校的工作,我最想记住3点:
① 一起预测,不等于有效合作。
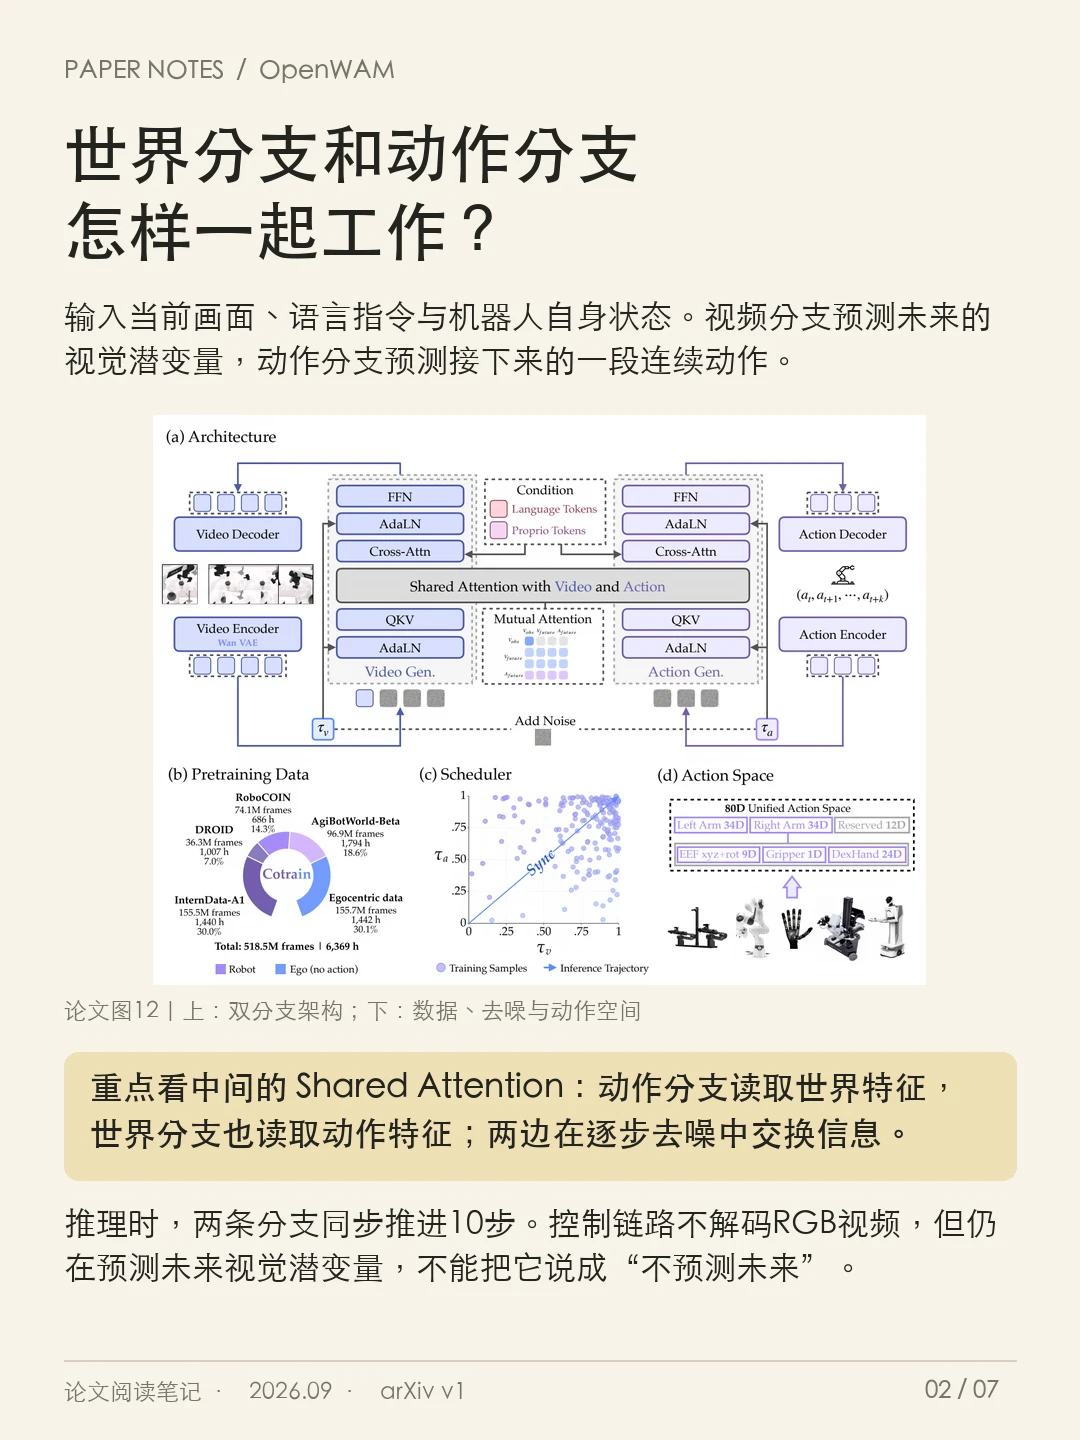
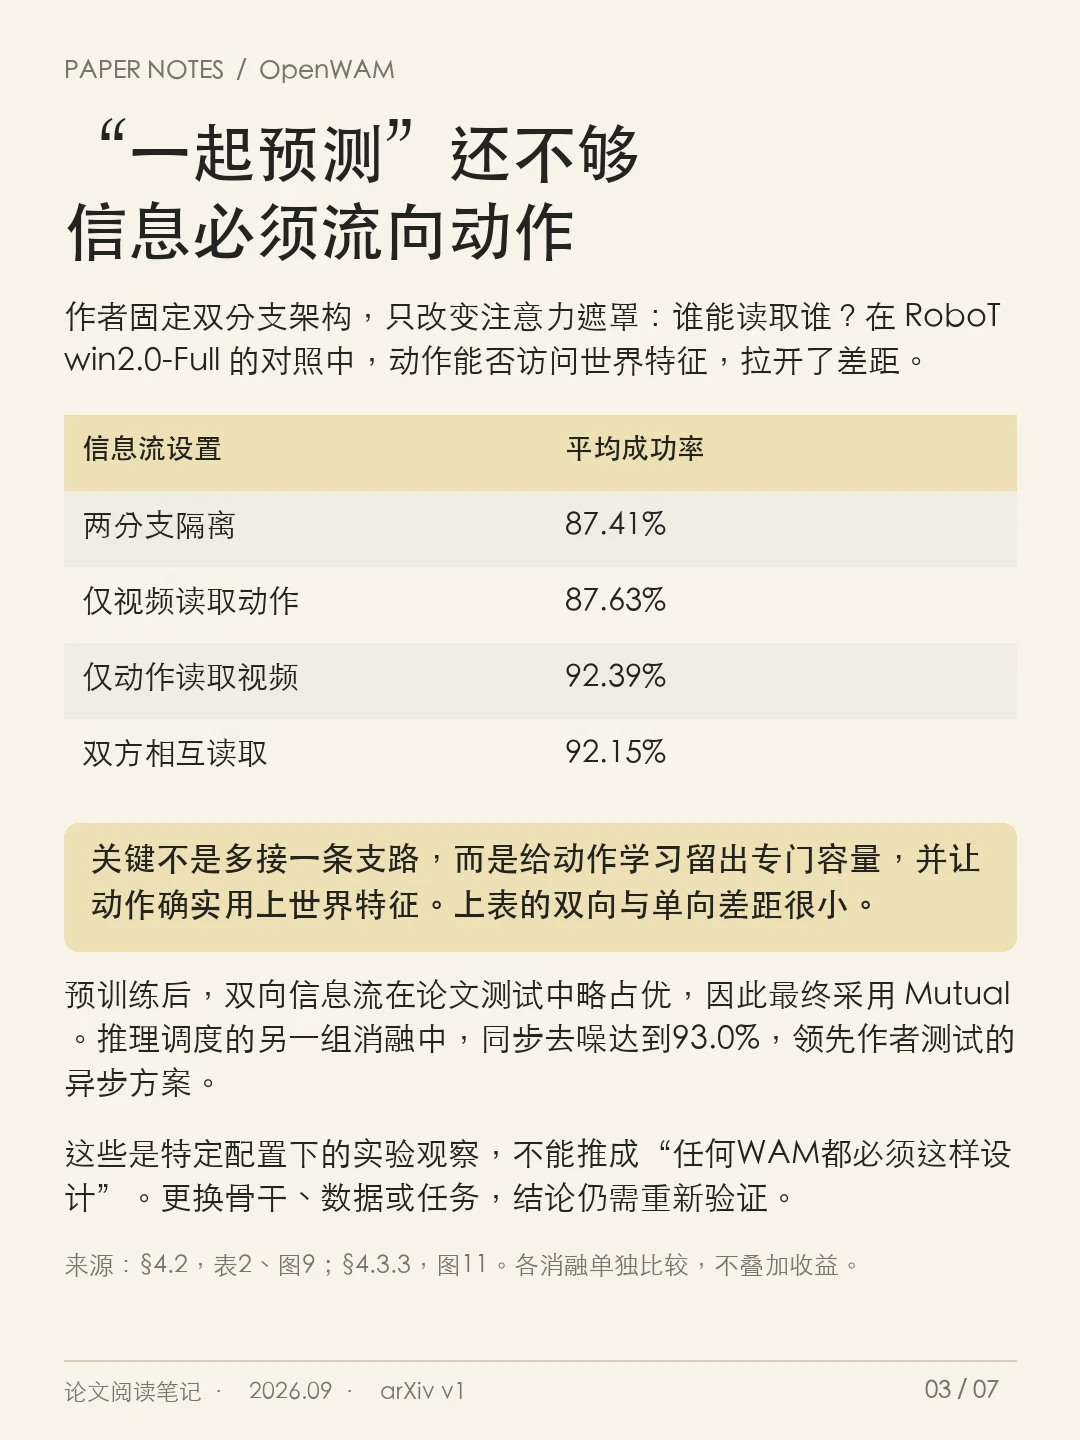
在RoboTwin2.0-Full消融里,两分支隔离时平均成功率87.41%;让动作读取世界特征后达到92.39%。最终方案采用双向注意力,让世界与动作分支同步去噪。
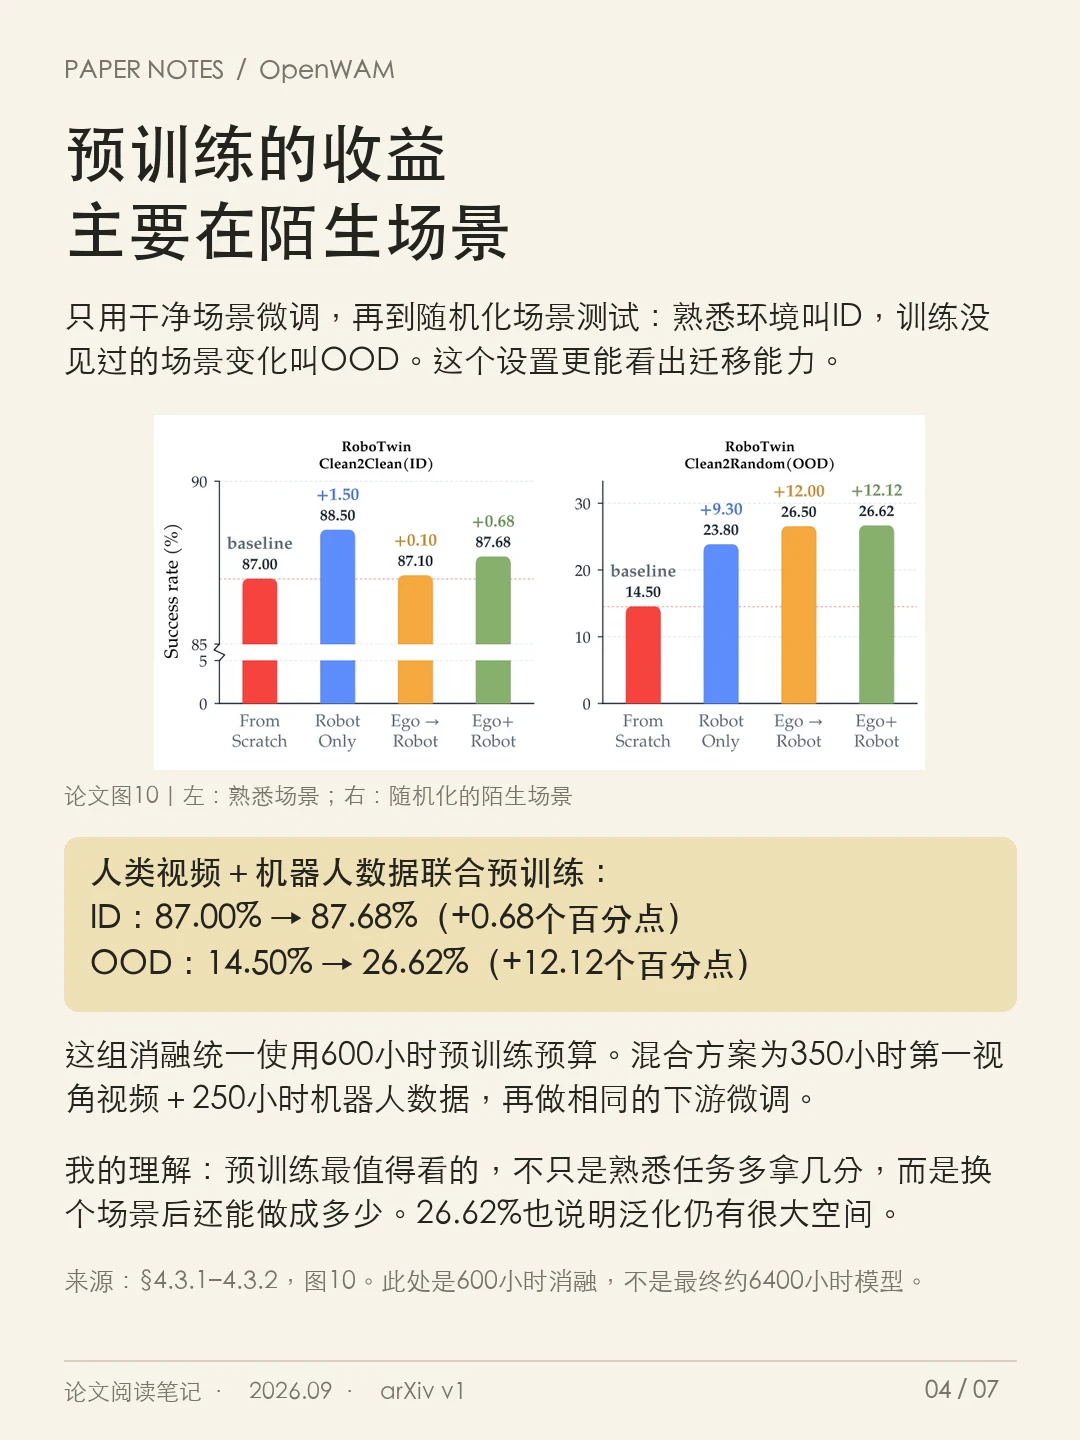
② 预训练更大的收益在陌生场景。
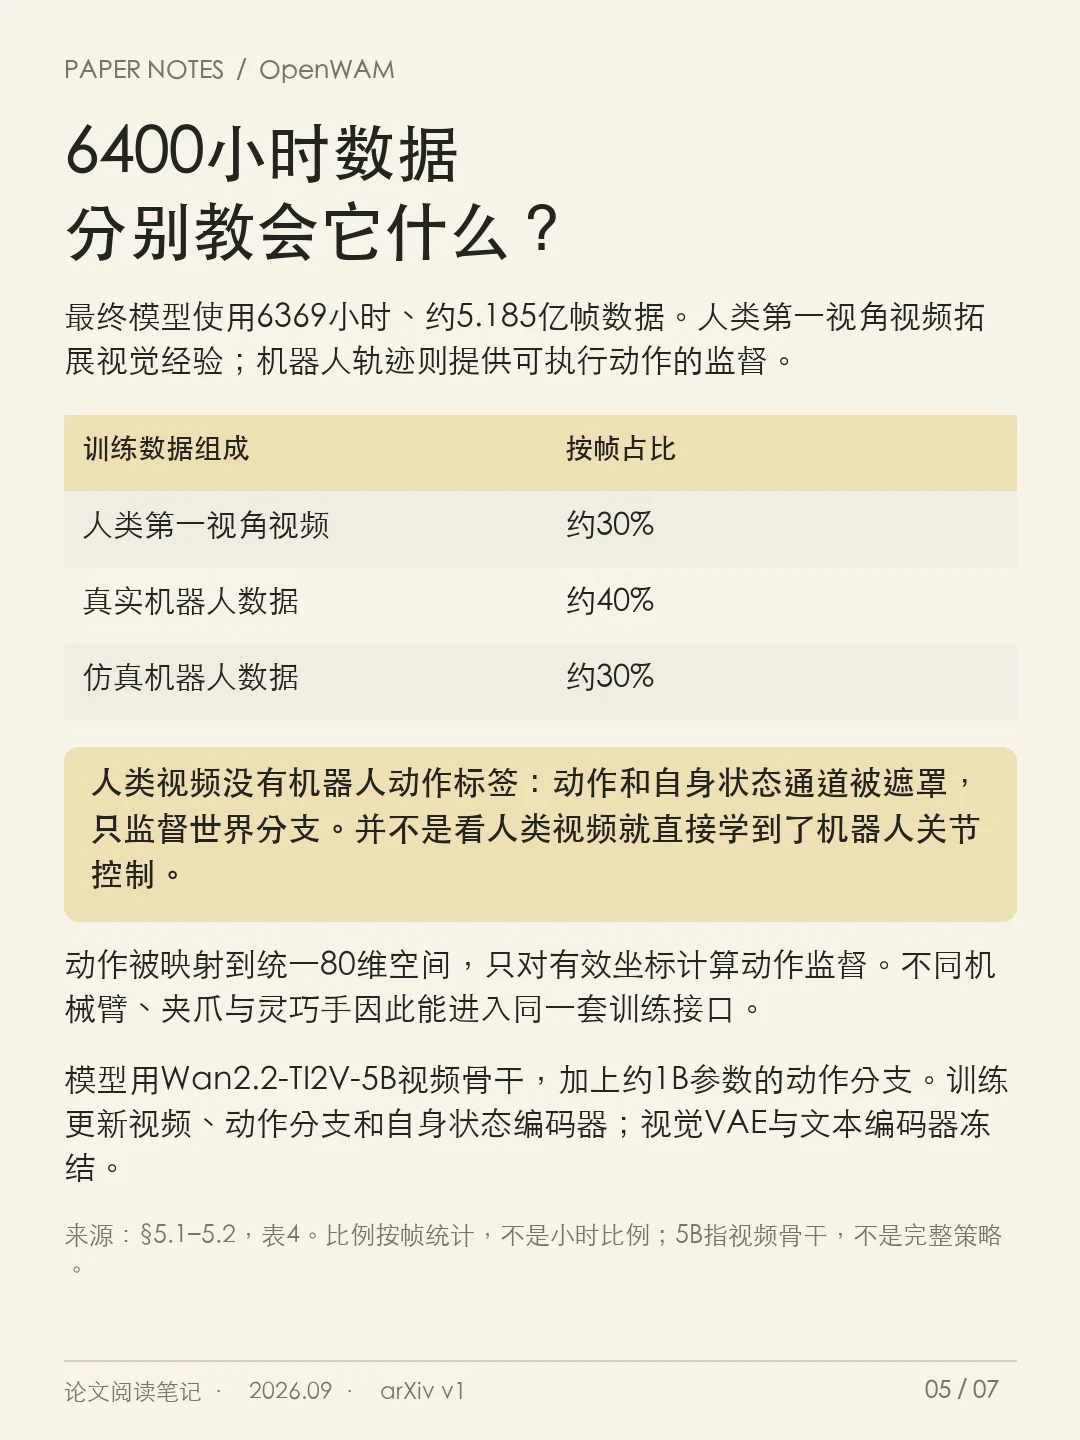
600小时预算的对照中,人类视频+机器人数据联合预训练,让OOD成功率从14.50%升至26.62%,增加12.12个百分点;ID只增加0.68个百分点。这组数字不是最终约6400小时模型的结果。
③ 真机有提升,也要看适用范围。
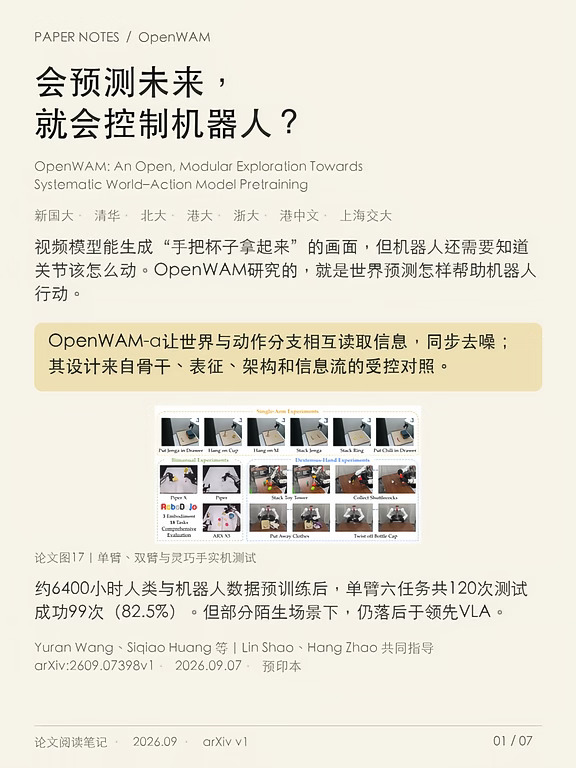
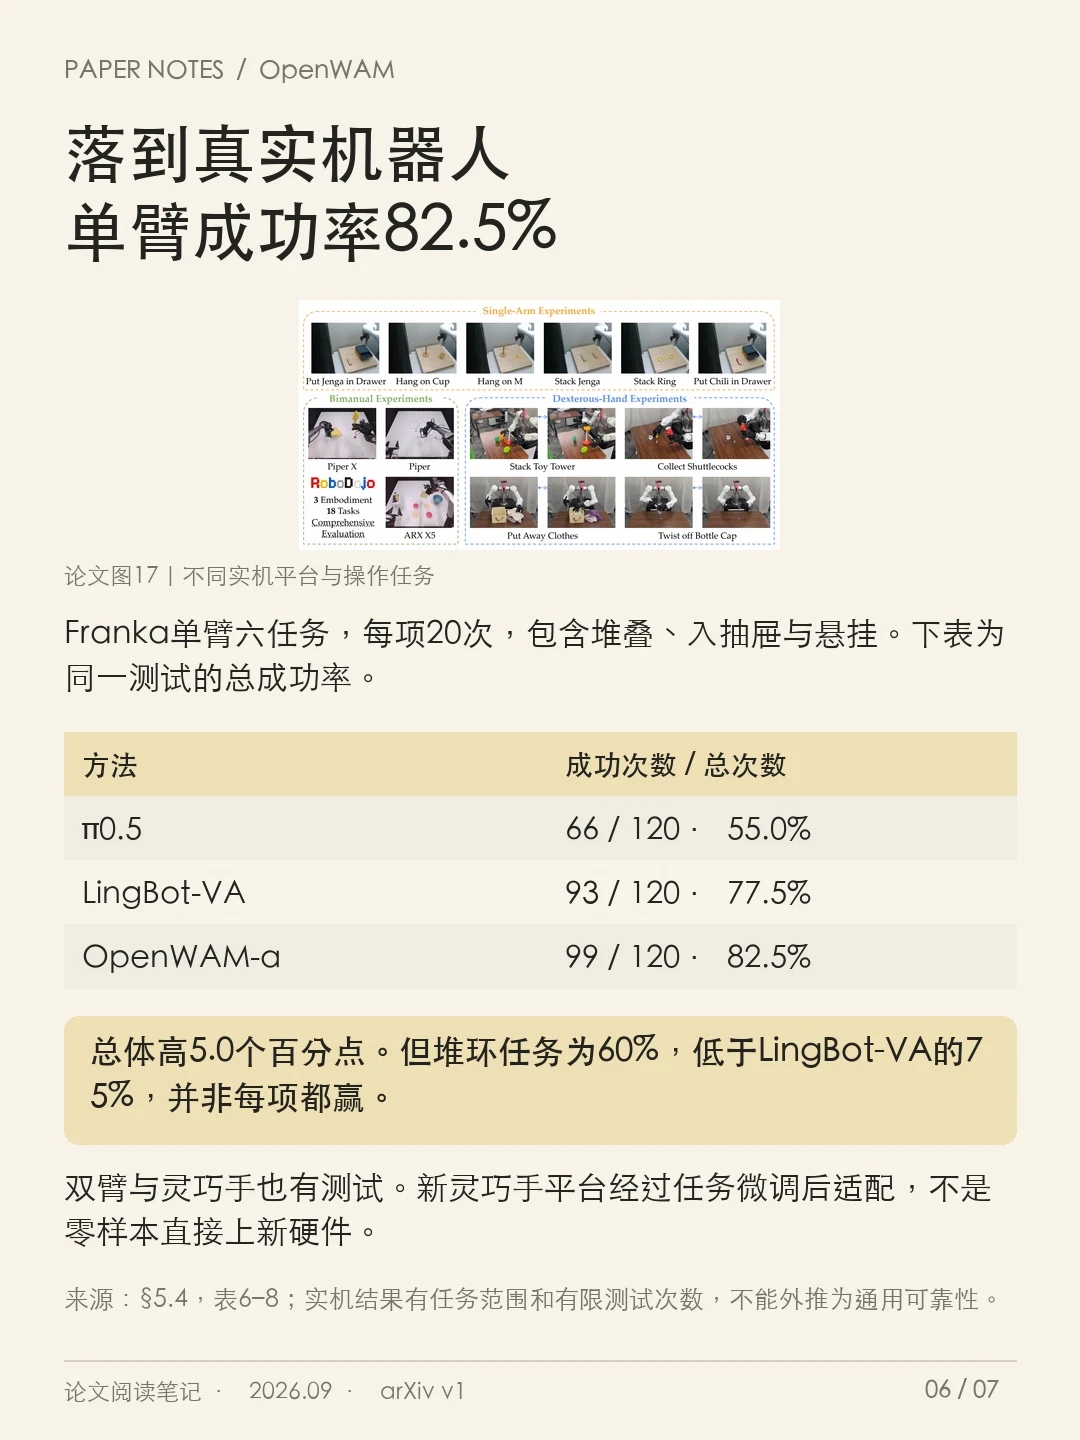
最终OpenWAM-α在单臂六任务、每项20次的测试中,成功99/120次(82.5%),对照LingBot-VA为77.5%。但并非每项任务都领先。
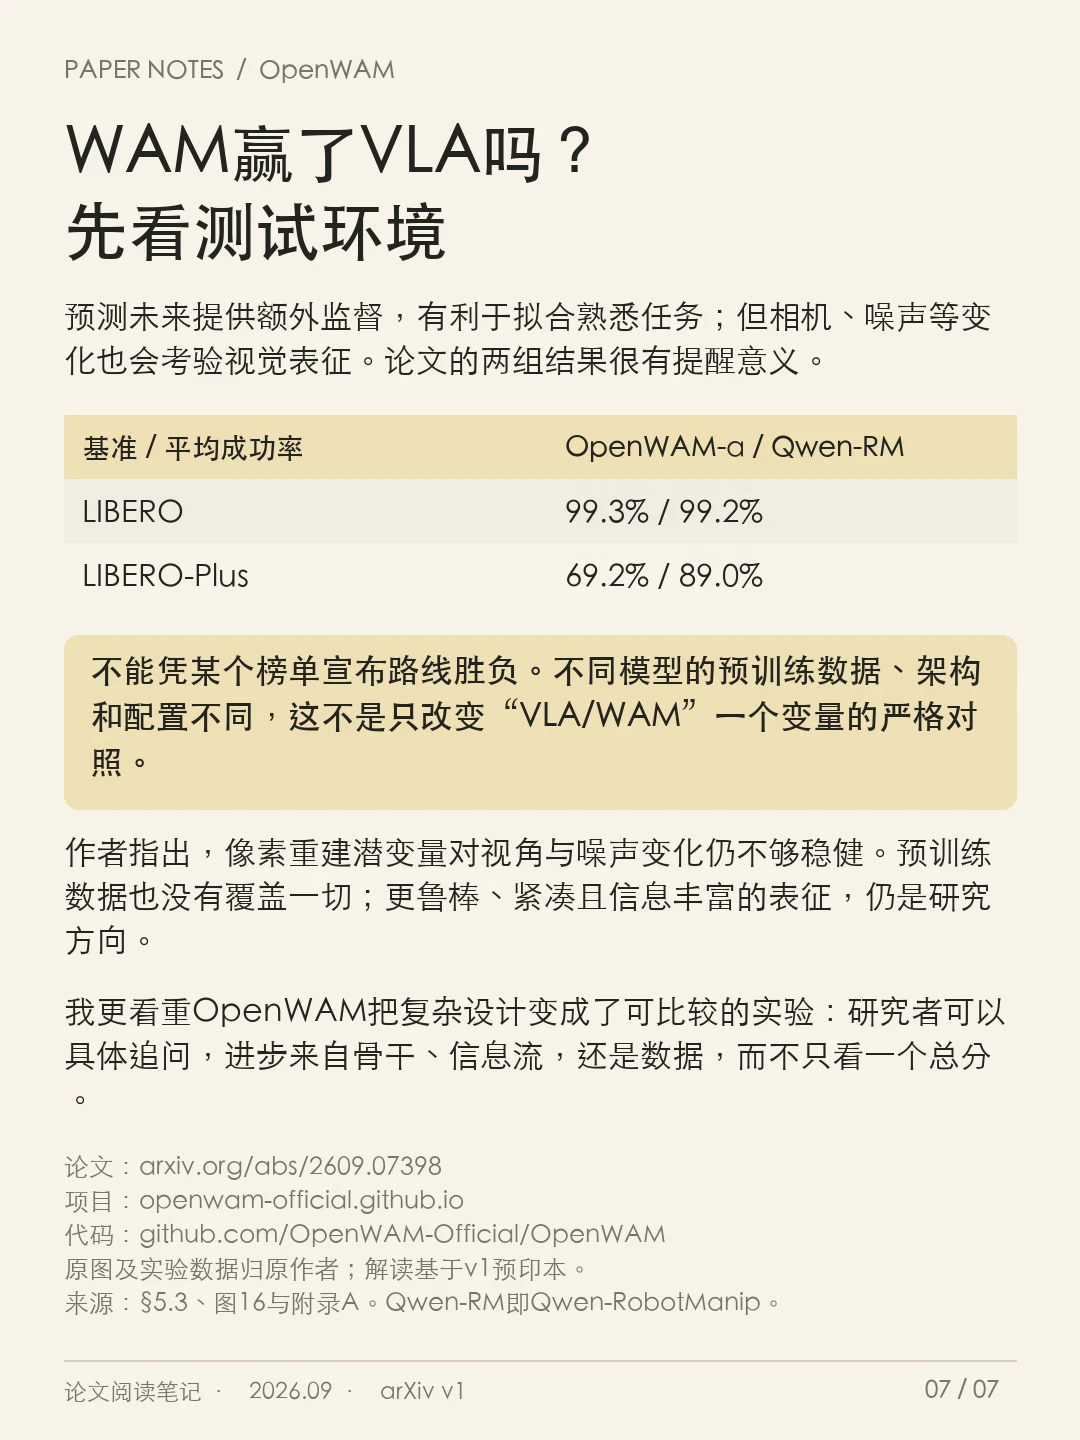
也别急着宣布WAM赢了VLA:论文中LIBERO-Plus的OpenWAM-α为69.2%,Qwen-RobotManip为89.0%。数据与训练设置不同,不能据此简单判定路线优劣。
我更看重它把骨干、表征、信息流和数据配方拆成了可比较的实验。研究WAM,到底该先改模型,还是补数据?
图文含论文原图;解读基于2026年9月7日v1预印本。
论文:arxiv.org/abs/2609.07398
项目:openwam-official.github.io
#具身智能 #机器人马拉松 #世界模型 #论文解读 #人工智能 #OpenWAM