突发!DeepSeek大降价:降幅达60%
刚聊完 DeepSeek 开启 V4.1 Flash 灰度内测,果不其然,官方的正式降价通知就跟着来了。
根据调价公告,北京时间 9 月 10 日中午 12:00 起,Flash 系列全线调整 API 定价
先看具体的闲时价格变动(单位:元/百万 Token):输入(缓存未命中):1.5 元 → 1 元,下调约 33%; 输出:4.5 元 → 4 元,下调约 11%;输入(缓存命中):0.05 元 → 0.02 元,直接暴降 60%!高峰时段价格依然保持为闲时的两倍(对应输入 2 元、输出 8 元、缓存命中 0.04 元)。
不过各位得清醒看待这个“最高降幅 60%”:很多人以为整张账单能直接砍掉大半,其实 60% 的降幅仅仅适用于“缓存命中”的那部分输入。如果你的业务以长输出为主,或者提示词缓存复用率不高,综合账单的实际降幅大概在 15% 到 25% 左右。但对于高频调用、需要反复读取长上下文或大代码库的 Agent 场景来说,2 分钱读 100 万 Token,确实把工程底座的成本又往下压死了一大截。
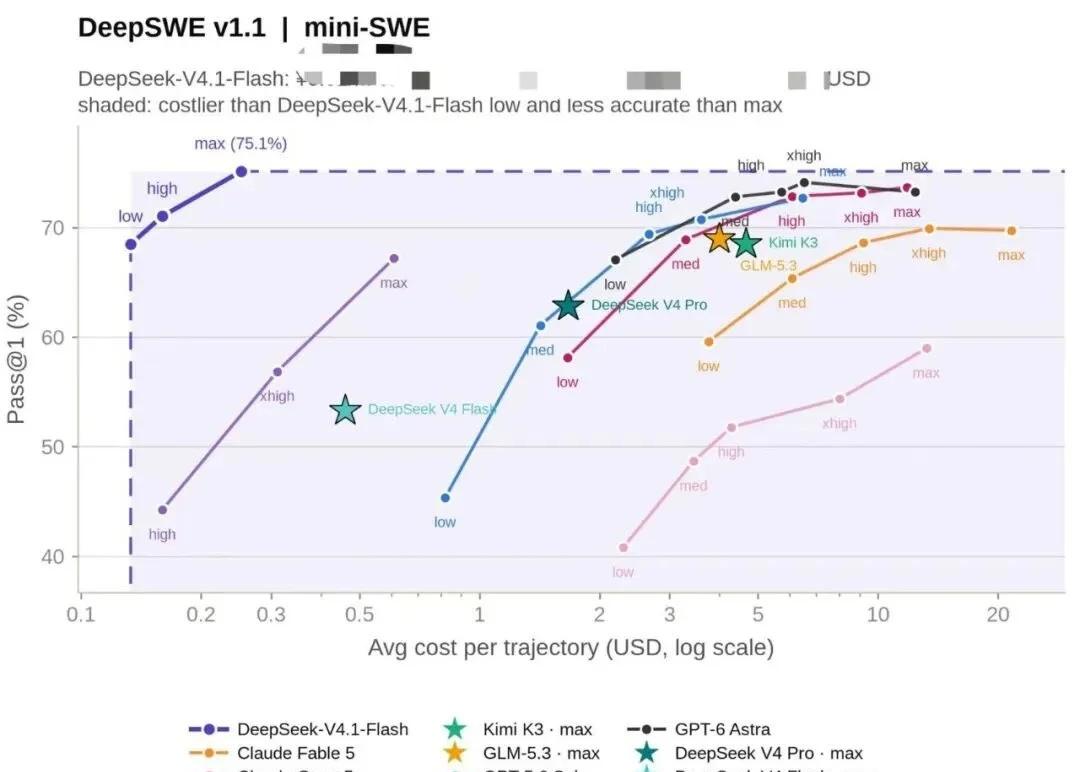
更值得关注的是降价背后配套的跑分图:在软件工程能力 DeepSWE v1.1(mini-SWE)测试中,DeepSeek V4.1-Flash 的 max 档 Pass@1 达到了 75.1%,甚至略微压过了 GPT-6 Astra 与 Claude Opus 5;而在横轴的任务成本上,单次尝试仅约为 0.25 美元。相比 GPT-6 Astra 单次任务 5 到 15 美元的开销,它几乎在保持第一梯队解题率的同时,把成本拉到了其他旗舰模型的几十分之一。
把原本昂贵的长程工程交付,打到几毛钱一次,这才是国内大模型最具穿透力的打法。接下来就看 9 月 10 号转正上线后,在真实写代码场景下能不能完全兑现这个跑分了。
PS:两分钱读一百万 Token 的缓存,以后做 Agent 传几十 K 的规则文件是真不需要心疼了🤣
DeepSeek 深度求索 大模型 人工智能 API 开发日常 AI降价 AI编程 科技资讯 @科技薯