DeepSeek V4.1 Flash 发布,更强、更快也更省~
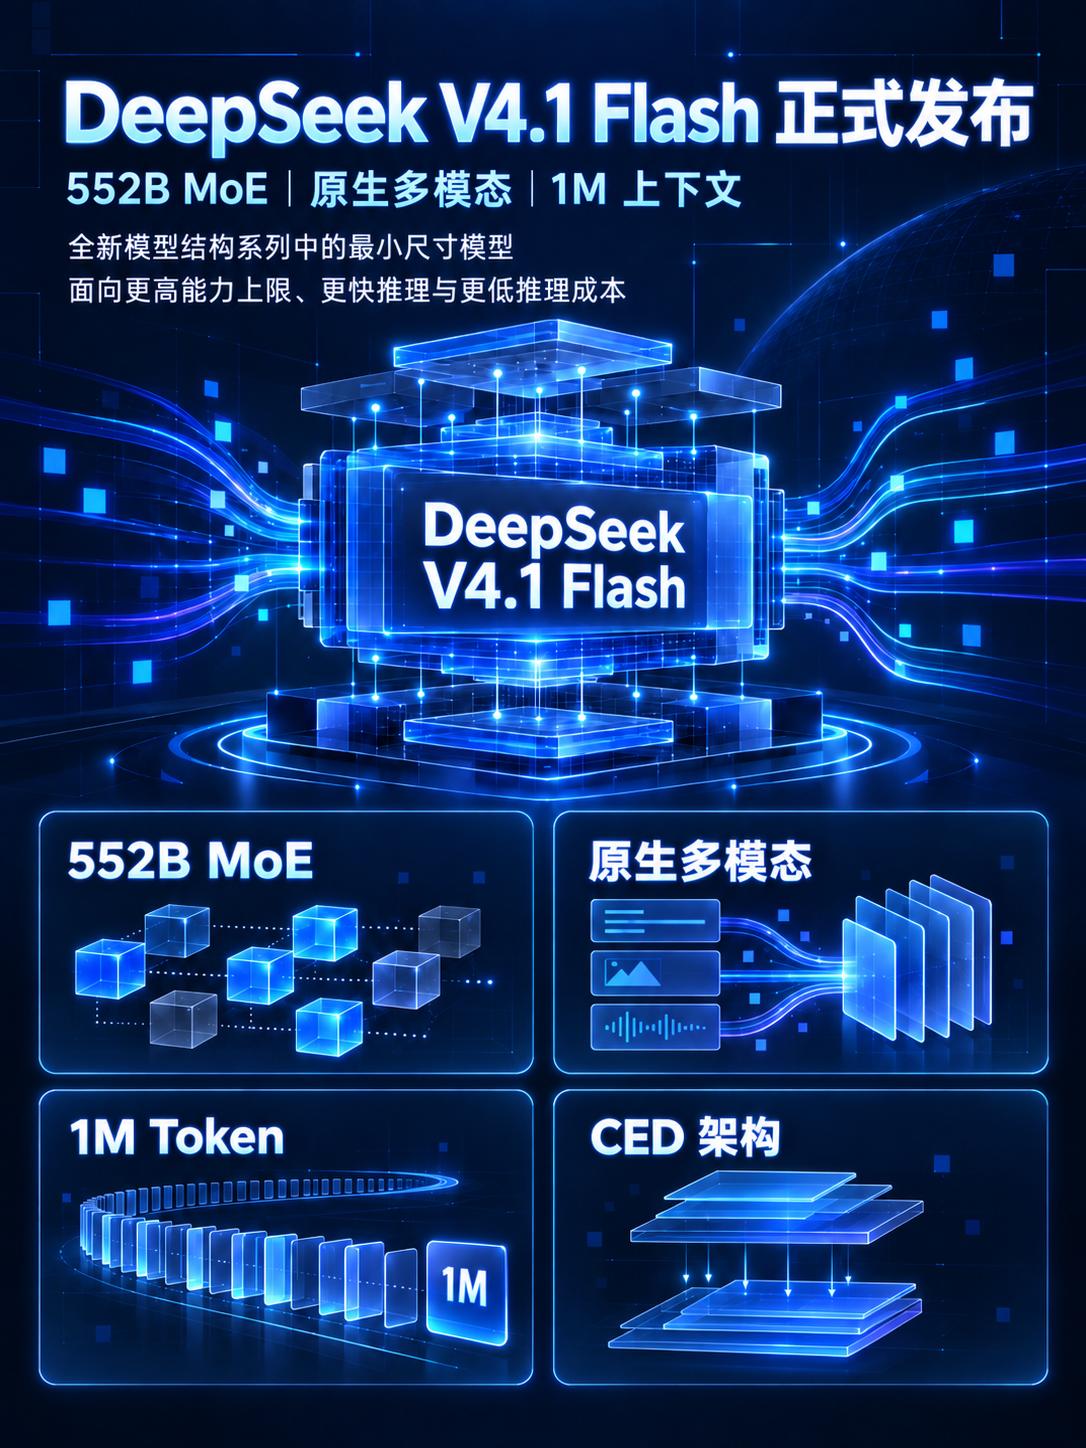
DeepSeek 正式发布 DeepSeek V4.1 Flash。这是其全新模型结构系列中的最小尺寸模型,采用 552B MoE,并原生支持图像与文本输入,最长上下文达到 1M Token。
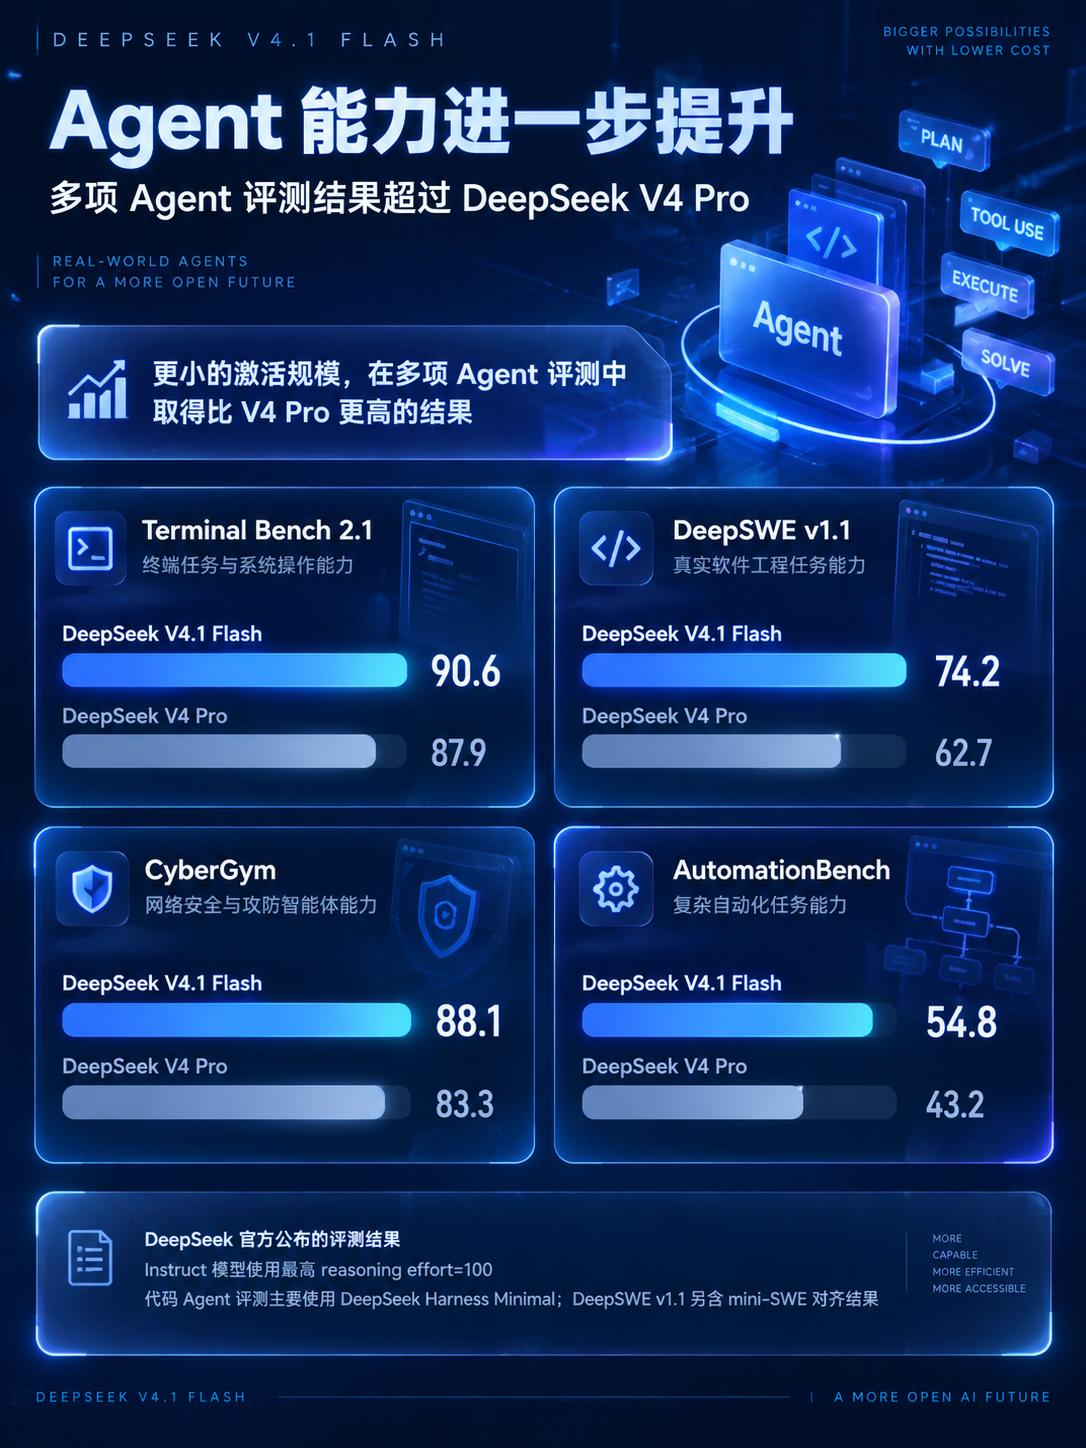
这次升级的重点之一是 Agent 能力。DeepSeek 公布的评测结果中,V4.1 Flash 在多项 Agent Benchmark 上高于 V4 Pro:
Terminal Bench 2.1:90.6 vs 87.9
DeepSWE v1.1:74.2 vs 62.7
CyberGym:88.1 vs 83.3
AutomationBench:54.8 vs 43.2
相关 Instruct 评测使用最高 reasoning_effort=100,不同 Benchmark 按对应 Harness 进行测试。
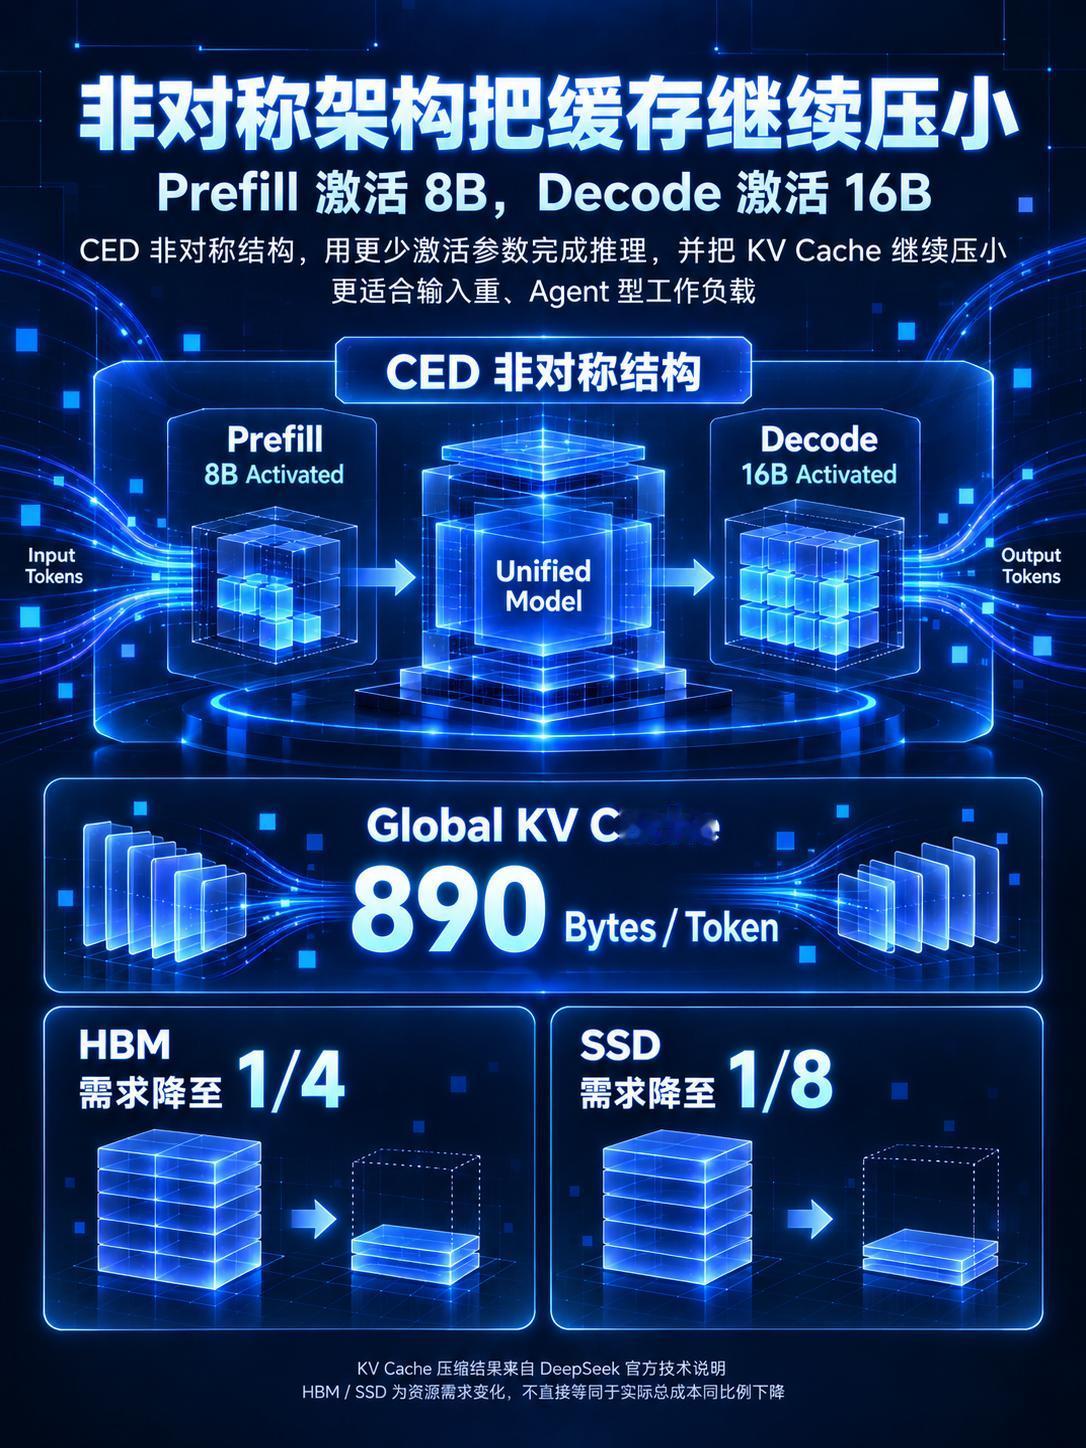
这次更新的重点还在于新的 Causal Encoder-Decoder(CED)非对称架构。V4.1 Flash 在 Prefill 阶段每个 Token 只激活 8B 参数,Decode 阶段激活 16B;结合新的缓存设计,Global KV Cache 被压缩到 890 Bytes / Token。相比上一代,HBM 需求降至 1/4、SSD 需求降至 1/8;相比 DeepSeek V1,KV Cache 已降至约 1/437。
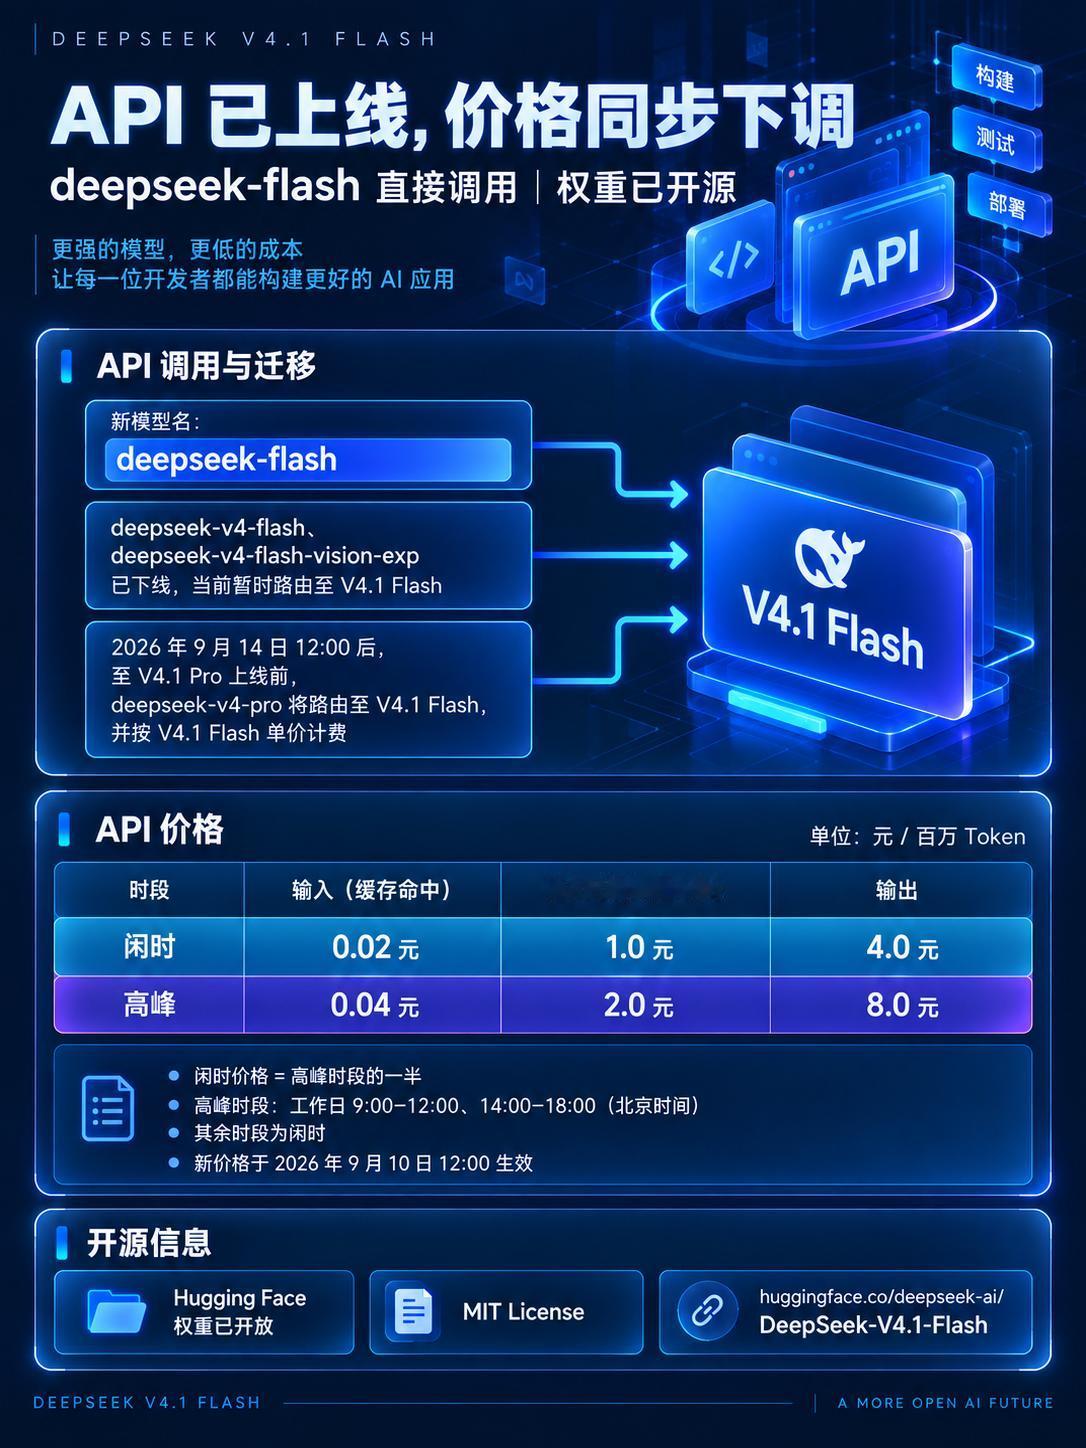
V4.1 Flash 已同步上线 DeepSeek API,新模型名为 deepseek-flash。API 继续采用峰谷定价:闲时缓存命中输入 0.02 元、未命中输入 1 元、输出 4 元 / 百万 Token,高峰价格为对应的两倍。9 月 14 日 12:00 后,在 V4.1 Pro 上线前,deepseek-v4-pro 请求也将暂时路由至 V4.1 Flash,并按其单价计费。
模型权重现已在 Hugging Face 开放,采用 MIT License。DeepSeek 还表示将继续支持社区进行推理适配。
DeepSeek 大模型 Agent AIAgent AI编程 多模态 KVCacheMoE