通用存内计算加速器:用能效换全域通用性
2026顶会硬核芯片创新!IEEE JSSC S-TOP重磅论文
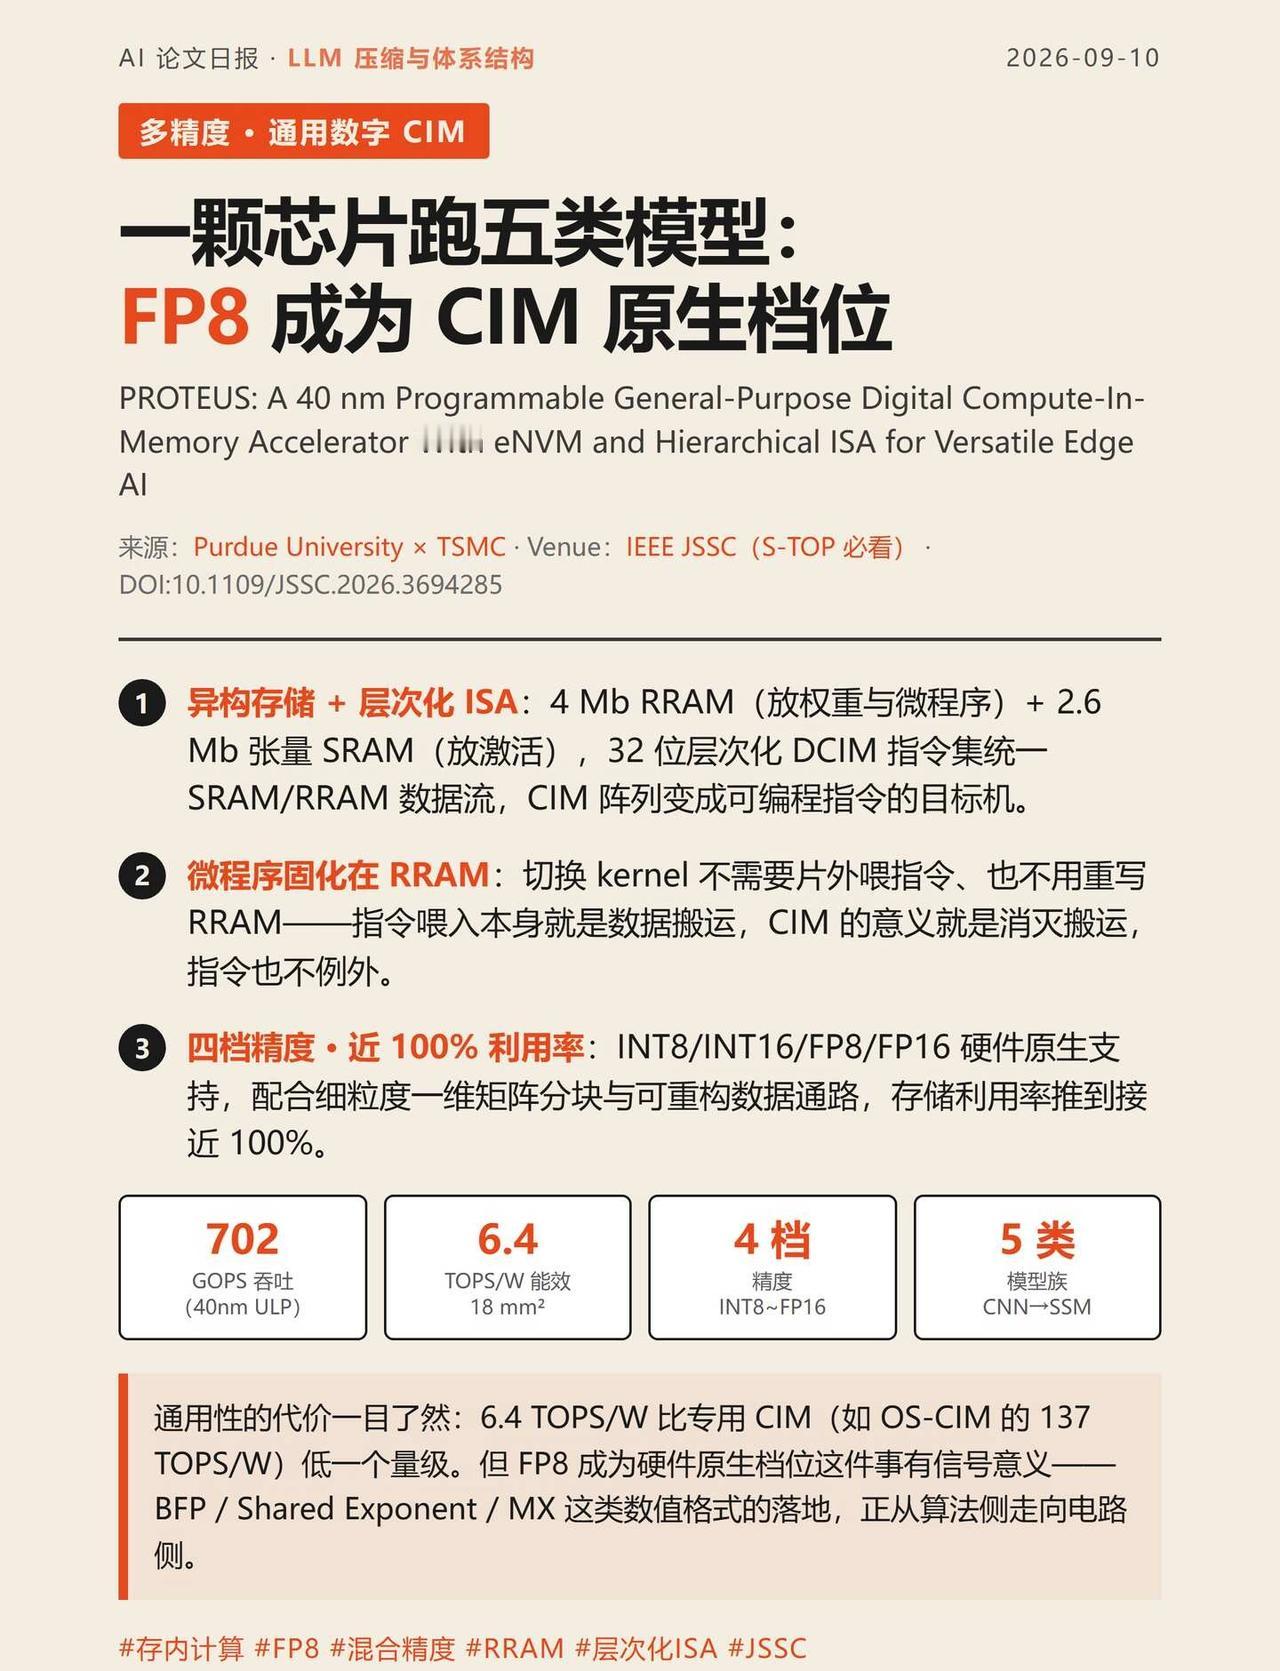
《PROTEUS: A 40 nm Programmable General-Purpose Digital Compute-In-Memory Accelerator With eNVM and Hierarchical ISA for Versatile Edge AI》,普渡大学×台积电联合研发PROTEUS可编程数字存内计算加速器
💡 核心一句话结论
PROTEUS靠层次化ISA统一双存储数据流+RRAM固化微程序+细粒度分块,实现五类主流AI模型族全覆盖,彻底打破传统CIM加速器单模型局限;代价是能效6.4 TOPS/W,远低于专用型存内计算方案,是一次典型的「通用性换能效」精准取舍。
🔧 三大核心技术创新
▪️ 通用异构CIM架构:4Mb RRAM+2.6Mb张量SRAM双存储搭配,自研32位层次化指令集,将存内计算阵列操作转为可编程指令,适配多场景AI任务
▪️ RRAM非易失微程序驻留:模型内核无需外部指令加载、无需重复改写存储,完美规避指令带宽瓶颈与RRAM写入寿命难题
▪️ 细粒度分块+可重构通路:存储利用率逼近100%,原生支持INT8/INT16/FP8/FP16四档精度,覆盖边缘AI全精度部署需求
📊 通用VS专用CIM核心差距
传统专用加速器(OS-CIM/SERAH-CIM):极致能效(最高137.2 TOPS/W),但仅支持INT8单精度、只能跑单一模型,通用性极差
PROTEUS全新突破:能效降至6.4 TOPS/W(受40nm工艺制约),但独家适配SSM、GNN等小众模型,填补了专用CIM无法高效运行的场景空白
✨ FP8原生支持:边缘AI部署关键突破
区别于行业软件模拟FP8的方案,PROTEUS实现硬件原生FP8档位!
针对注意力层、残差分支等INT8量化精度崩盘的场景,可直接切换FP8精度,把量化预算留给低敏感层,为边缘端混合精度部署提供核心硬件支撑,解决量化落地痛点。
🚀 未来迭代方向
新增BFP/MX共享指数精度档位、打通PyTorch量化框架、迁移22/28nm先进工艺、适配LLM解码KV Cache管理,全方位补齐大模型落地能力。
AI芯片 存内计算 CIM 顶会论文 JSSC 普渡大学 台积电 边缘AI 大模型技术