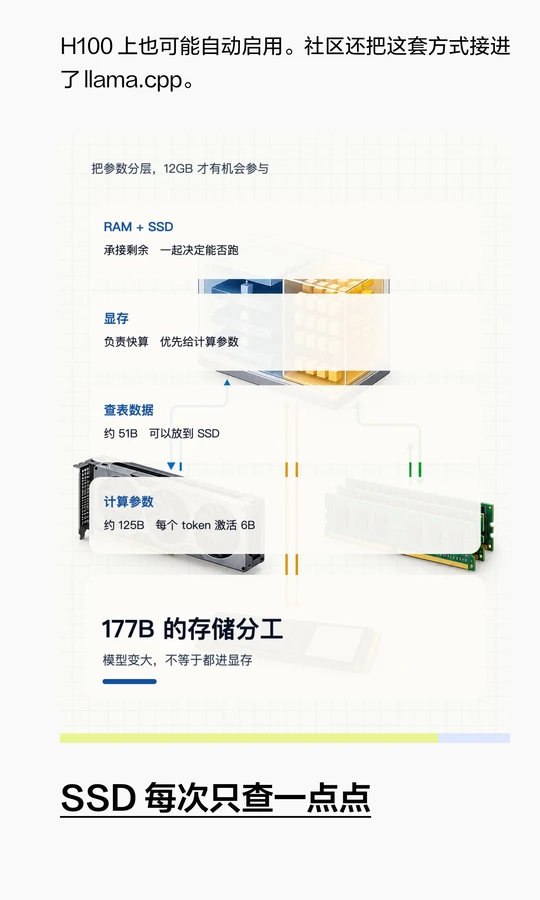
177B落到12GB,靠存储分层。
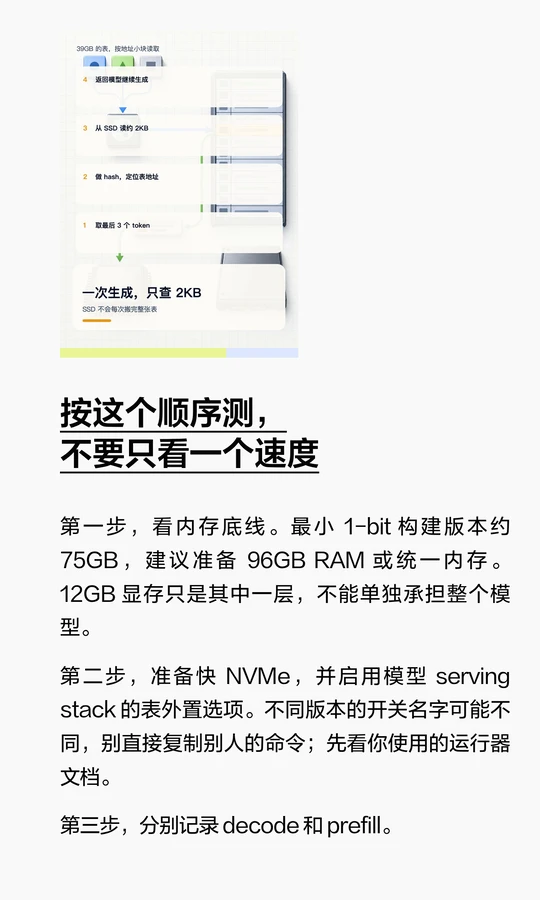
125B是混合专家,每token激活6B;51B是查表数据,放SSD,每次只读2KB。
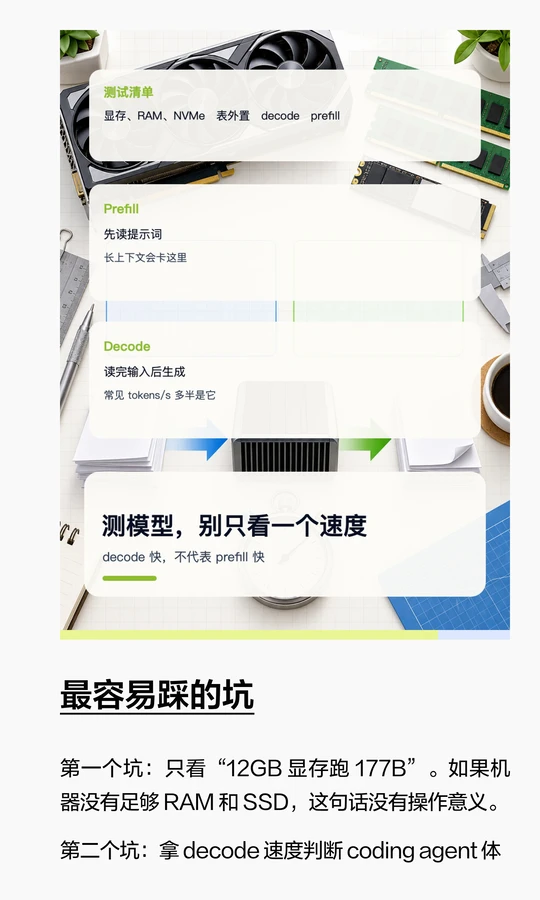
别只看decode:它负责生成;prefill负责先读提示词和代码库。24.4 tokens/s多半是decode,32k tokens按50 tokens/s要10分40秒。
实测:准备RAM/统一内存和快NVMe,启用表外置,分开记录decode与prefill。RAID SATA不一定有用,更看延迟。
本地跑批量任务;云端跑长上下文和即时回复。
#本地大模型 #LLM #显卡折腾 #机器学习 #技术避坑 #AI工具 #howto入门codex #howto入门vibecoding #AI编程 #ClaudeCode