动态Token长视频大模型不再均匀抽帧
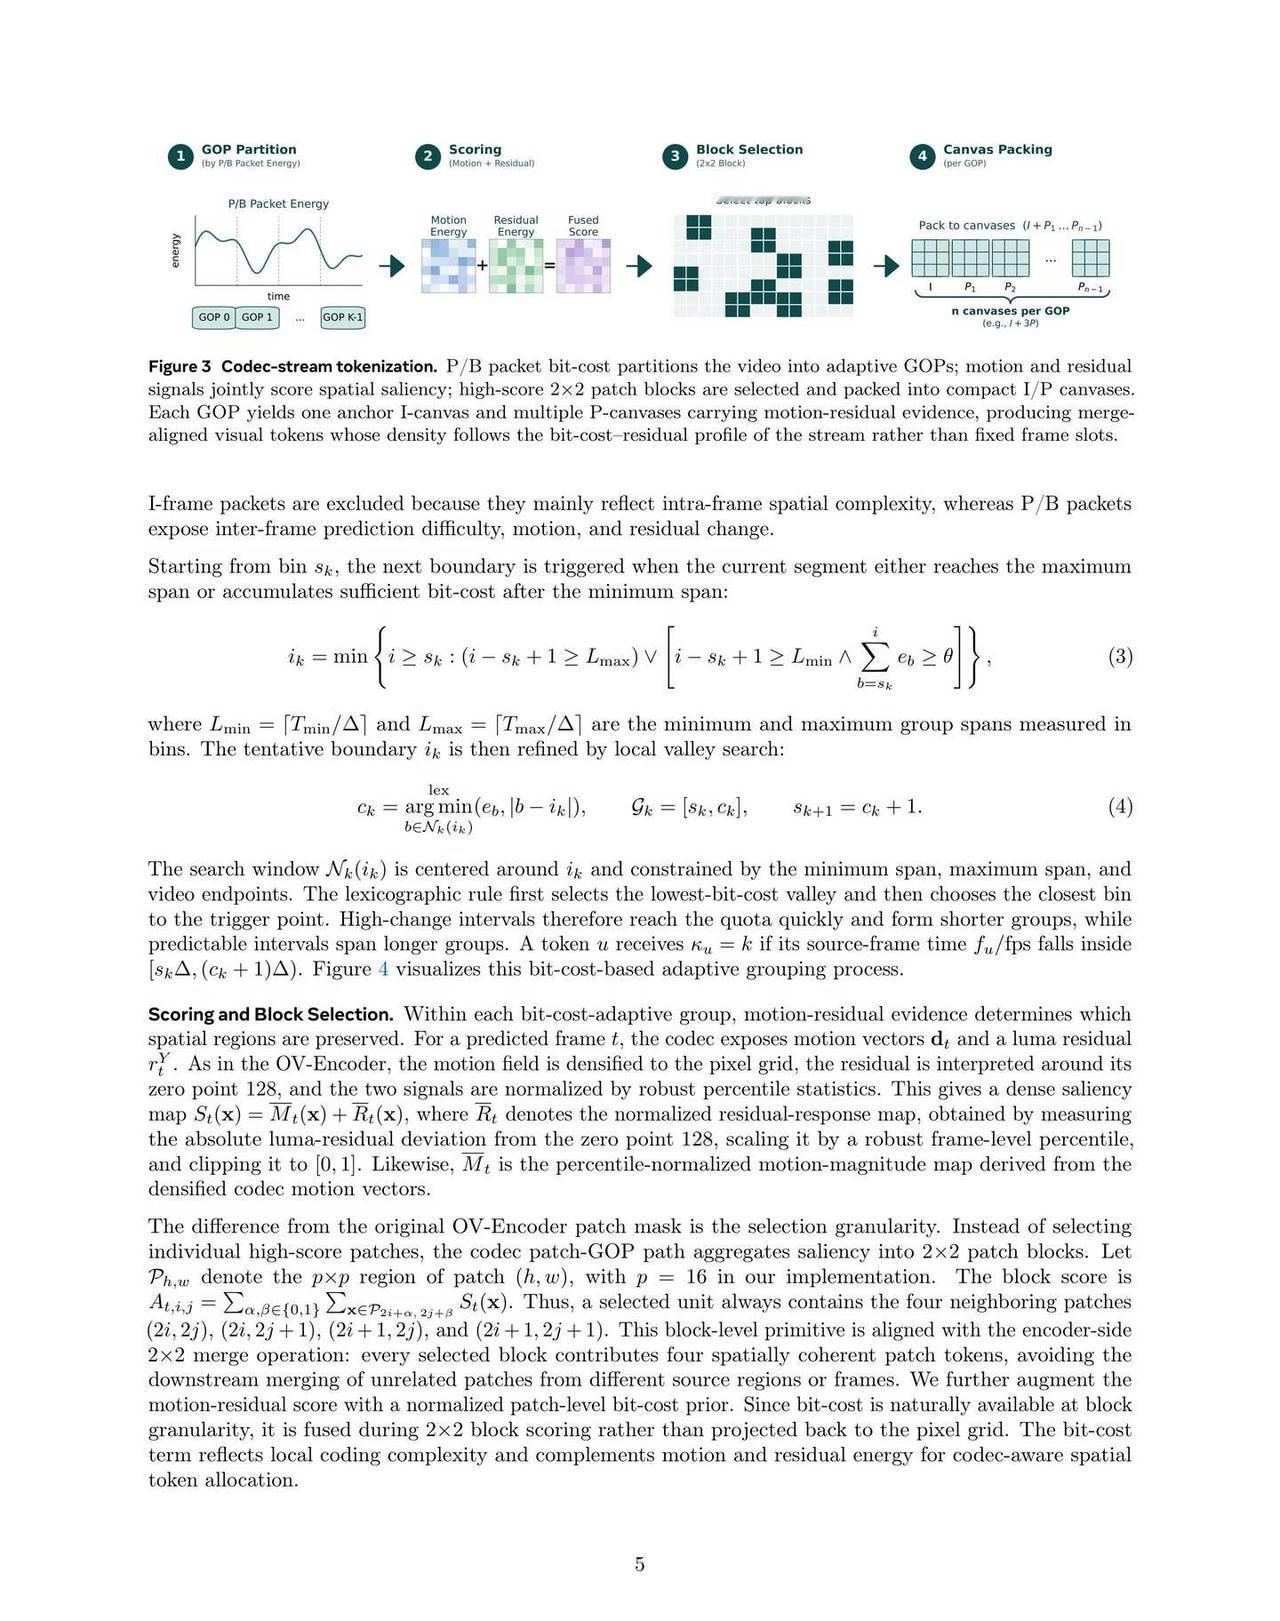
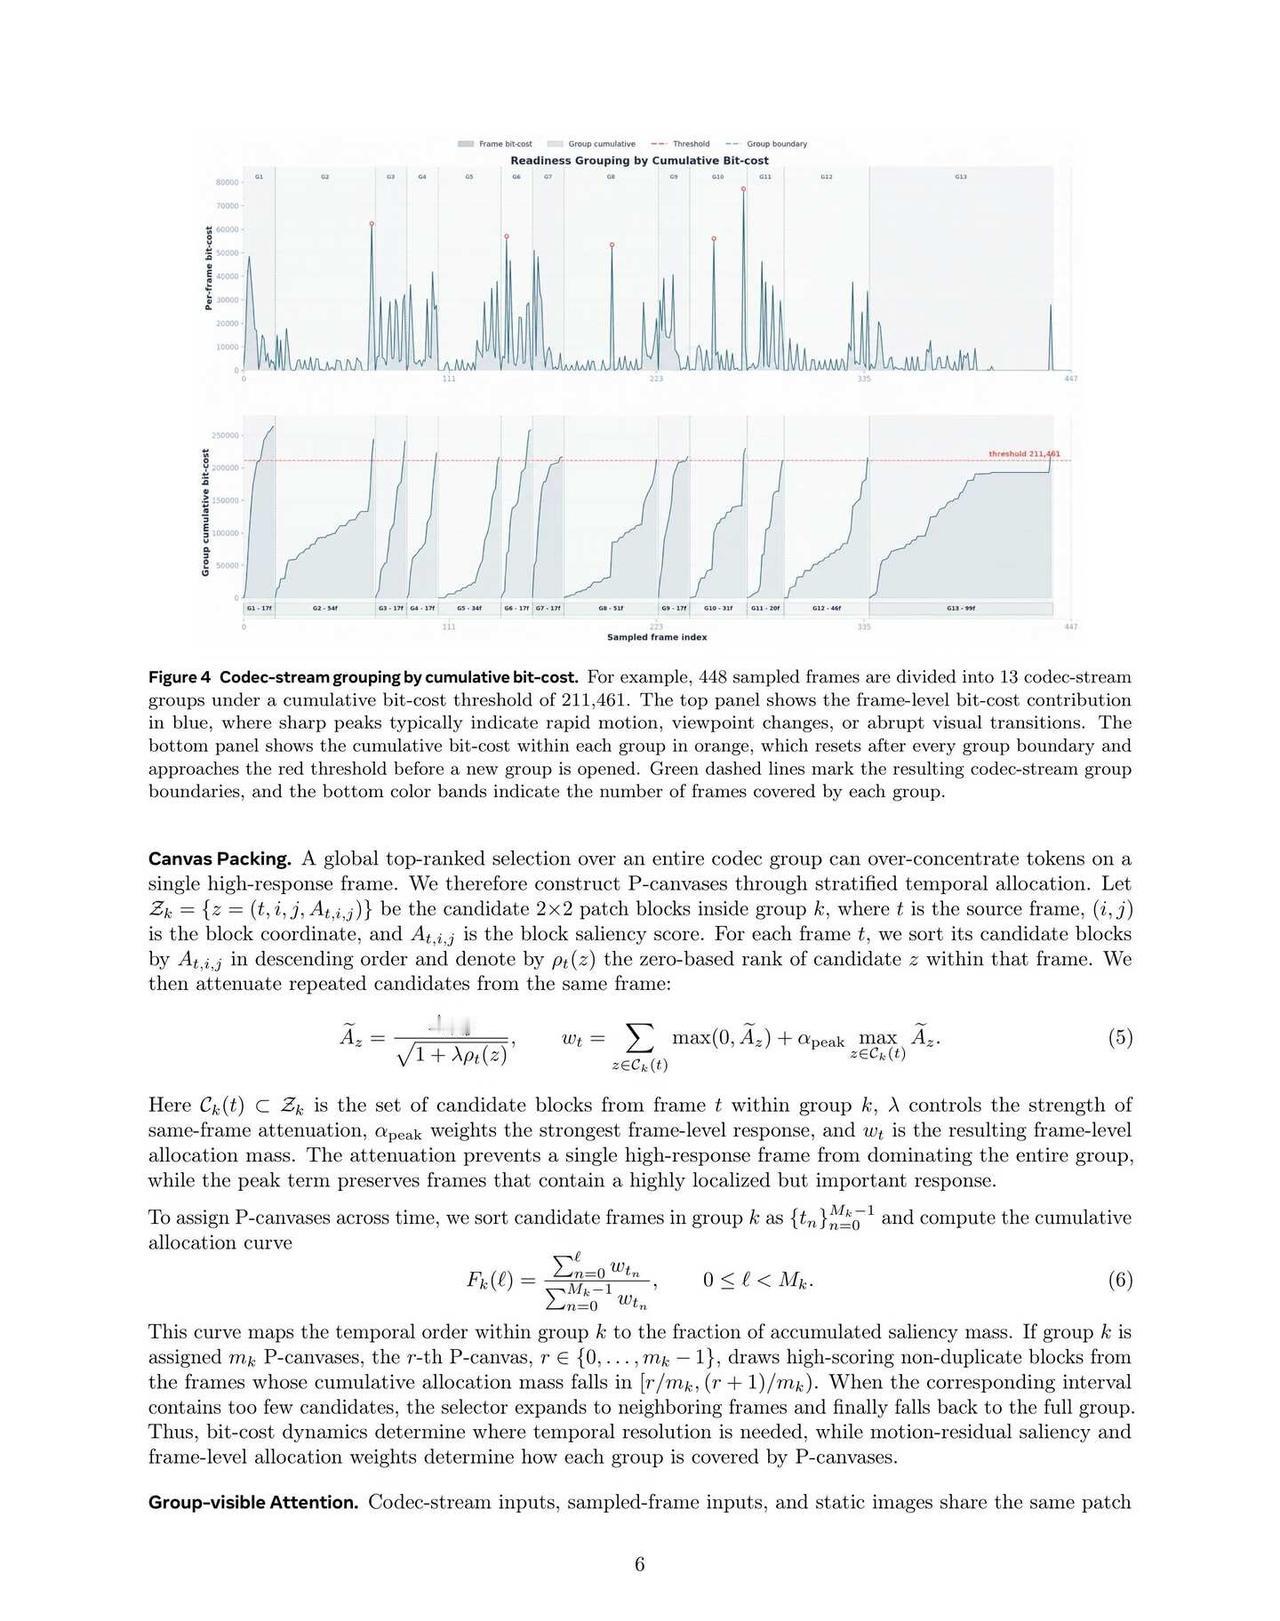
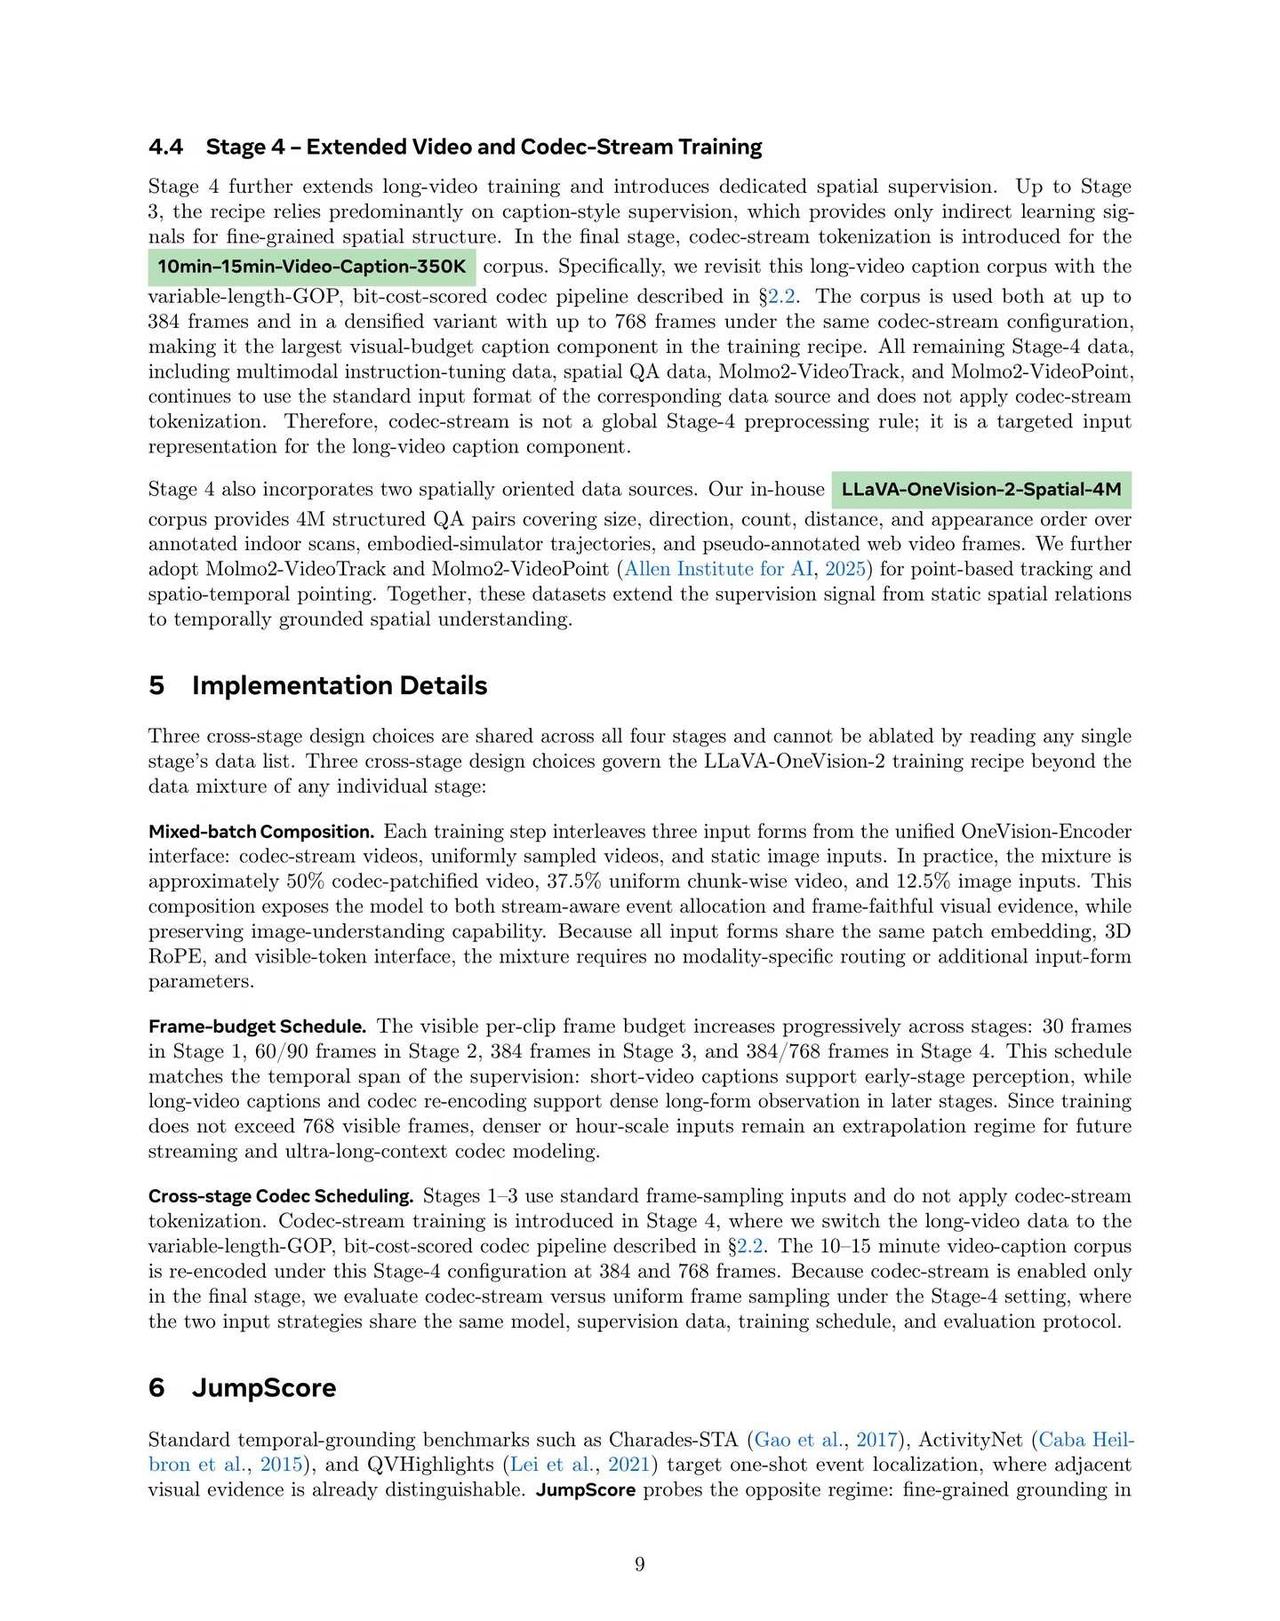
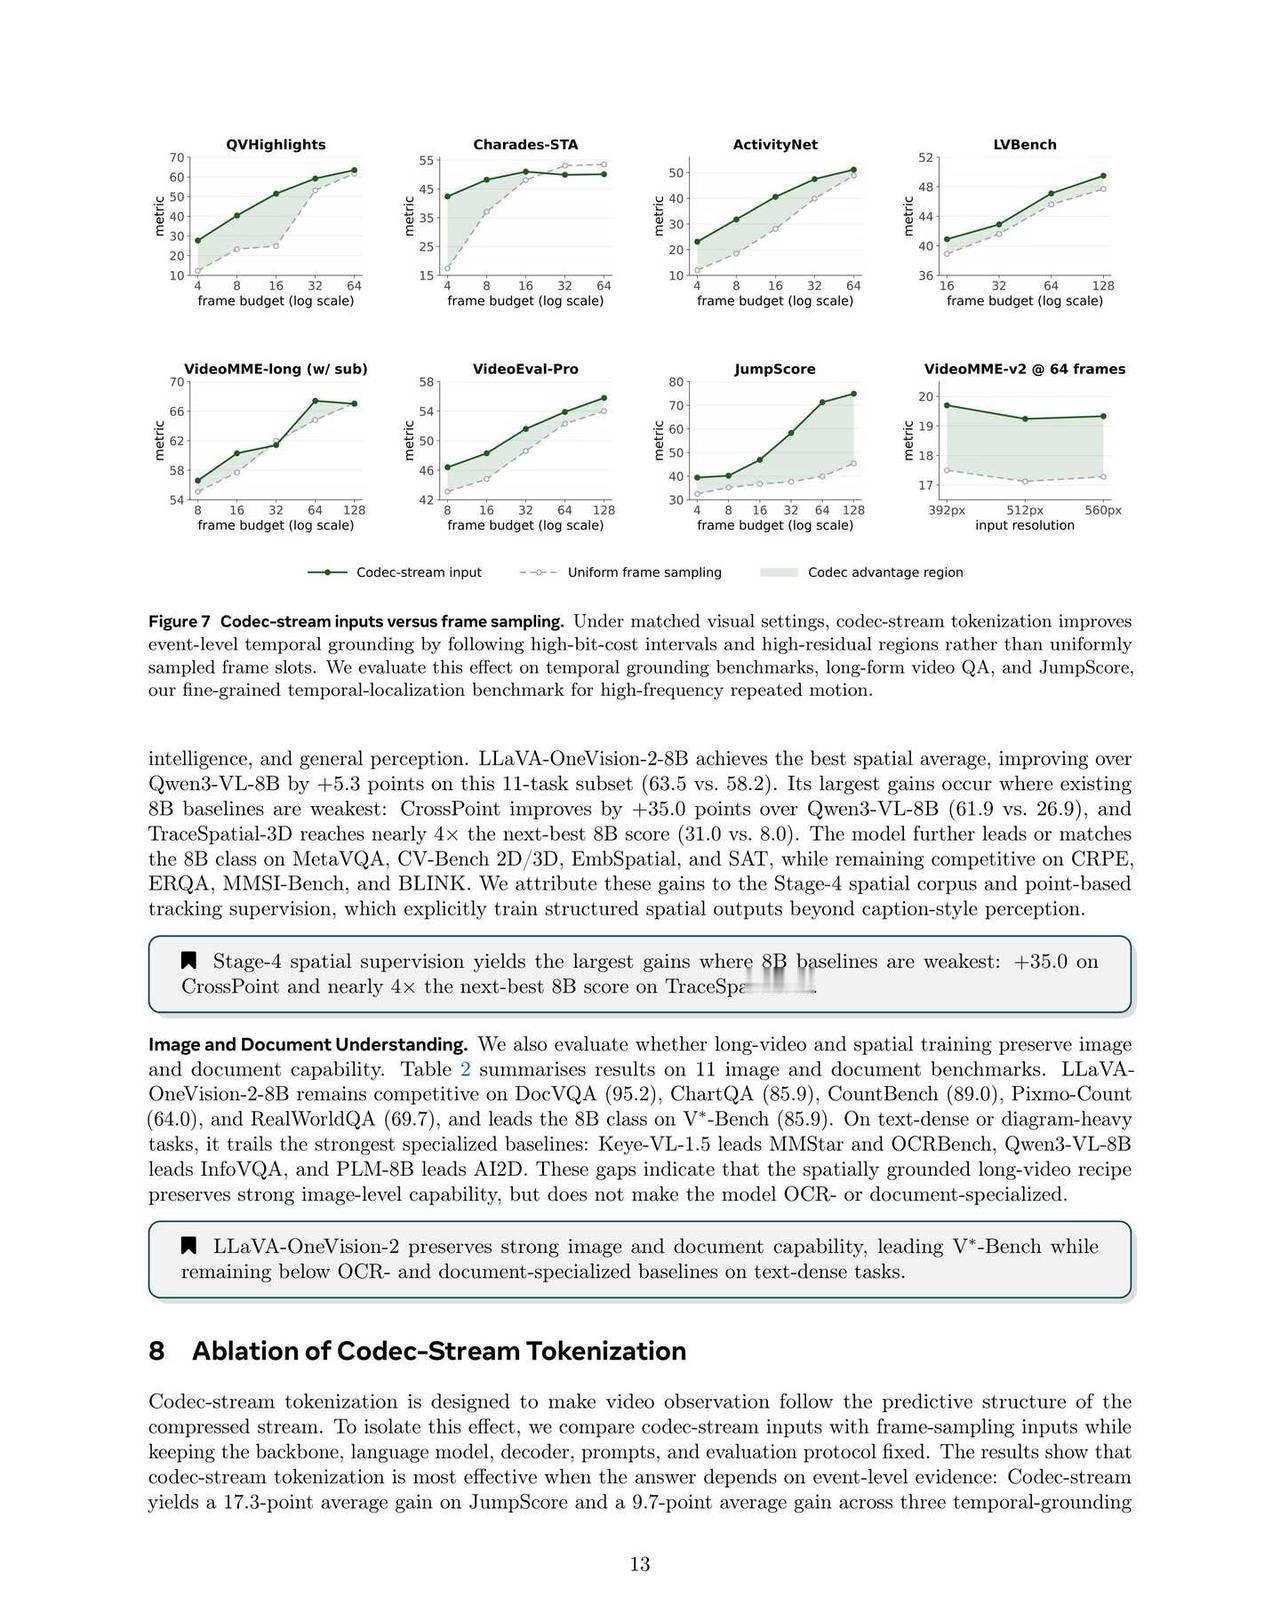
Video-LLM的工作大概率都被“均匀抽帧”过,面对密集重复动作或长视频,传统按时间抽帧就像开盲盒,极易漏掉关键的高频动作边界,算力没少花,细节全丢失。这篇LLaVA-OneVision-2给了一个很好的解答:放弃时间轴,改用压缩码流(Codec-Stream)引导视觉Token分配。
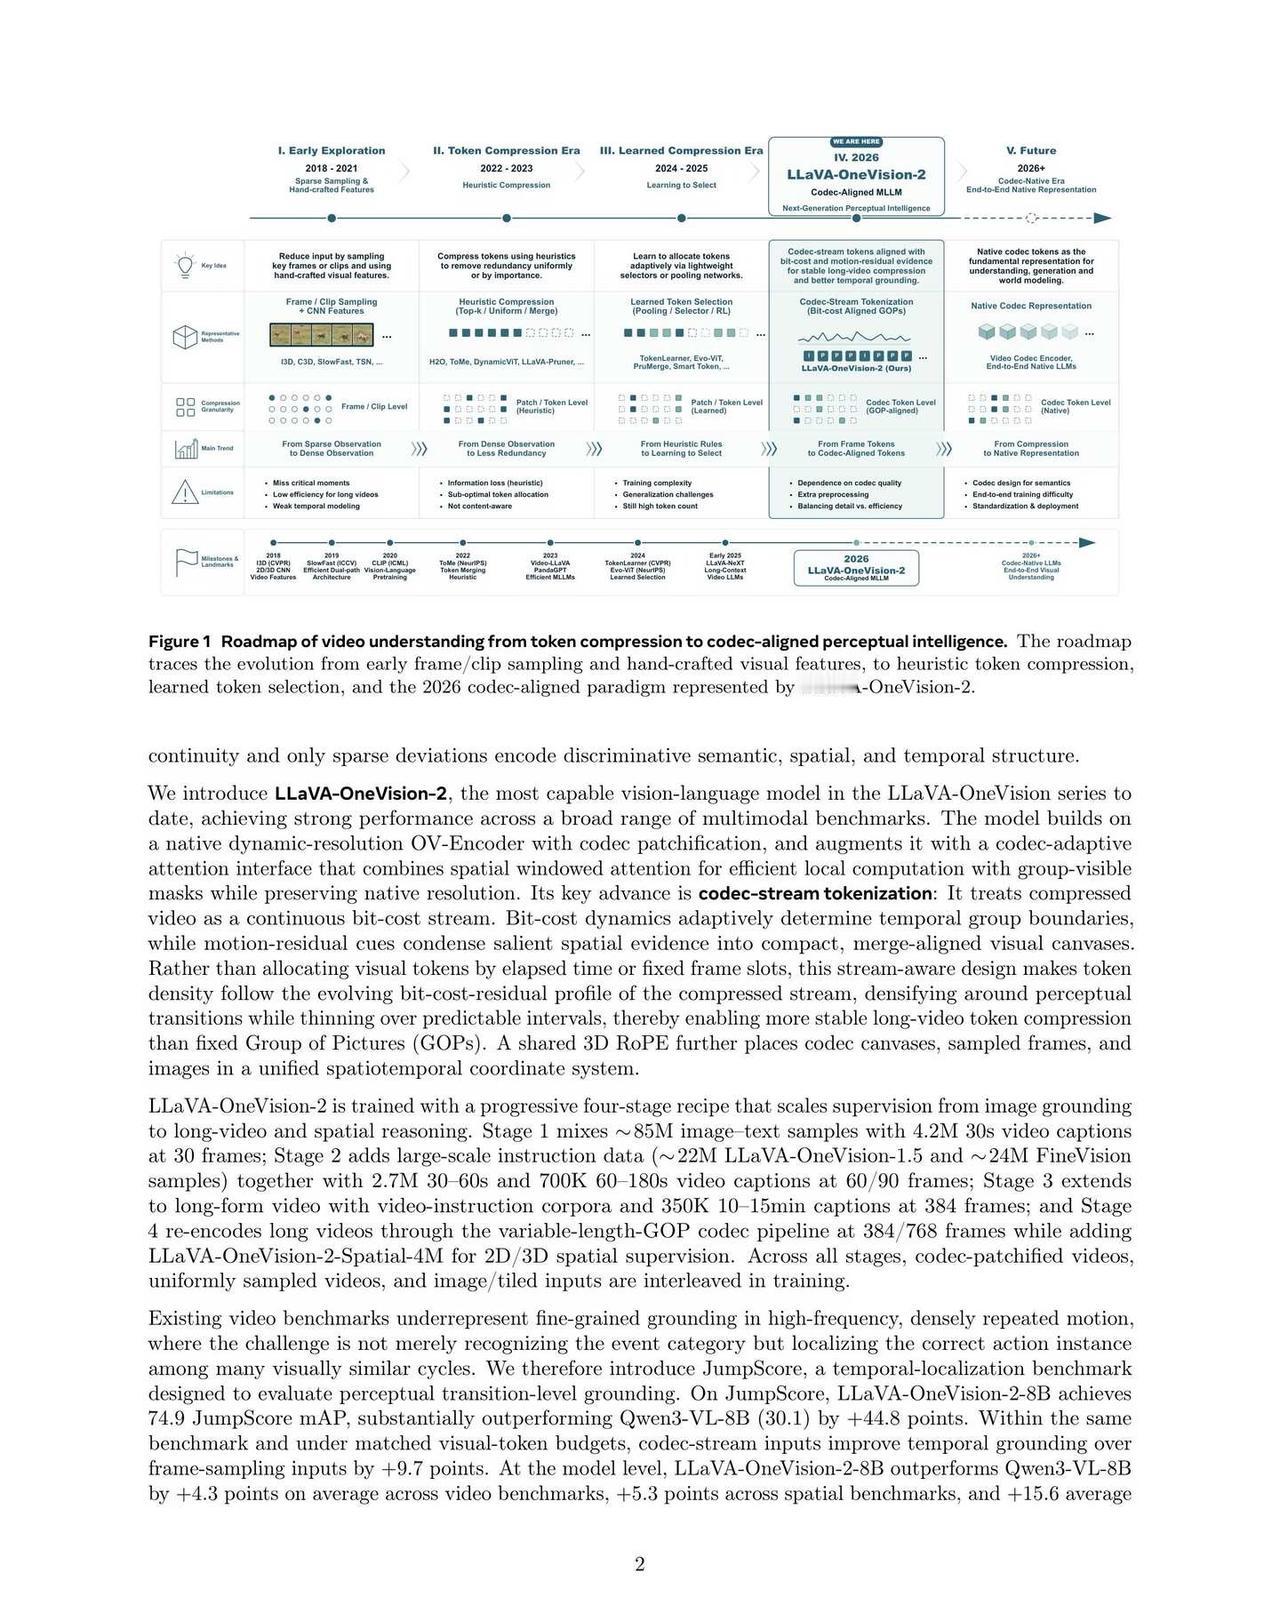
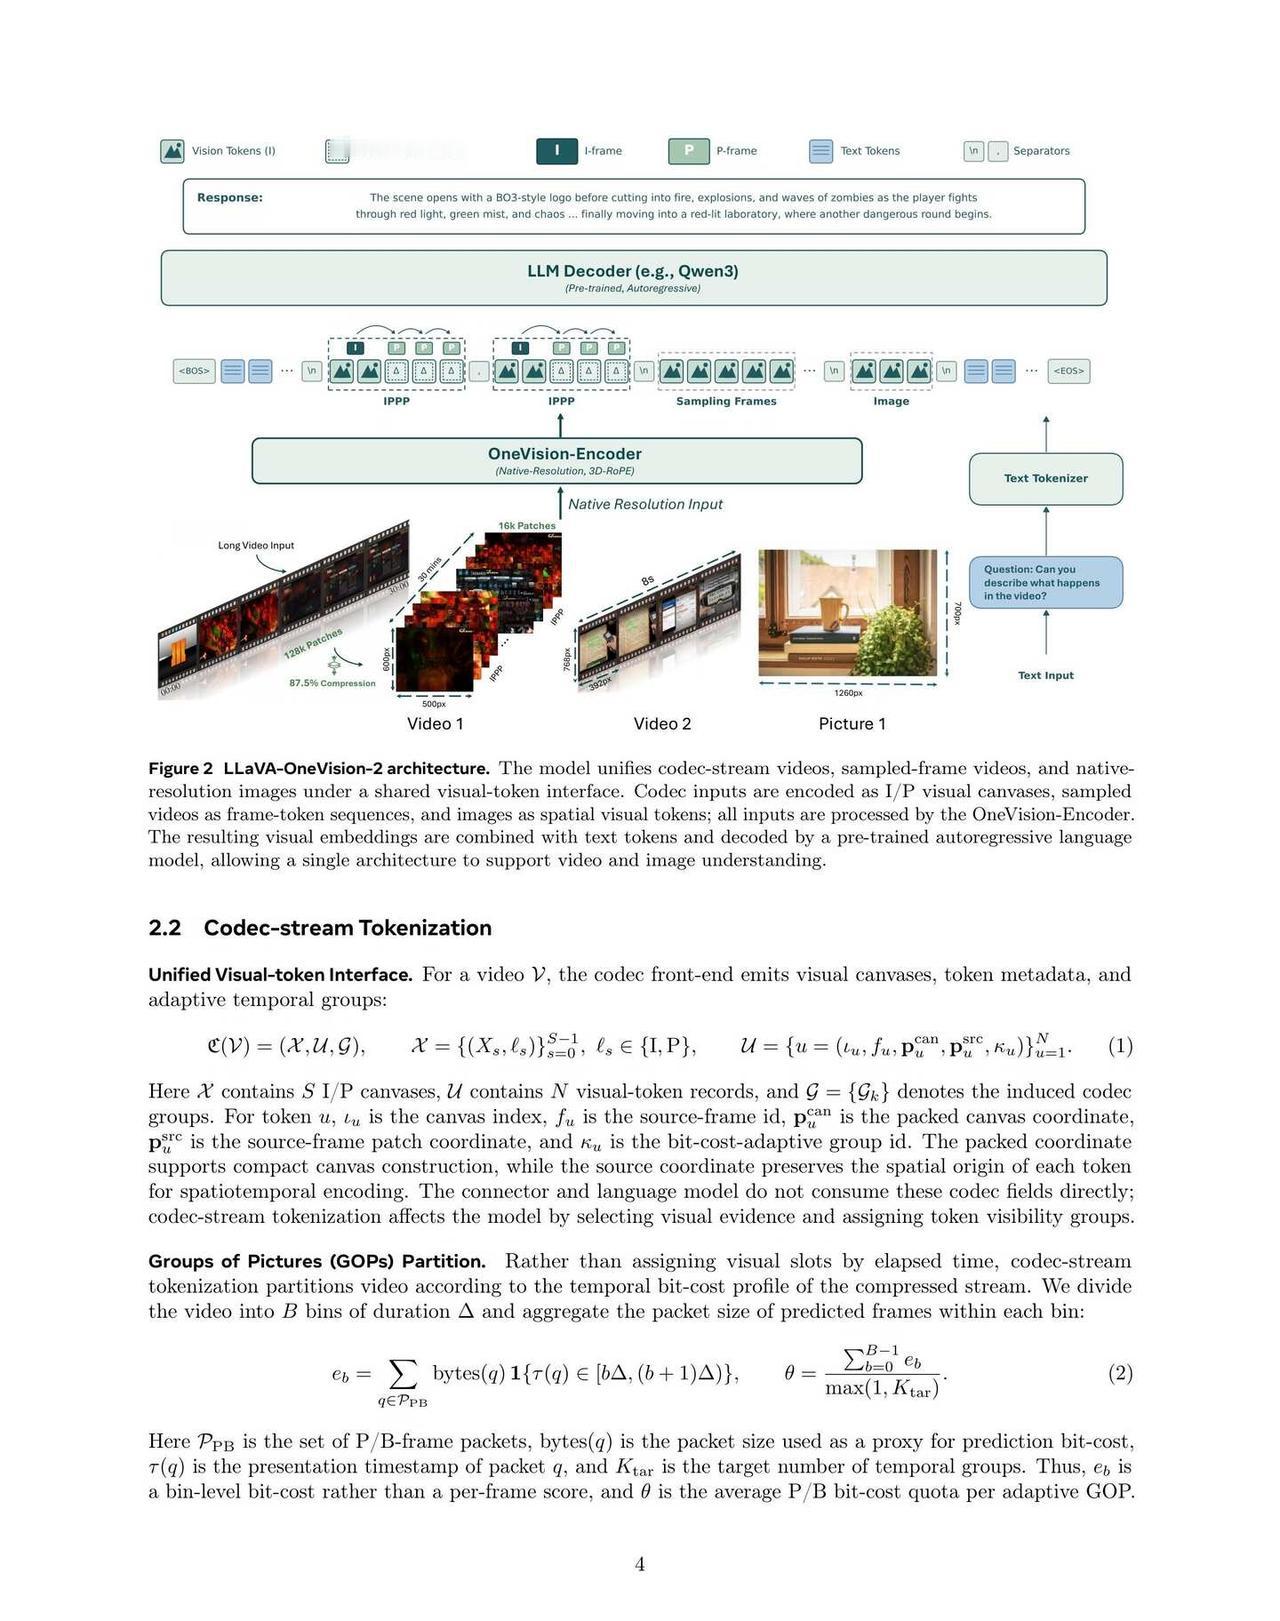
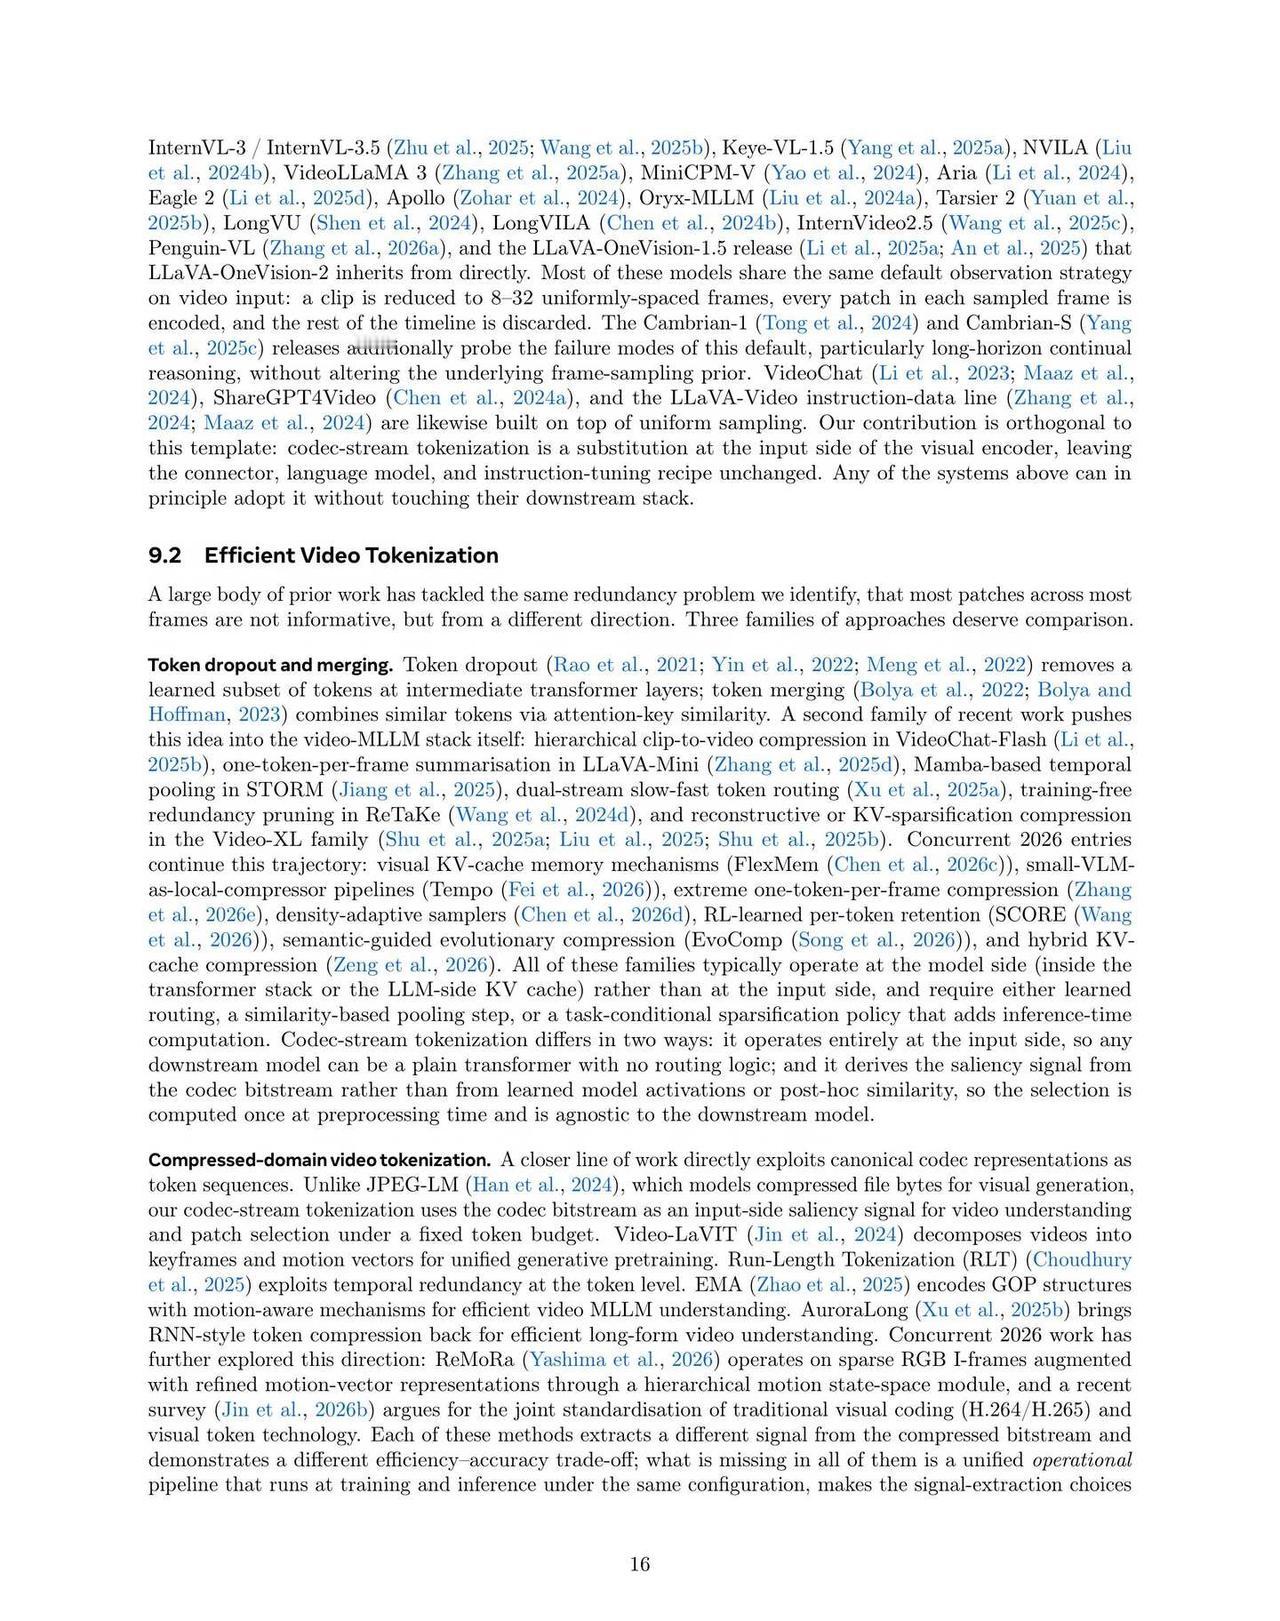
当前8B级开源Video-LLM(如Qwen3-VL、InternVL-3)基本是“SigLIP视觉编码器+MLP+LLM”的模板,靠增加帧数堆性能。但这篇工作直击痛点——视频真正的信息量不在每帧像素,而在帧间预测的残差和运动向量(P/B帧)。它复用OneVision-Encoder,直接把视频的比特开销当作“注意力指南针”。
📊
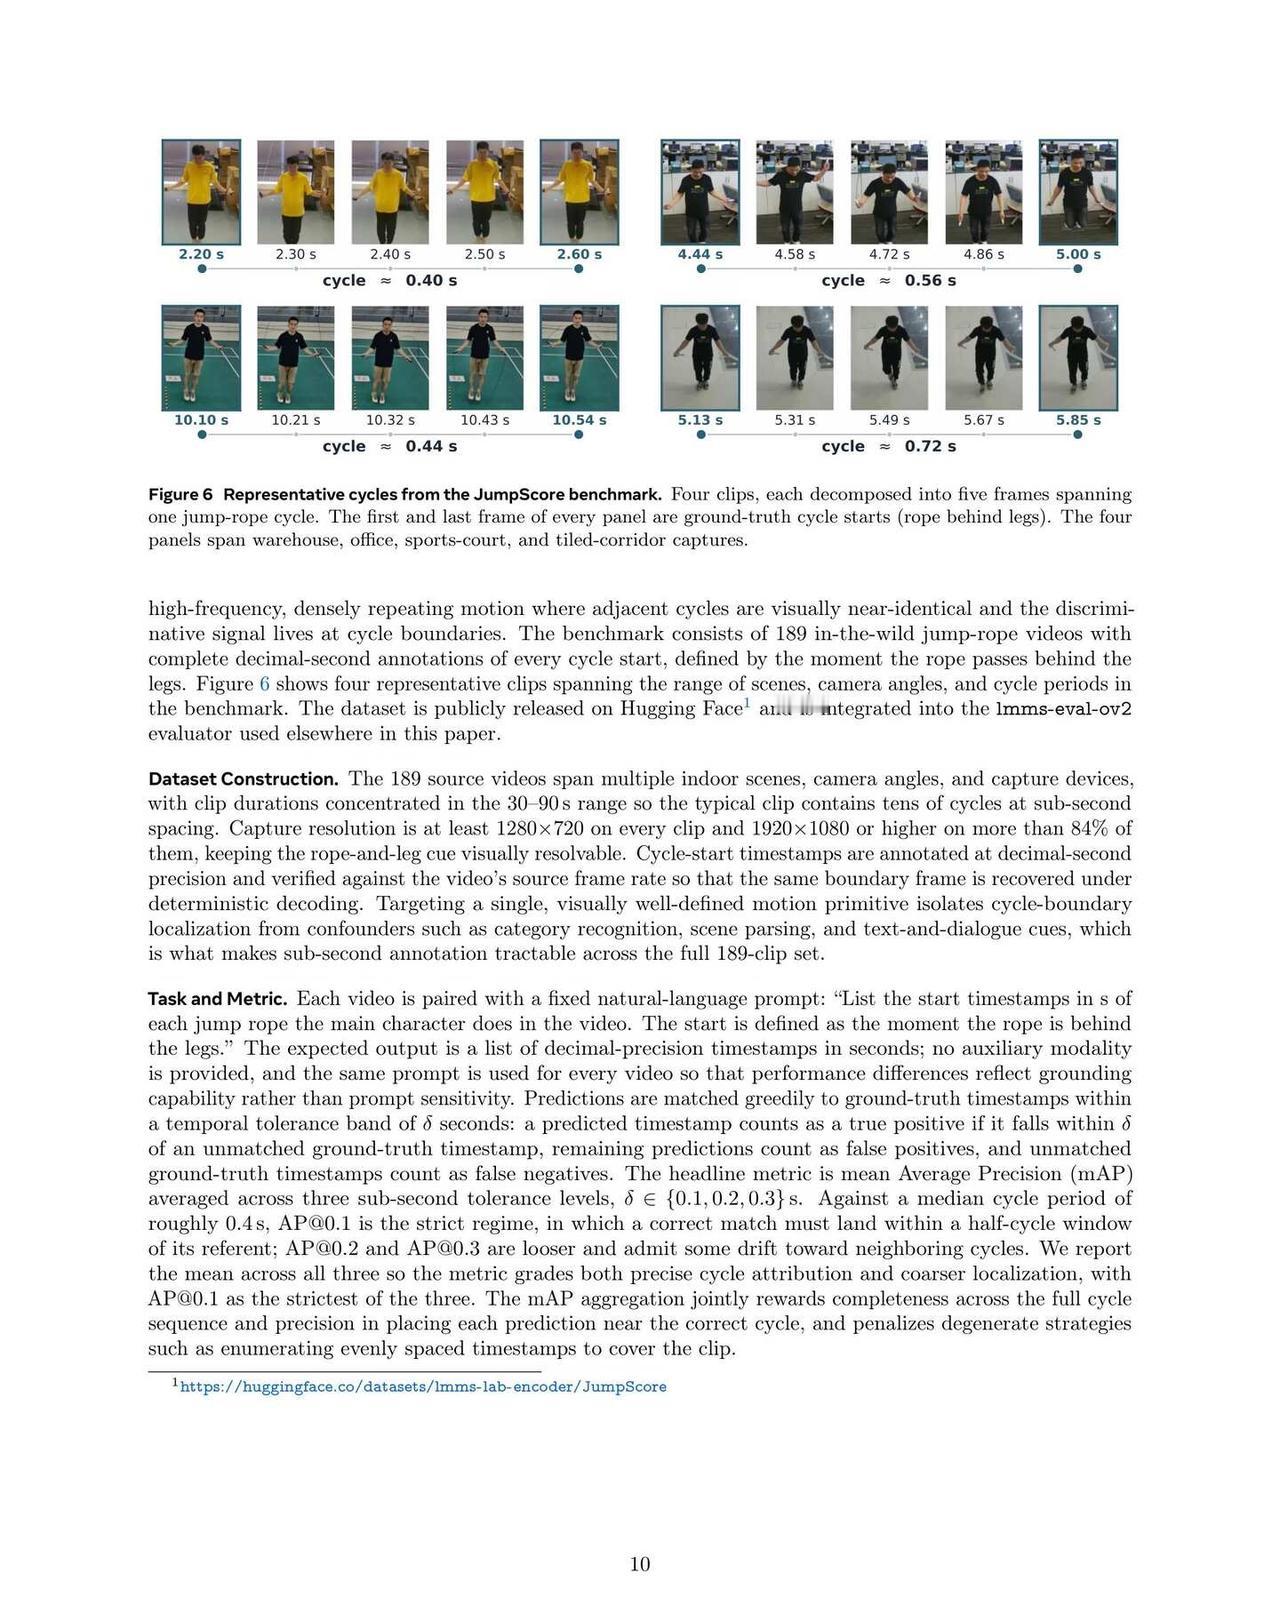
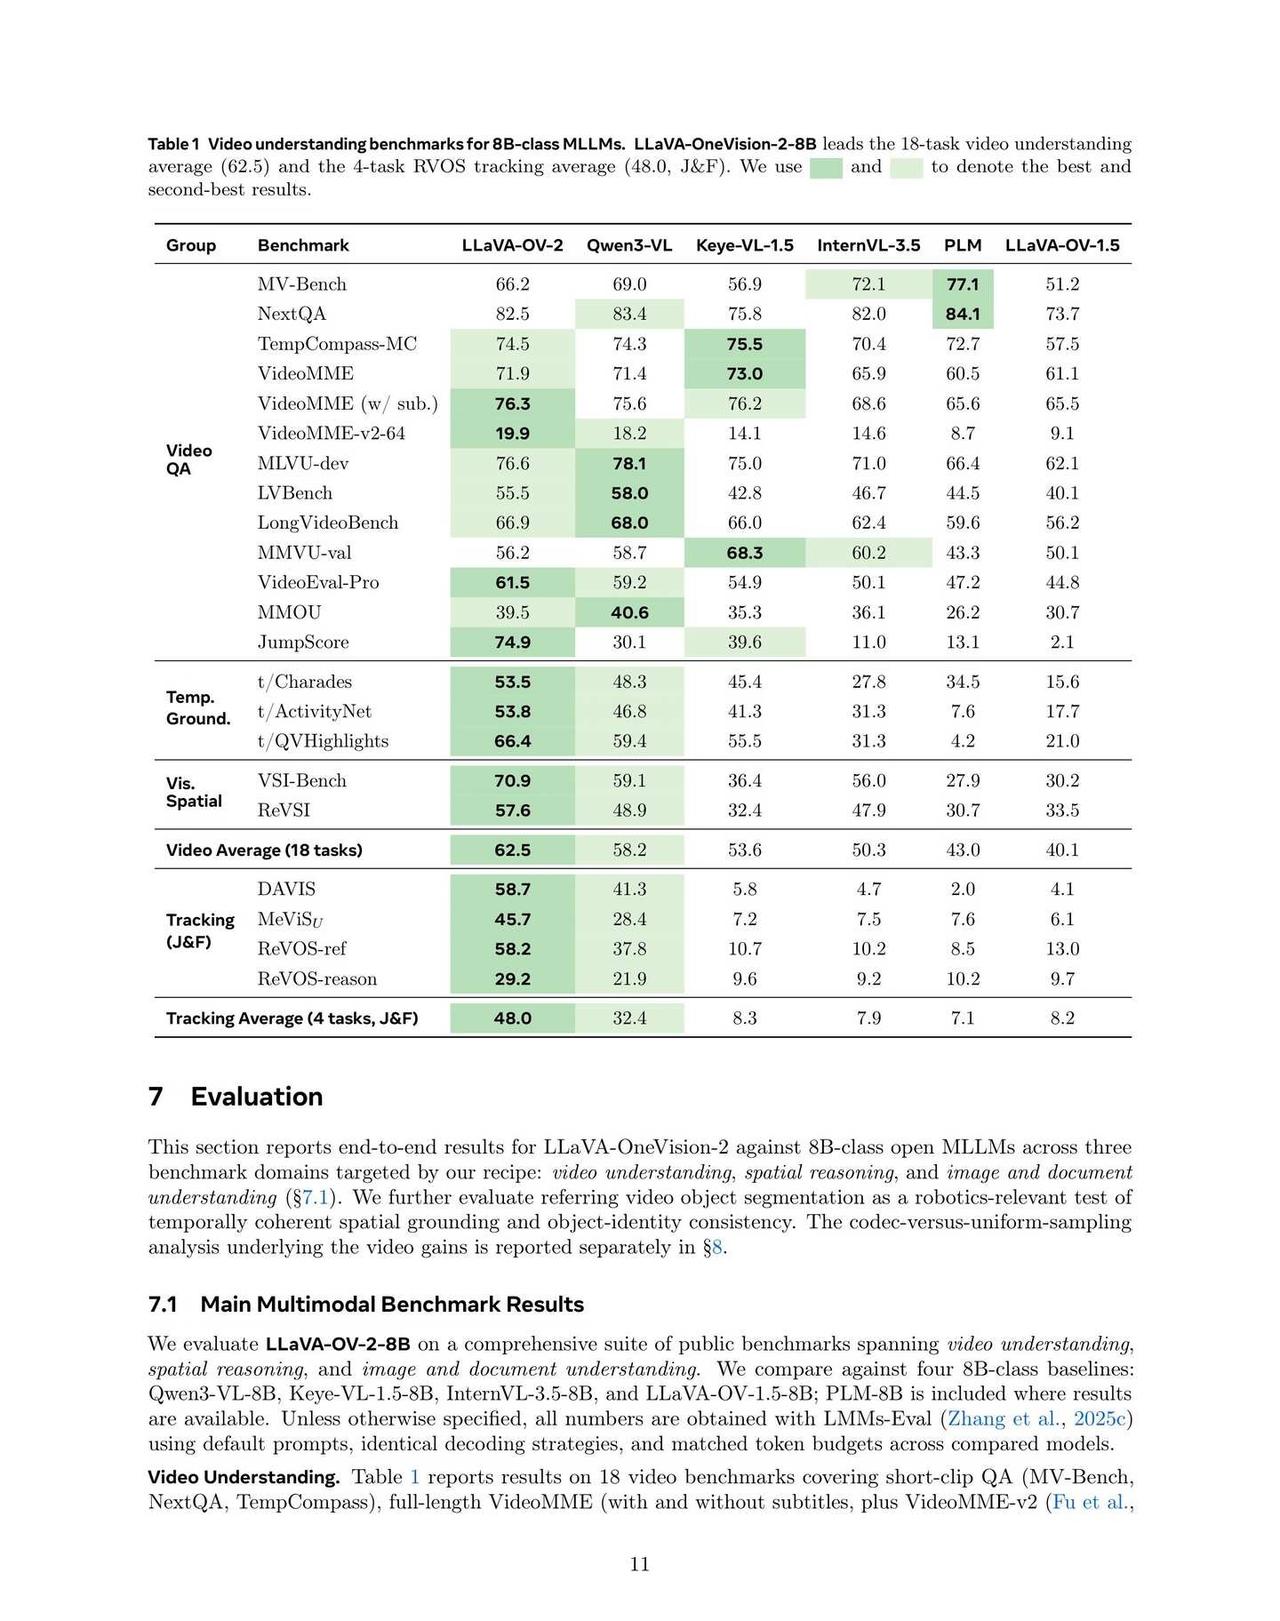
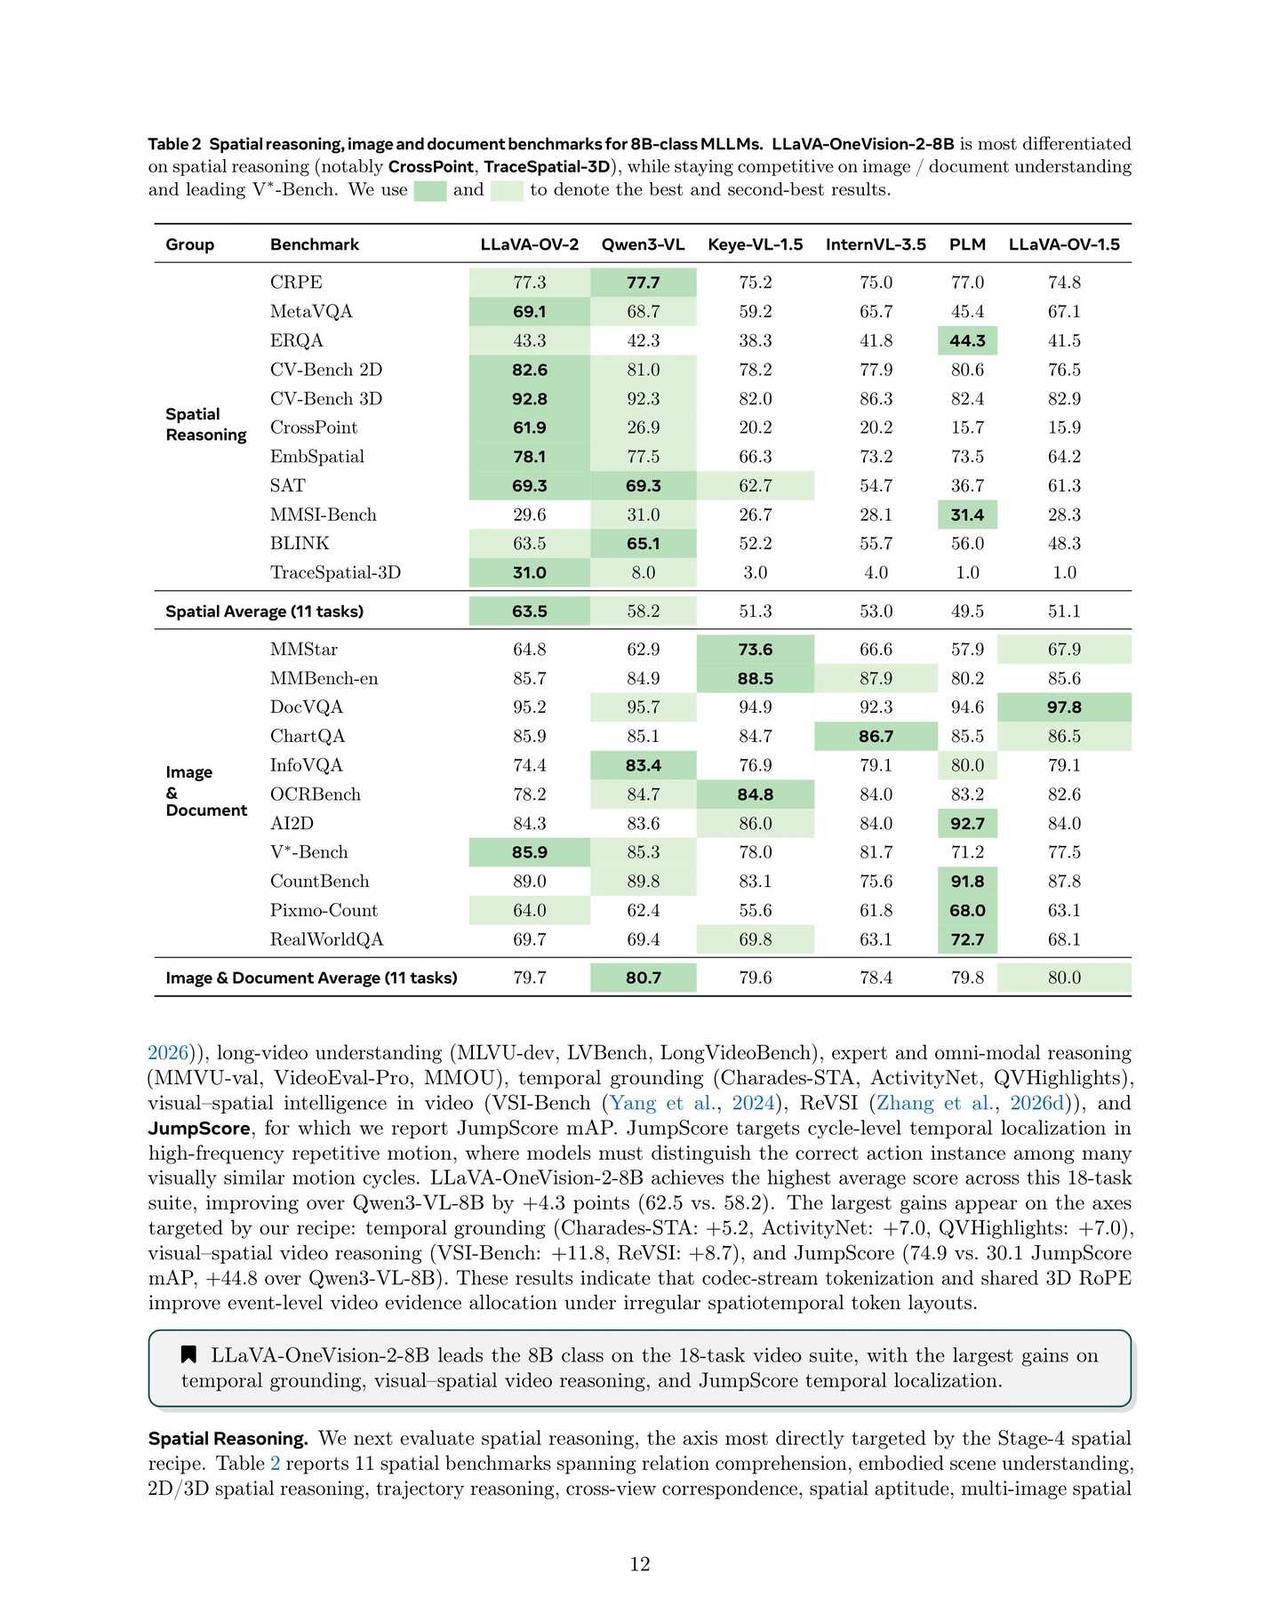
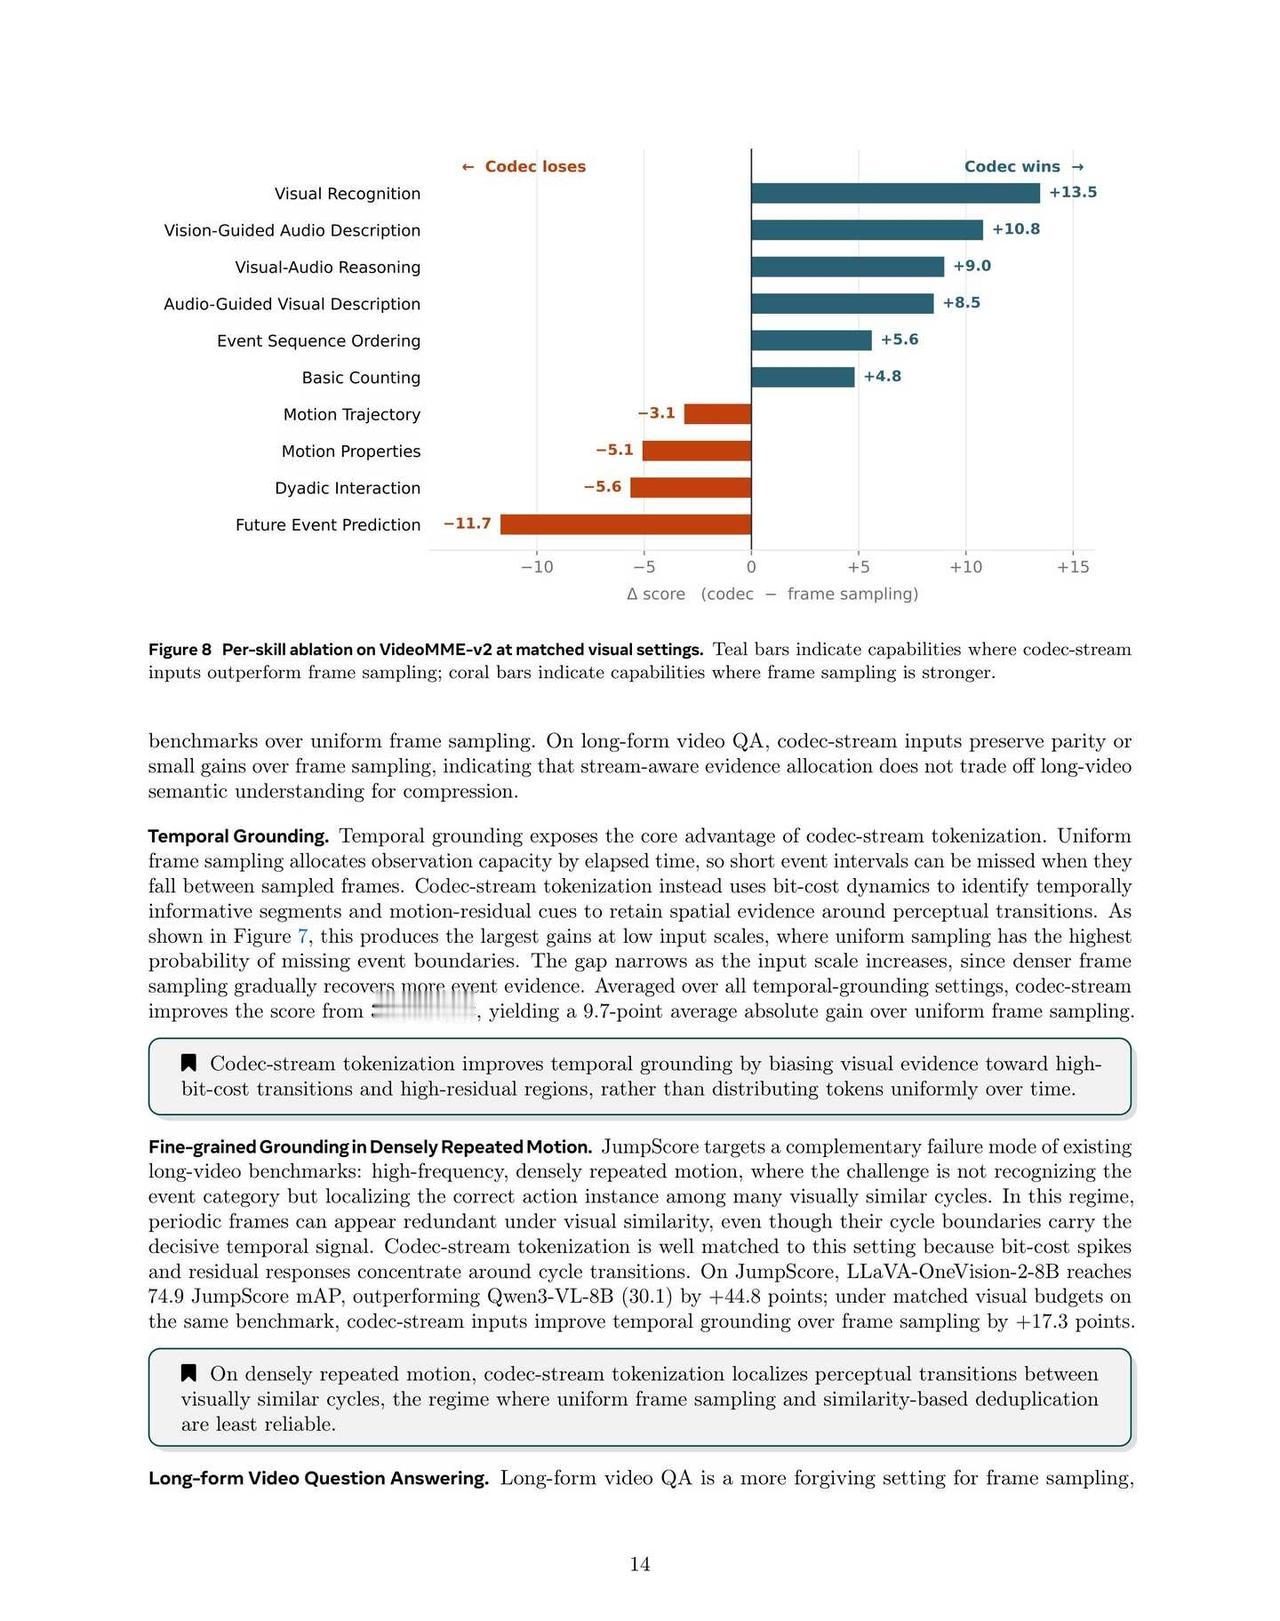
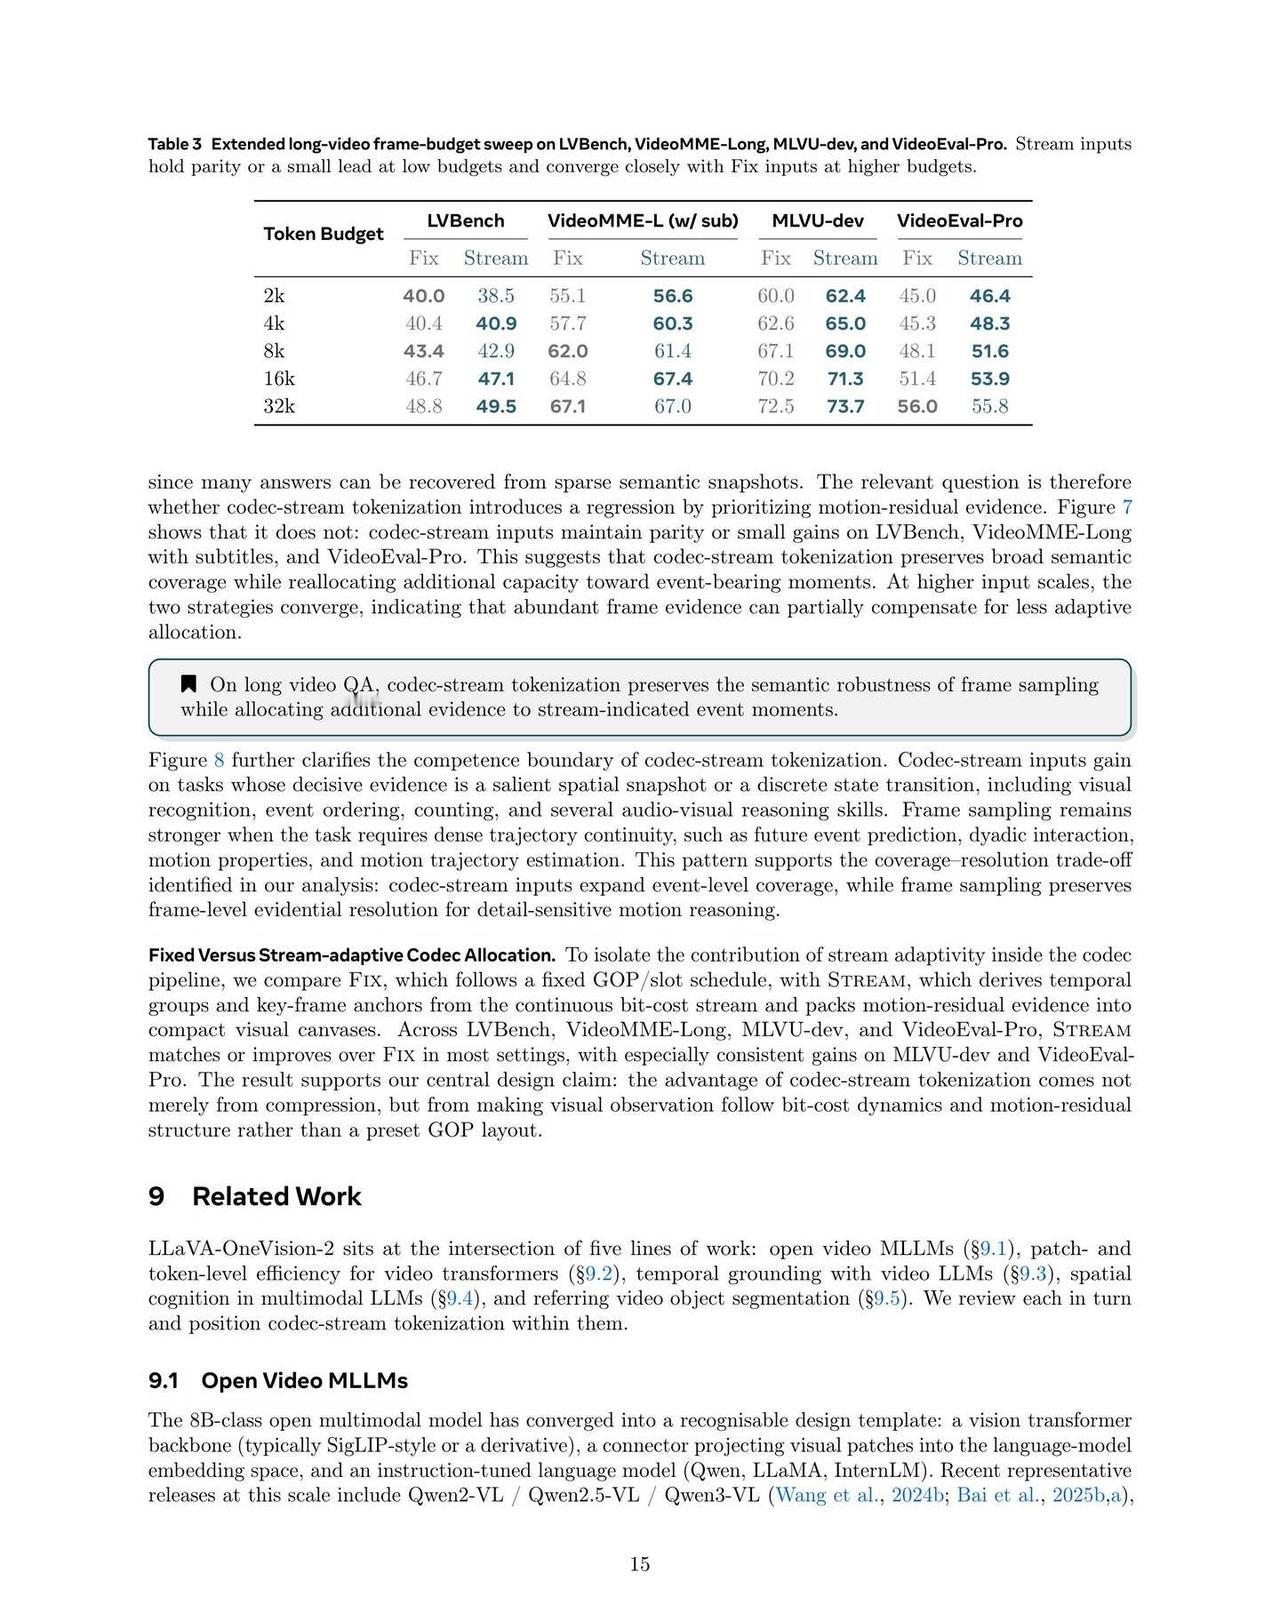
引入Codec-stream tokenization,让Token密度紧跟码流比特率和运动残差,跳过冗余帧。最惊艳的是它自建的JumpScore基准(高频跳绳动作定位),LLaVA-OV-2-8B拿下74.9 mAP,比Qwen3-VL-8B(30.1)超44.8分!在18项视频任务上平均分62.5,超越Qwen3-VL(58.2),且长视频QA不掉分,空间推理(CrossPoint)更是暴涨35分。
方法拆解🧠
1️⃣GOP分区:按P/B帧比特开销动态划分时间组,比特率陡增处切分,最小/最大跨度有硬约束。
2️⃣运动-残差打分:将运动向量和亮度残差归一化融合,聚合成2×2 Patch块打分。
3️⃣画布打包:按分数排序,用分层时间分配策略打包成I/P视觉画布,避免单帧高响应霸占Token。
三个可✍️的方向
👆 自动驾驶/机器人:用码流残差做“事件相机”触发器,只对急刹、避障等高频残差区间分配高密度Token,降本增效。
✌️GUI/文档Agent:借鉴其“分组可见注意力”,将长网页滚动录屏按DOM变更(类似I帧)切分,精准定位UI状态跃迁。
🤟音频多模态:将音频压缩码率(MP3比特率)类比视频码流,用码率峰值定位鼓点或语音停顿,替代传统的固定窗口采样。