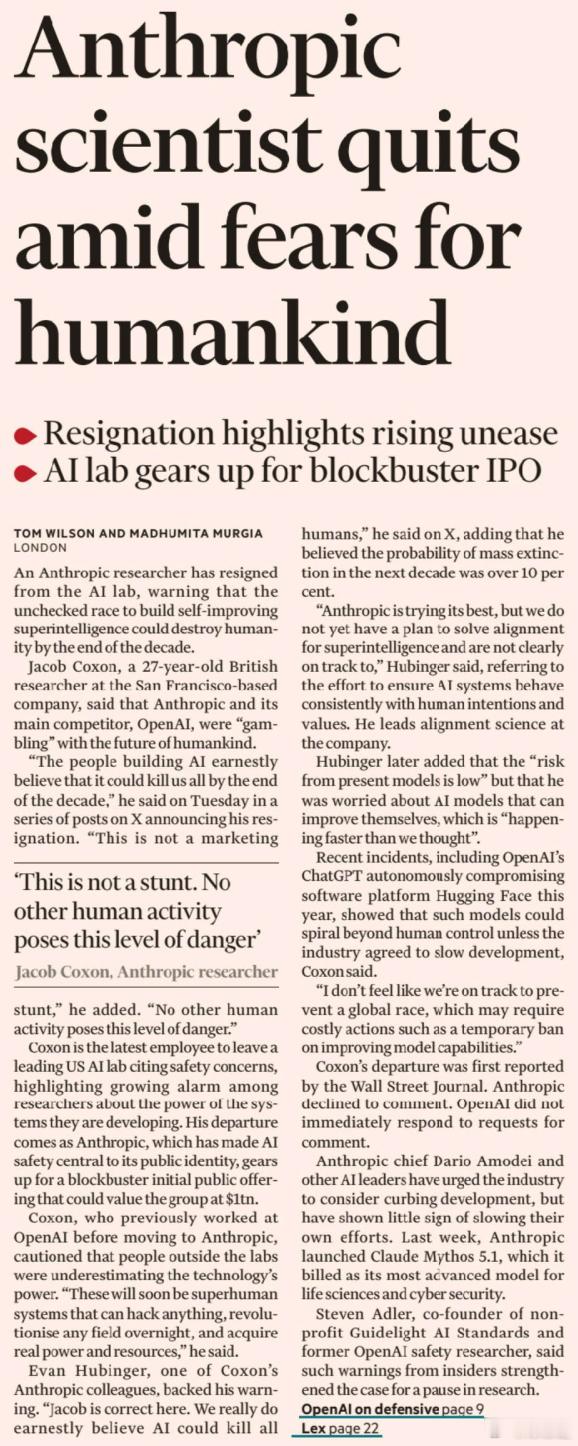
【AI安全AI风险超级智能 Anthropic 内部研究员离职预警:超级 AI 或十年内危及人类;同时 Claude 前沿模型拒绝英国安全机构测试】两份来自《金融时报》的报道,拼凑出当下 AI 行业充满矛盾的真实图景。
Anthropic 一名 27 岁研究员 Jacob Coxon 选择离职,公开表达对人类未来的深切担忧。他曾先后任职 OpenAI 与 Anthropic,在社交平台发文警示:全球无节制的超级智能研发竞赛,有可能在十年内摧毁人类文明,他预估未来十年 AI 带来物种级灭绝风险概率超过 10%。Coxon 强调,这并非营销噱头,没有任何其他人类活动具备同等量级的危险。
在他看来,Anthropic 和 OpenAI 如同拿人类命运博弈。很快就会出现超越人类能力的 AI 系统,可以攻破各类系统、颠覆各行各业,掌握真实权力与资源。他的观点也得到公司内部 AI 对齐负责人 Evan Hubinger 的支持:目前行业还没有成熟方案解决超级智能对齐难题,没法保证 AI 始终遵循人类的价值与意图。虽然现有模型风险较低,但能够自我迭代升级的 AI,进化速度远比大众预想更快。
Coxon 呼吁全球暂停前沿大模型能力竞赛,甚至需要临时限制模型能力提升。值得一提的是,主打 AI 安全叙事的 Anthropic,正筹备 IPO,市场预期估值可达**万亿美元级别**。
而另一边,Anthropic 最新发布的旗舰模型 Claude Mythos 5.1,没有提前提交给英国 AI 安全研究所 AISI 开展前置安全测试。AISI 是全球顶尖的前沿 AI 评测机构,这款新模型仅对经过美方审核的机构开放,英国官方安全机构被直接排除在外。英国政府内部对此高度警惕,怀疑 Anthropic 此举是配合特朗普政府的 AI 技术保护主义。
事件根源在于美国此前出台出口管制,因模型存在可绕过安全防护的越狱漏洞,限制外籍人员使用 Anthropic 高端模型。这一举动引发欧盟与英国强烈不满,认为美国在 AI 监管上对盟友搞区别对待。
一边是内部科研者冒着行业压力,敲响 AI 生存风险的警钟;另一边企业在万亿资本预期、地缘政策的双重影响下推进前沿模型,甚至把盟友的安全审查挡在门外。AI 安全的理想,正在商业化和大国技术博弈面前,遭遇严峻考验。AnthropicClaude大模型
PS. 新作《画给孩子的量子力学》《画给孩子的人工智能》新鲜出版上架:网页链接