2026年了,视频理解还有什么可做的?
🚩不同于传统的Captioning或动作识别,MLLM语境下的视频理解要求模型在有限Token预算下实现对长序列的感知、事件状态变化的记忆以及高精度的时序推理。
🚩视频数据的高冗余性使得单纯复用图像MLLM流水线难以兼顾效率与精度。本期分享将聚焦如何通过层级压缩、原生视频编码及事件级数据构建,突破长视频理解的技术瓶颈。
👉视频Token压缩与时空去冗余:
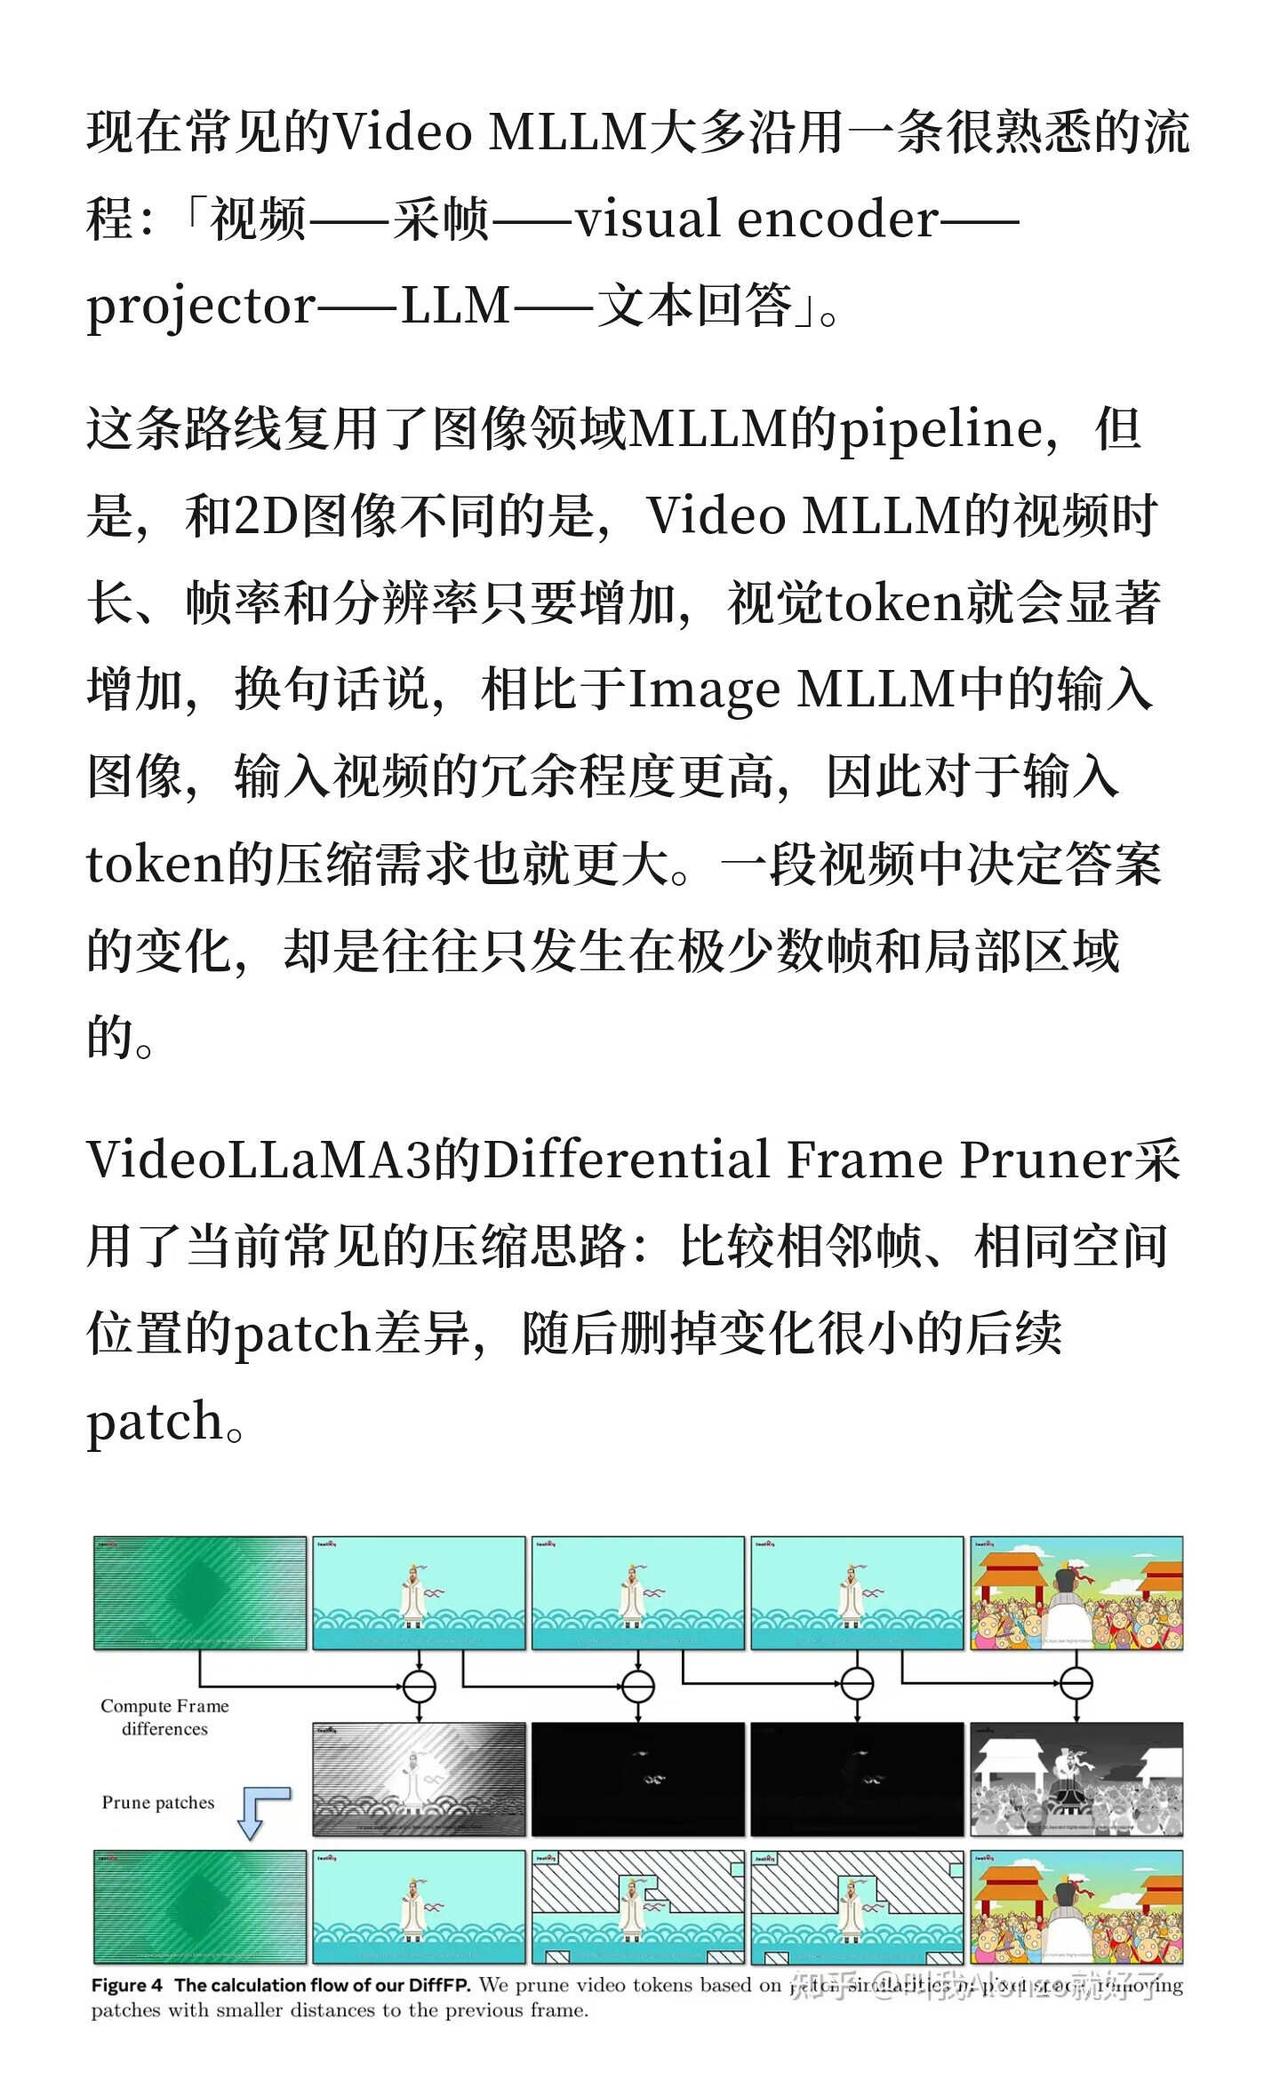
1)VideoLLaMA 3利用Differential Frame Pruner(DiffFP)在像素空间剔除低变化区域;
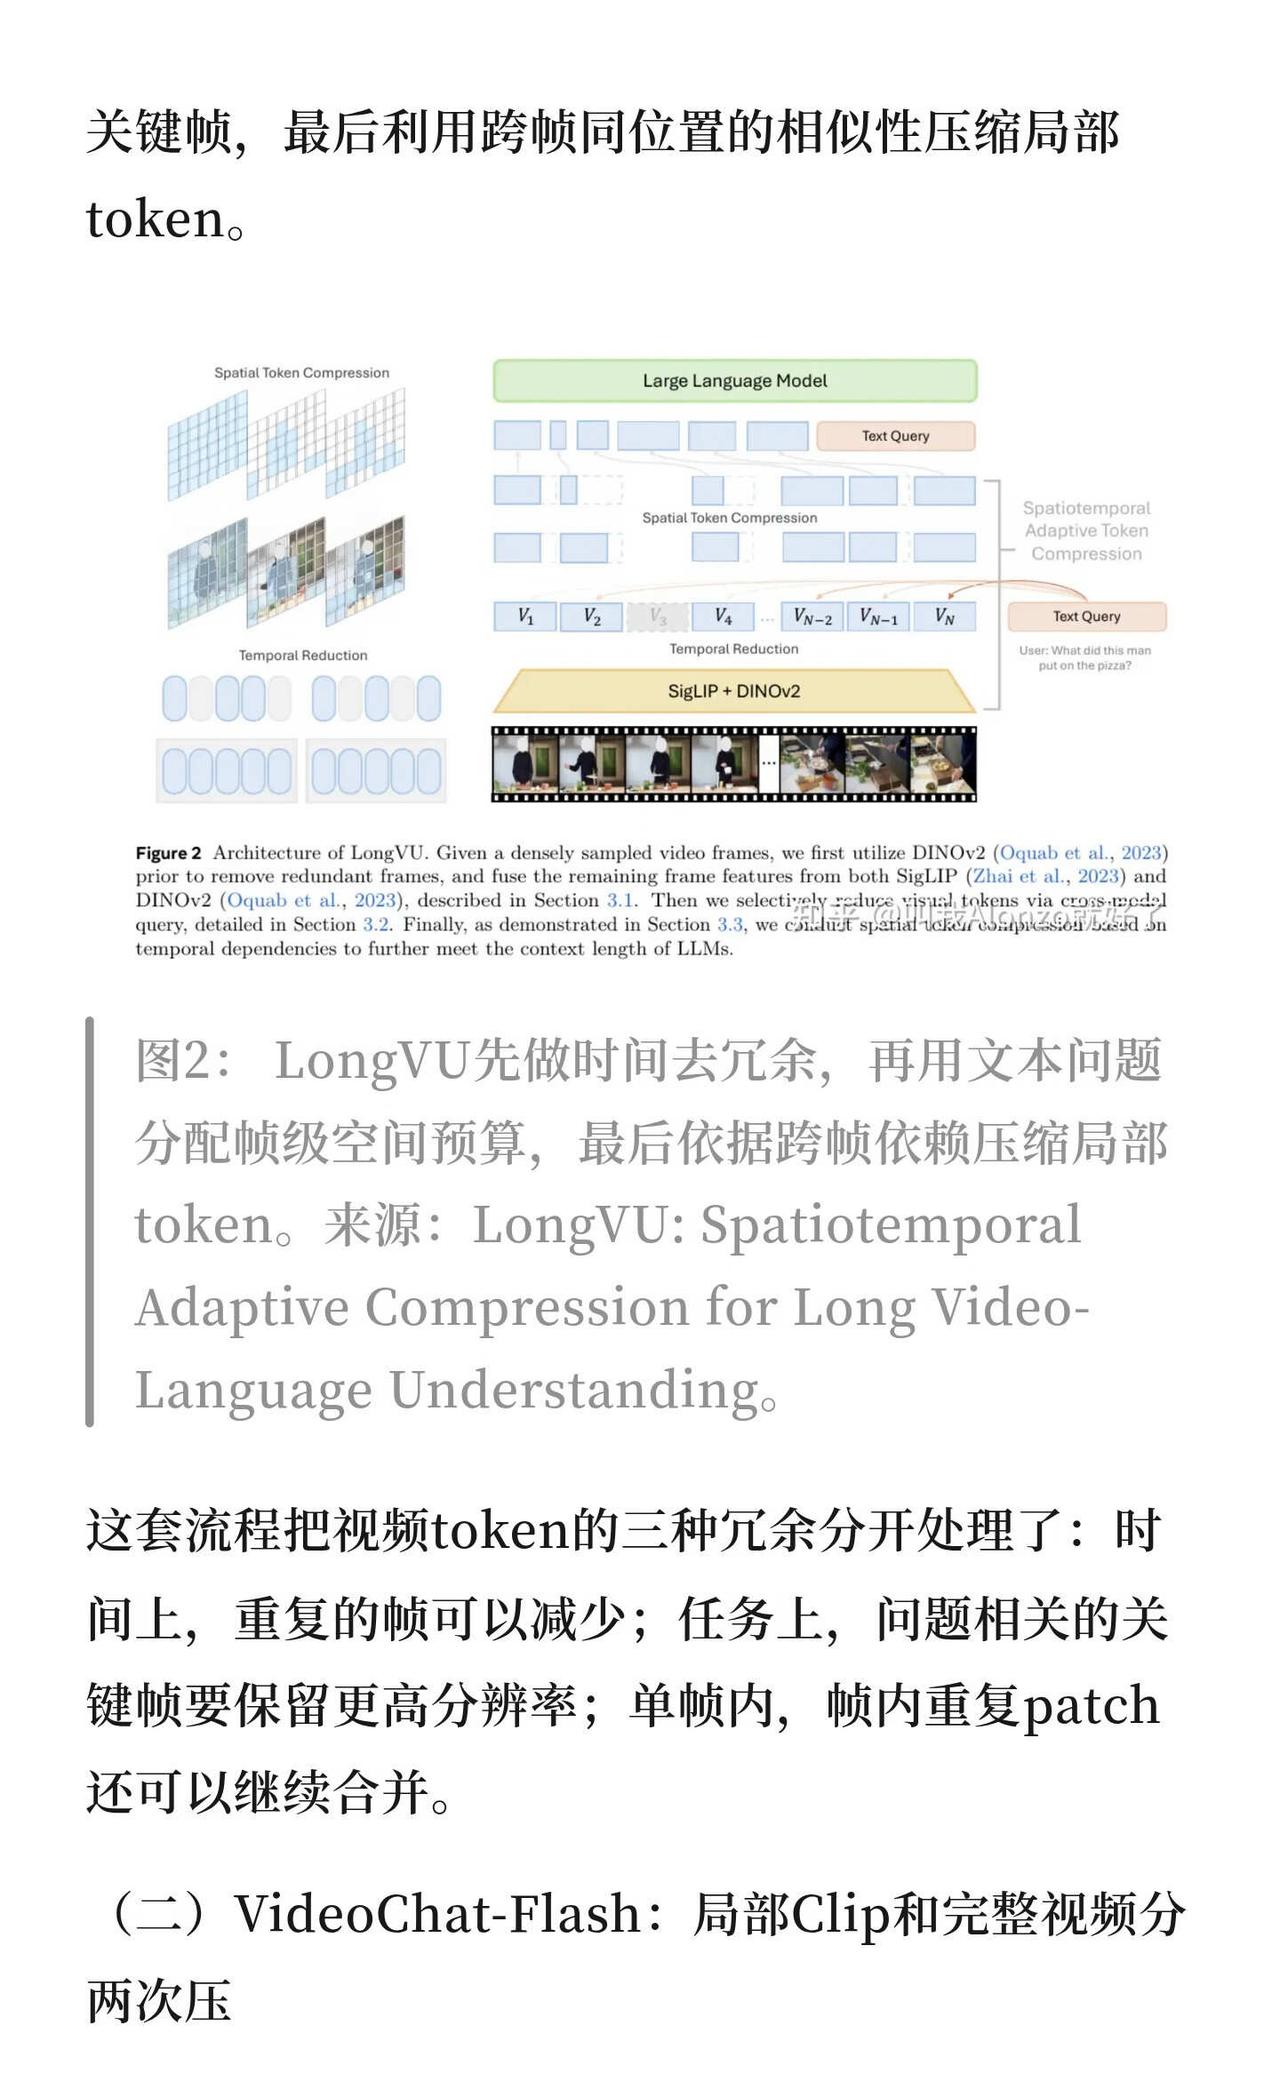
2)LongVU通过时间去冗余、任务驱动的关键帧筛选及跨帧依赖实现时空自适应压缩;
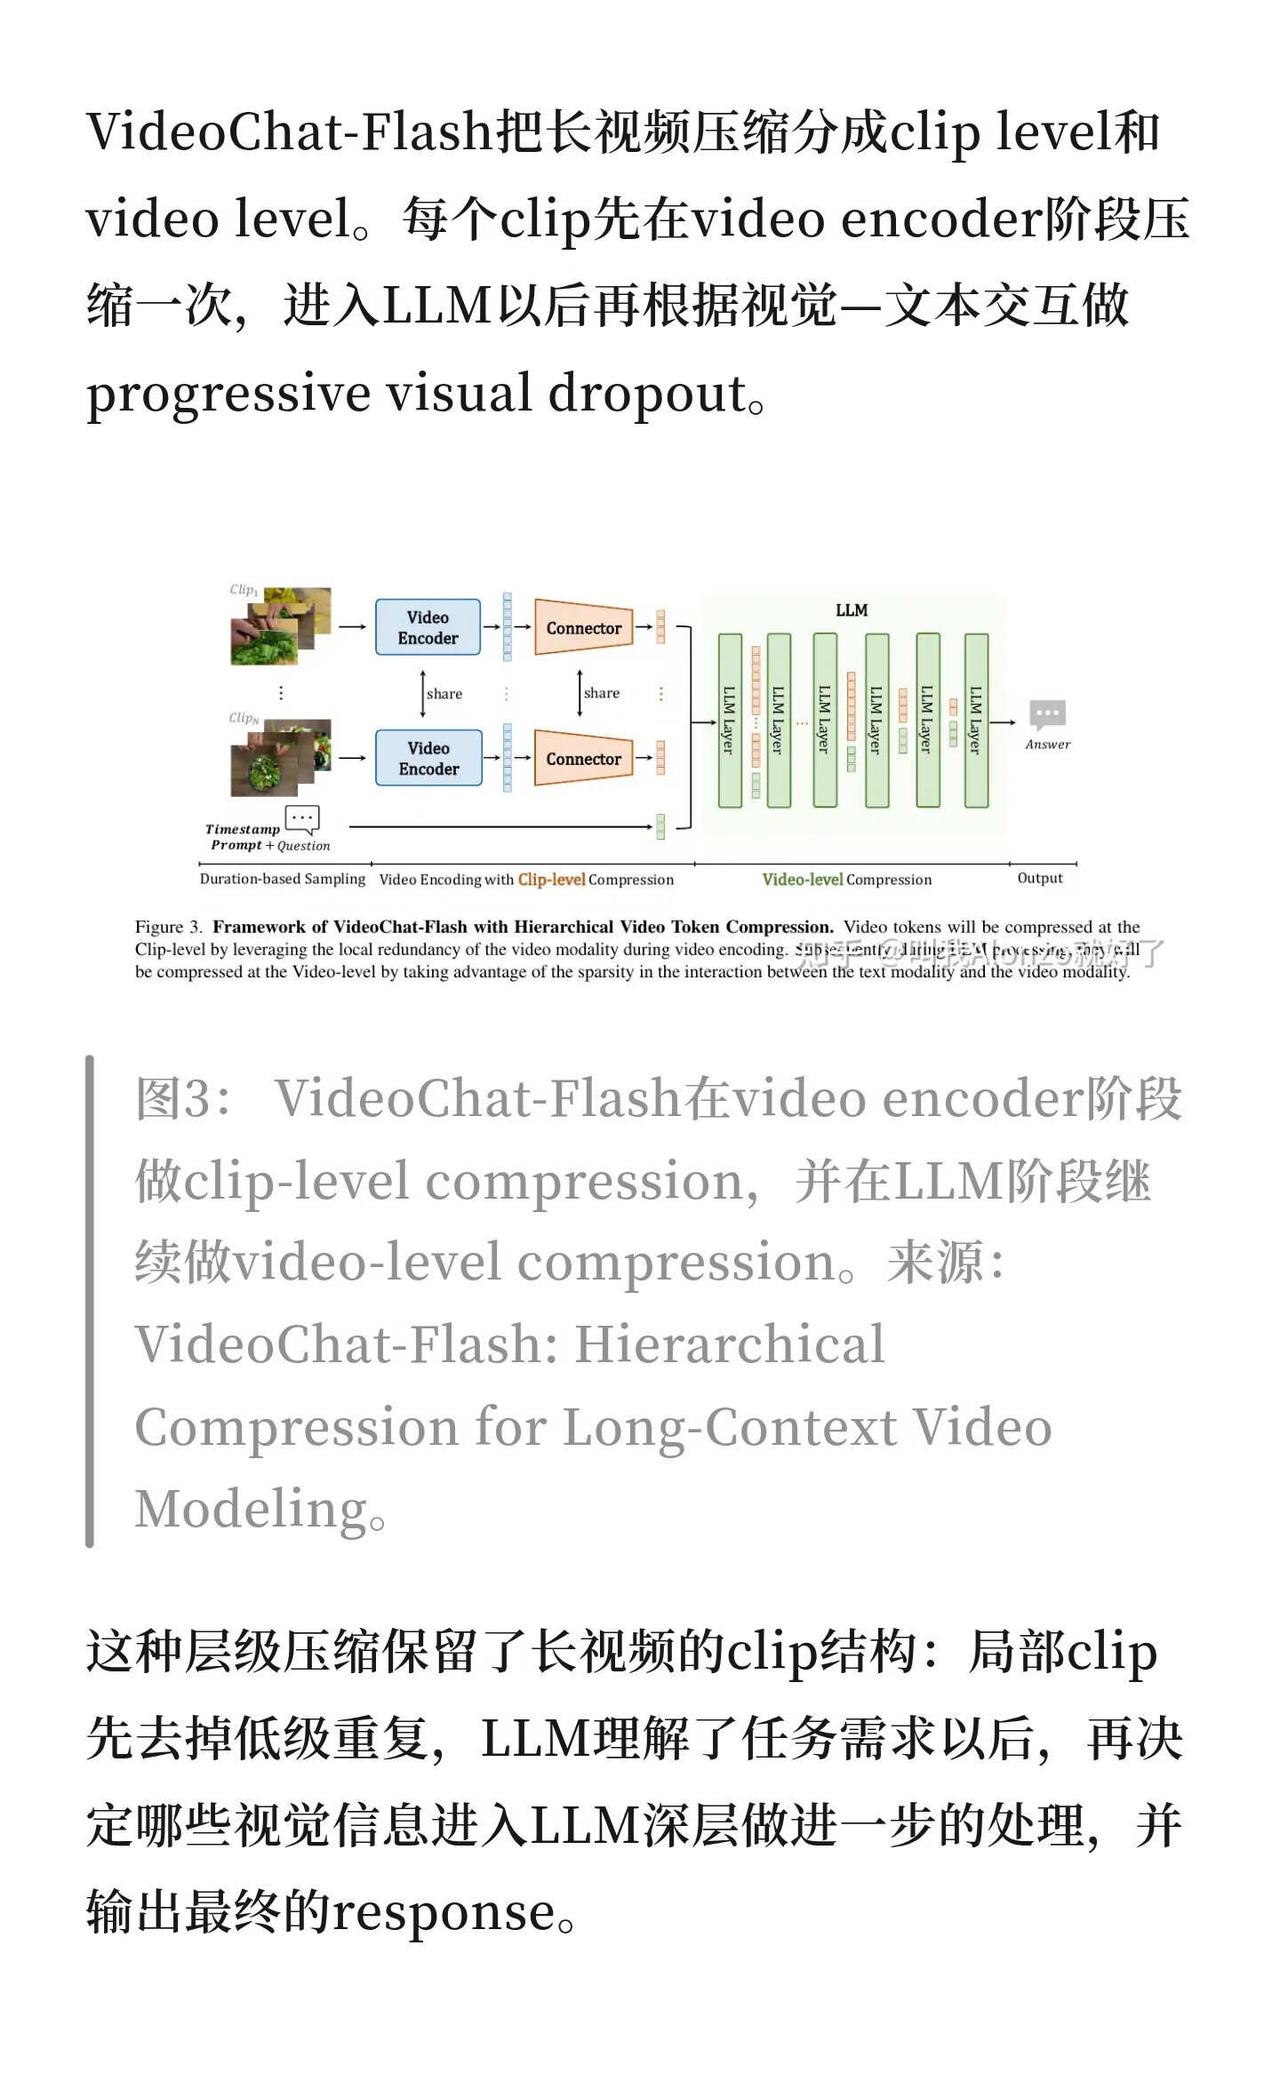
3)VideoChat-Flash采用层级化压缩方案,在LLM阶段引入Progressive
Visual Dropout。
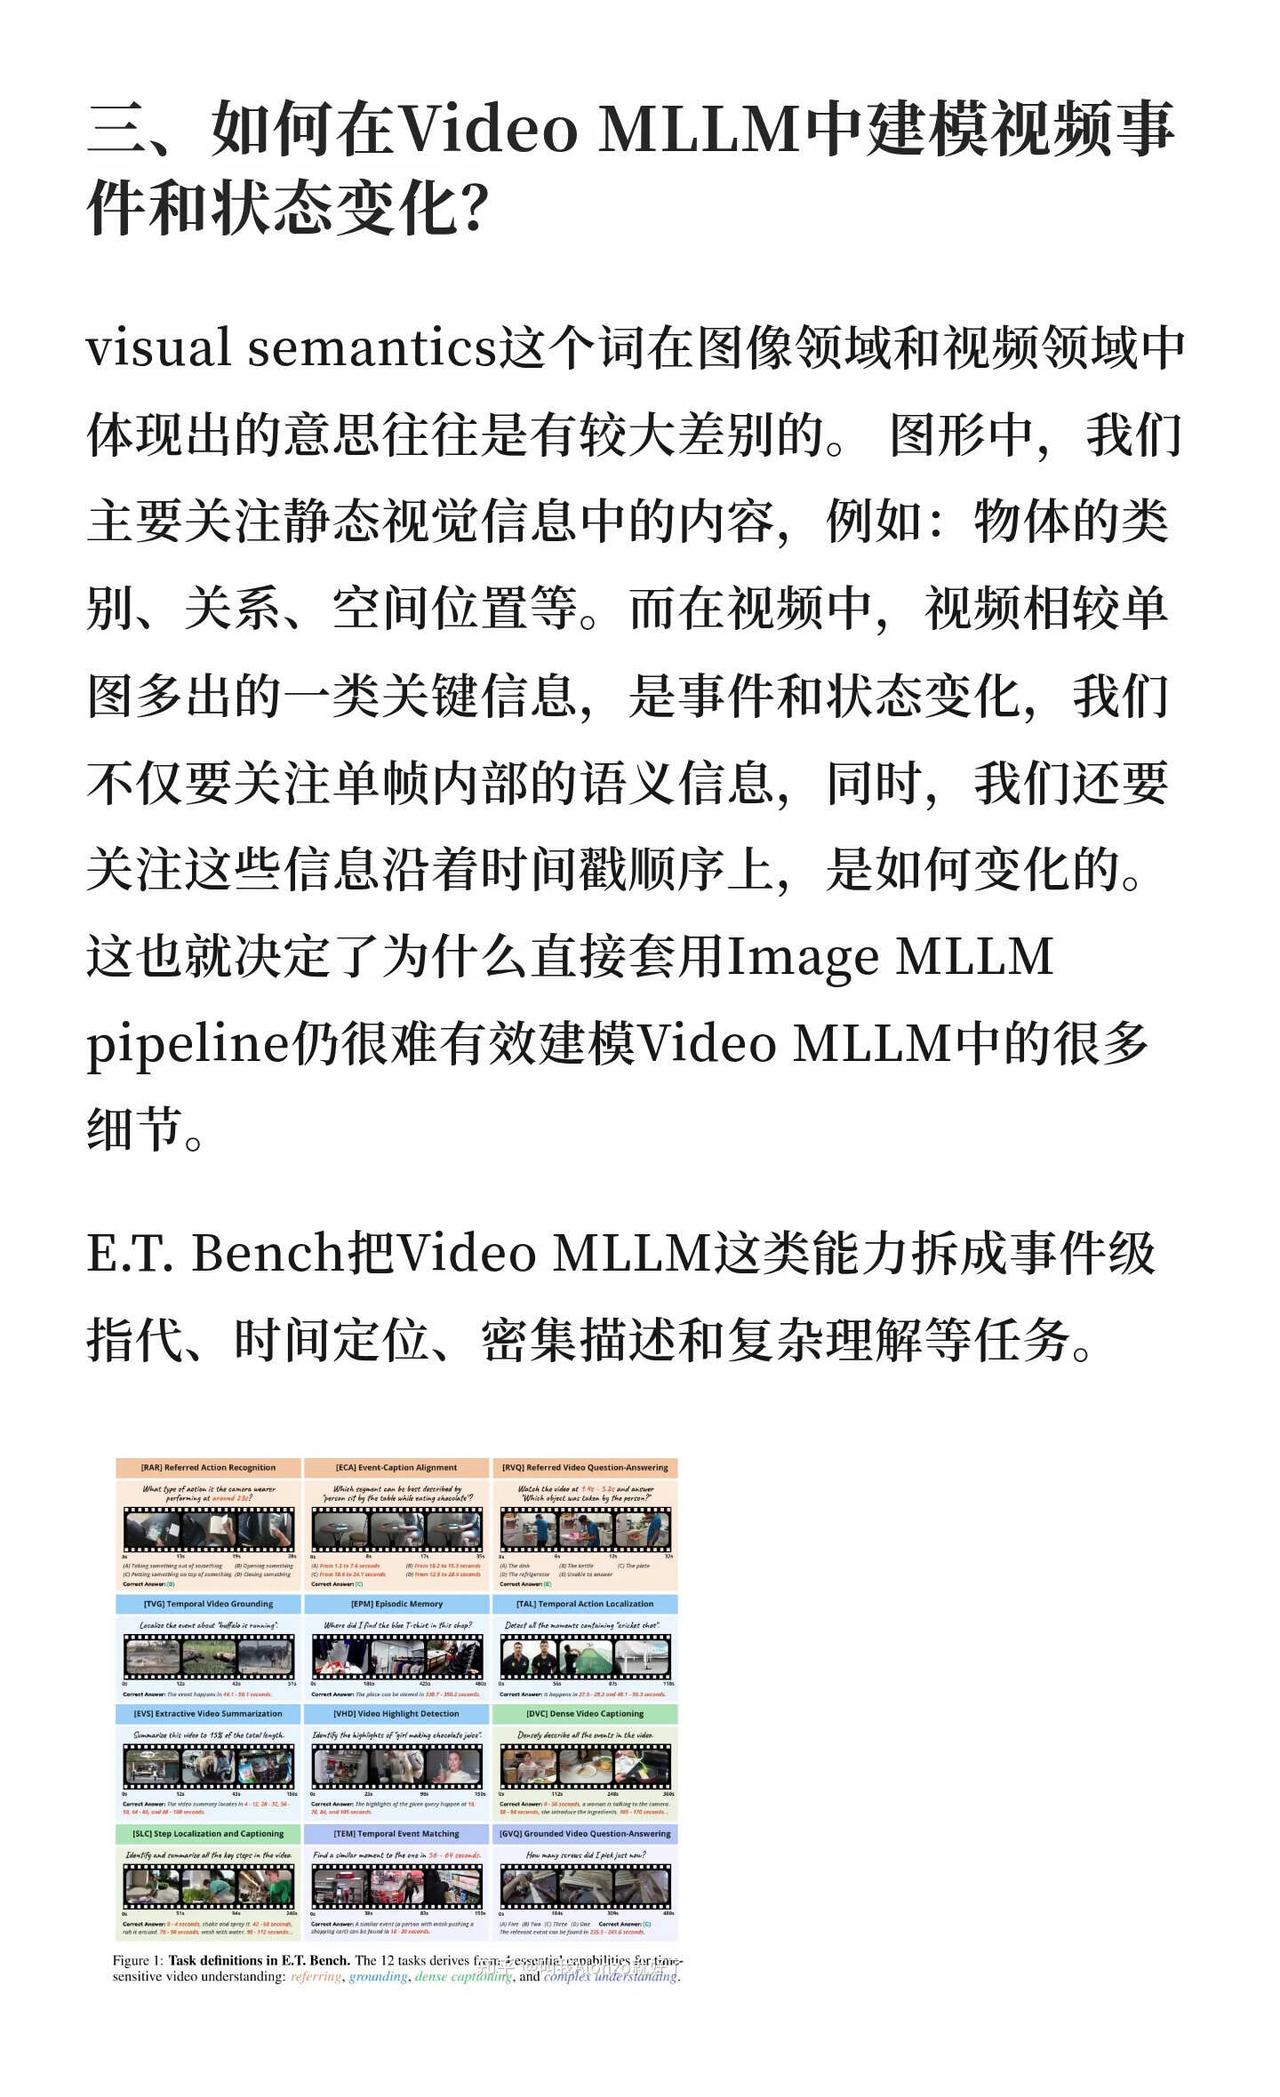
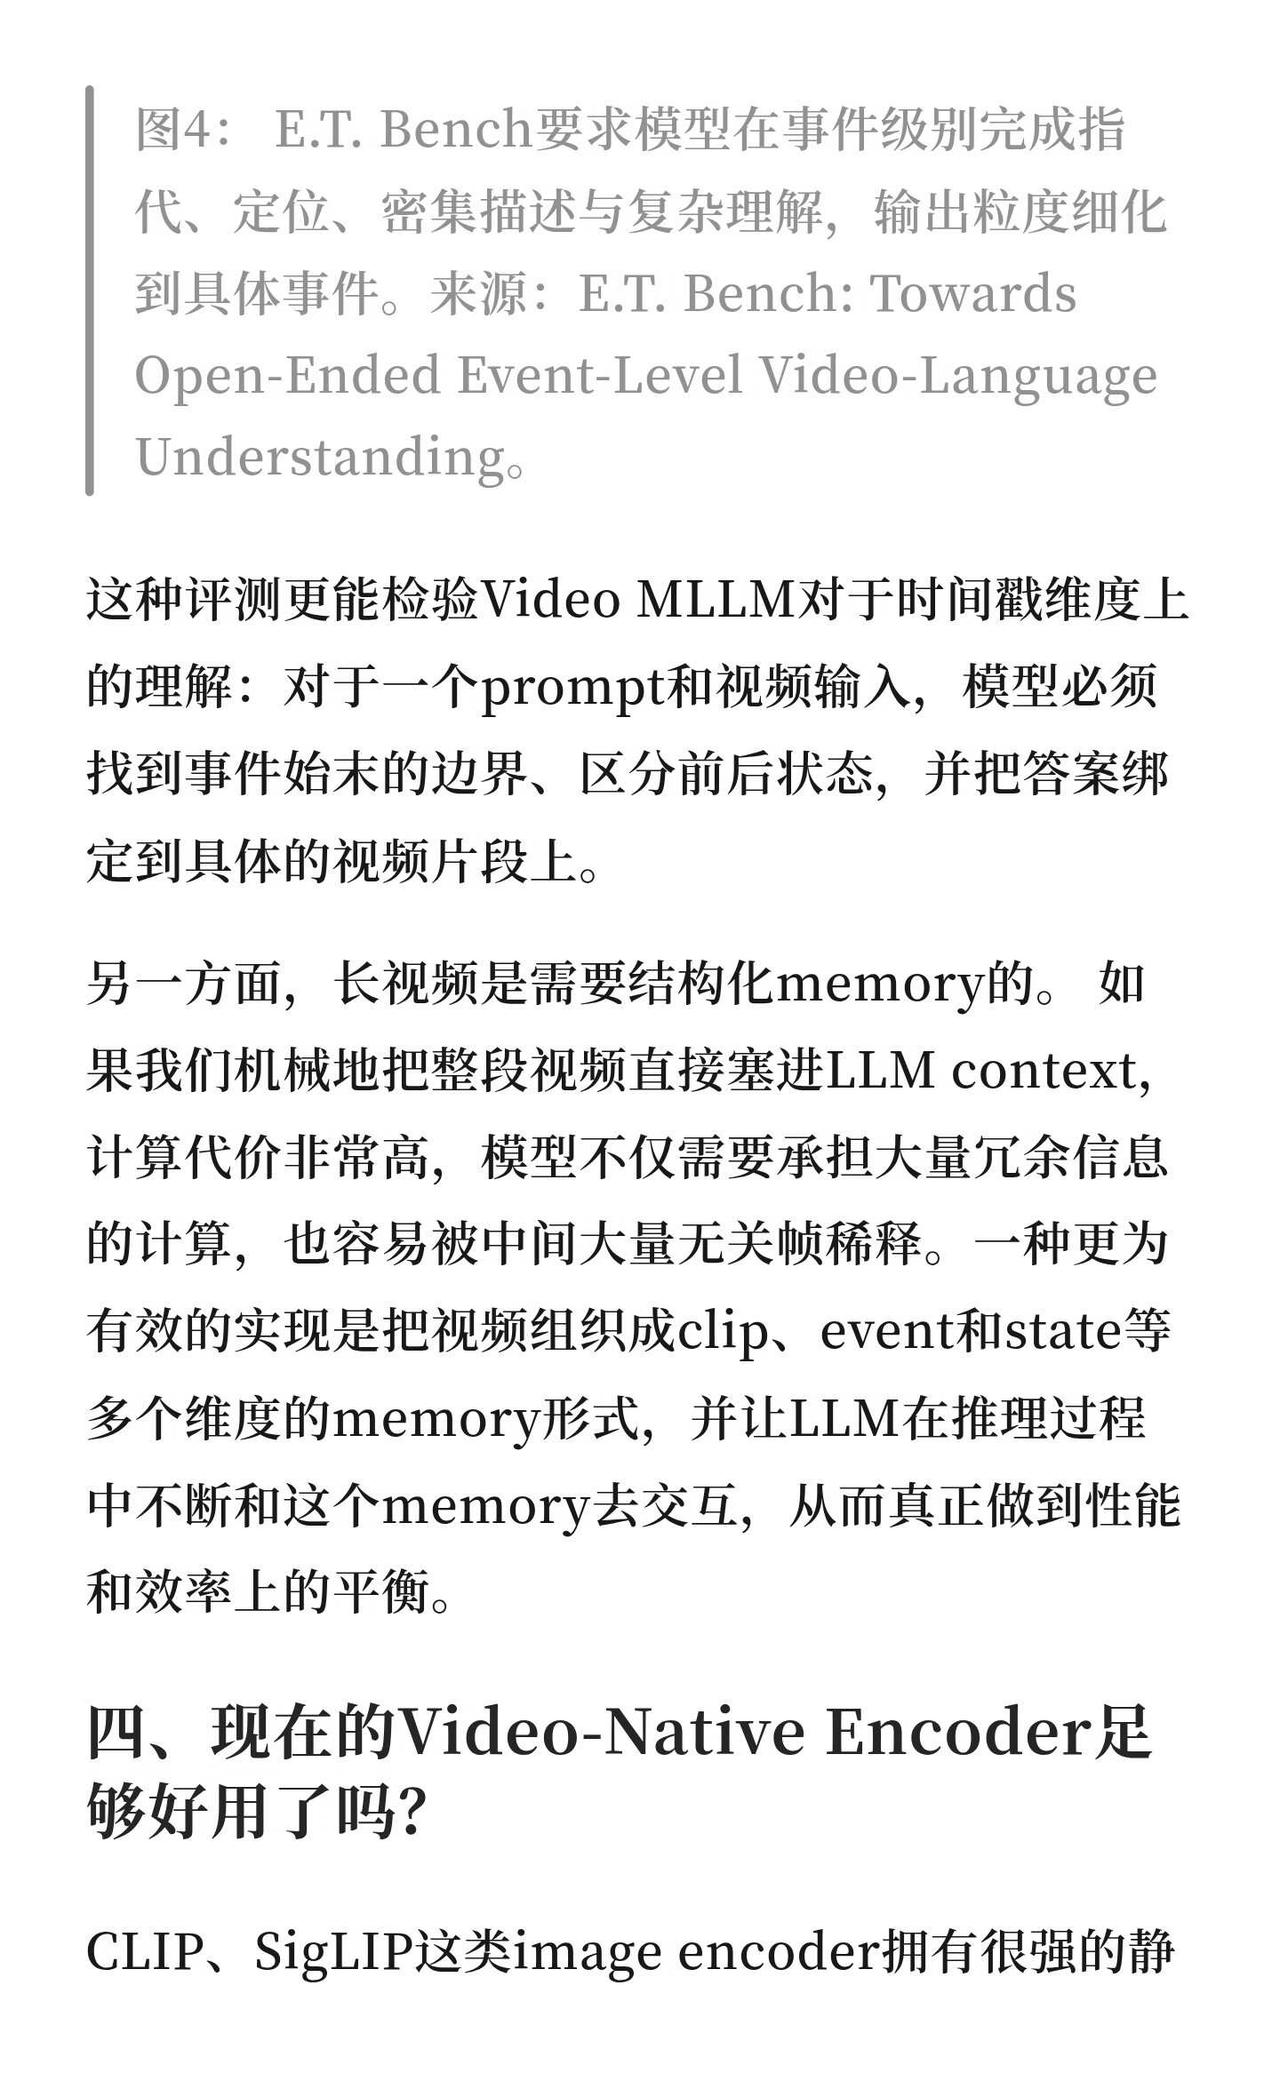
👉视频事件建模与结构化记忆: 1)从关注物体的静态Semantics转向建模随时间戳演进的Event与State Change;
2)探讨将视频组织为Clip、Event、State等多维度Memory,实现LLM推理性能与计算成本的平衡。
👉原生视频表征与评估范式:
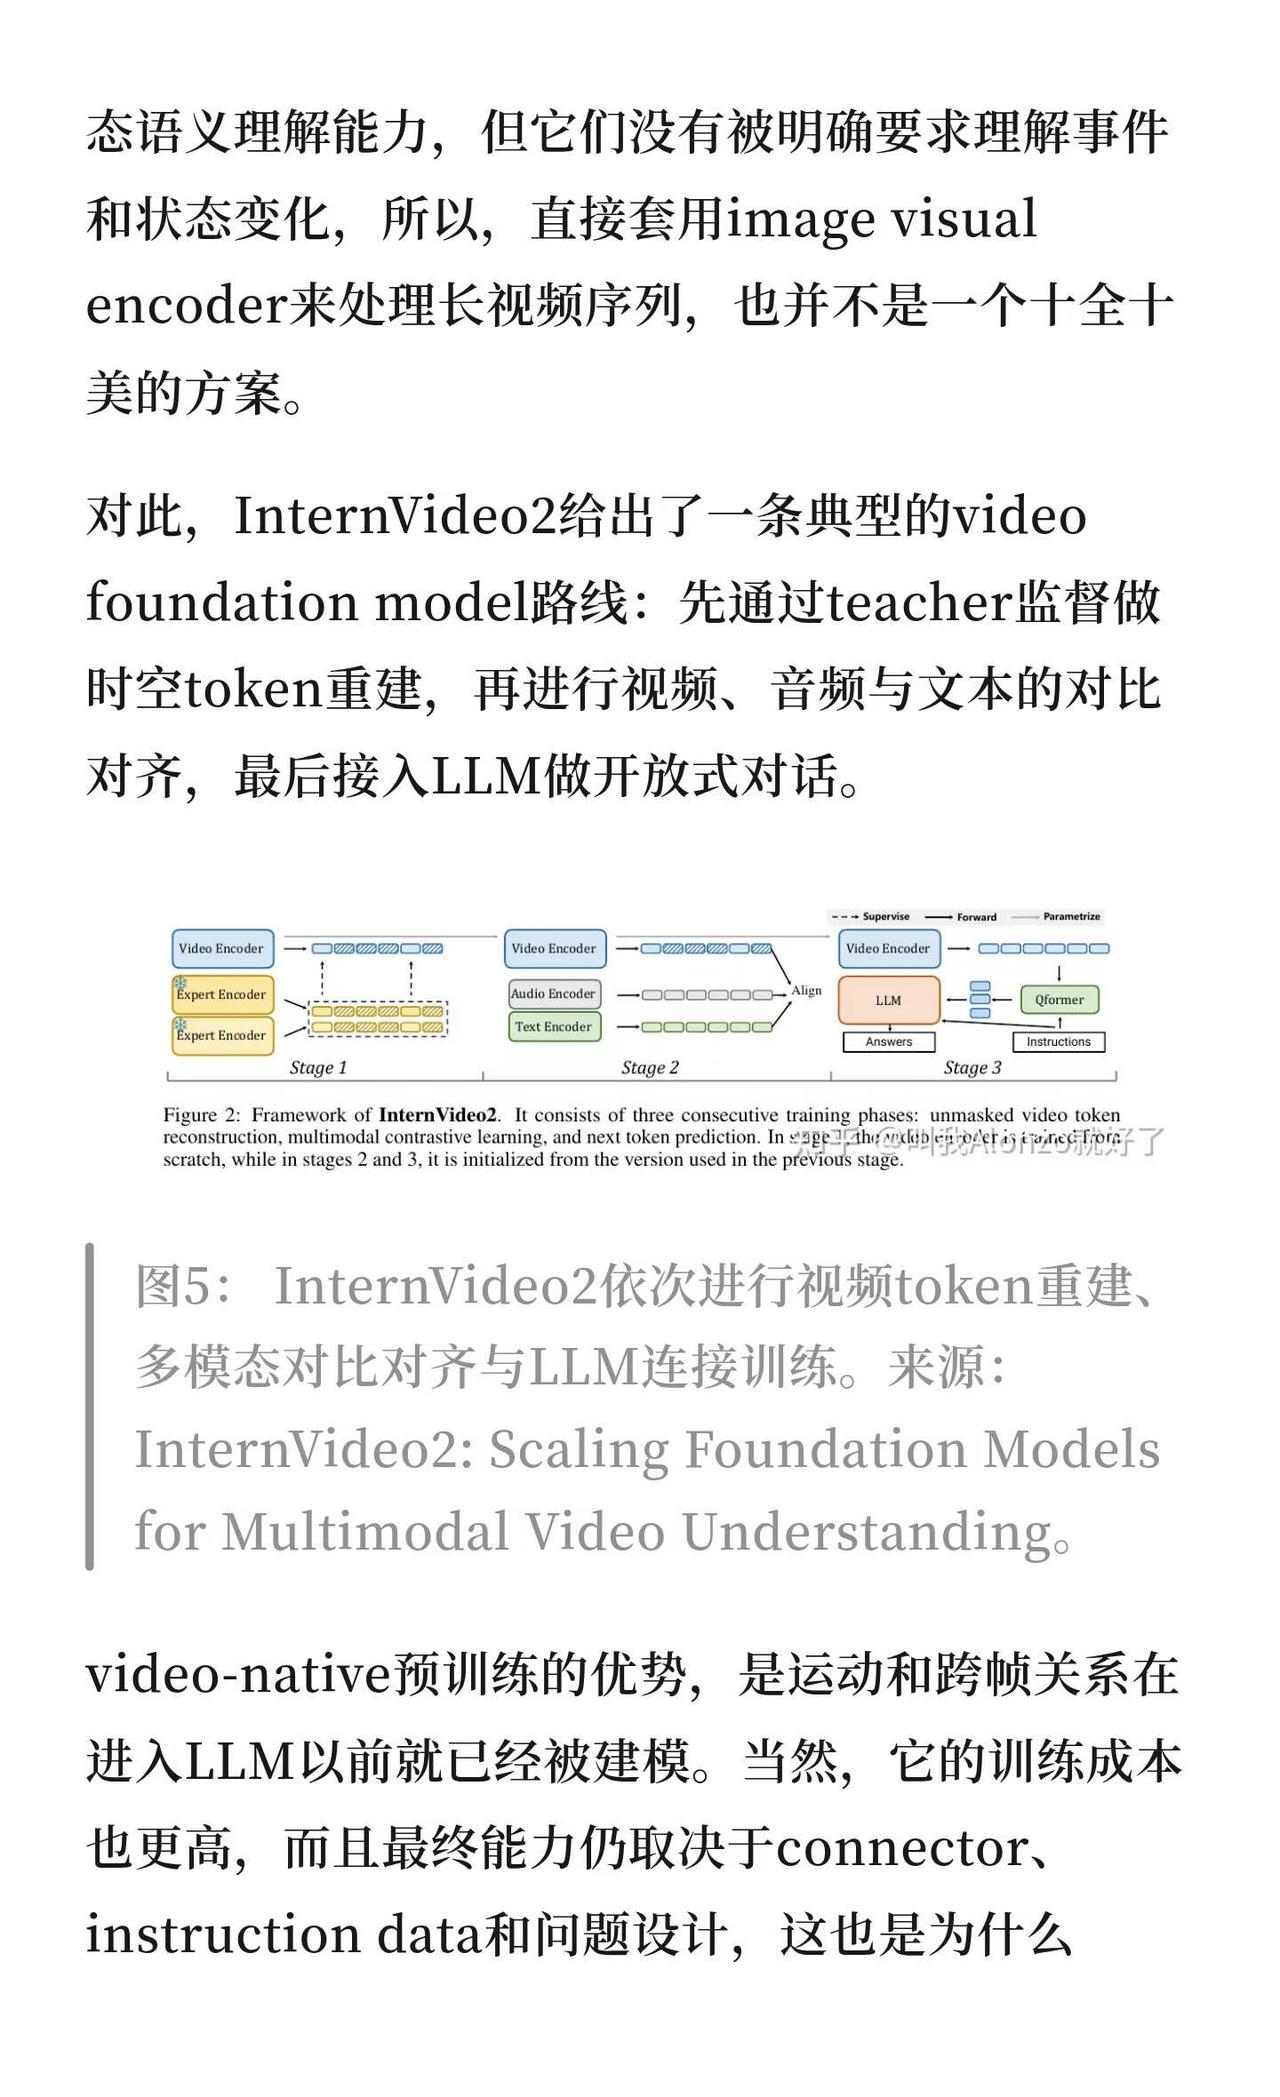
1)InternVideo2通过时空Token重建、多模态对比对齐构建Video-Native Encoder;
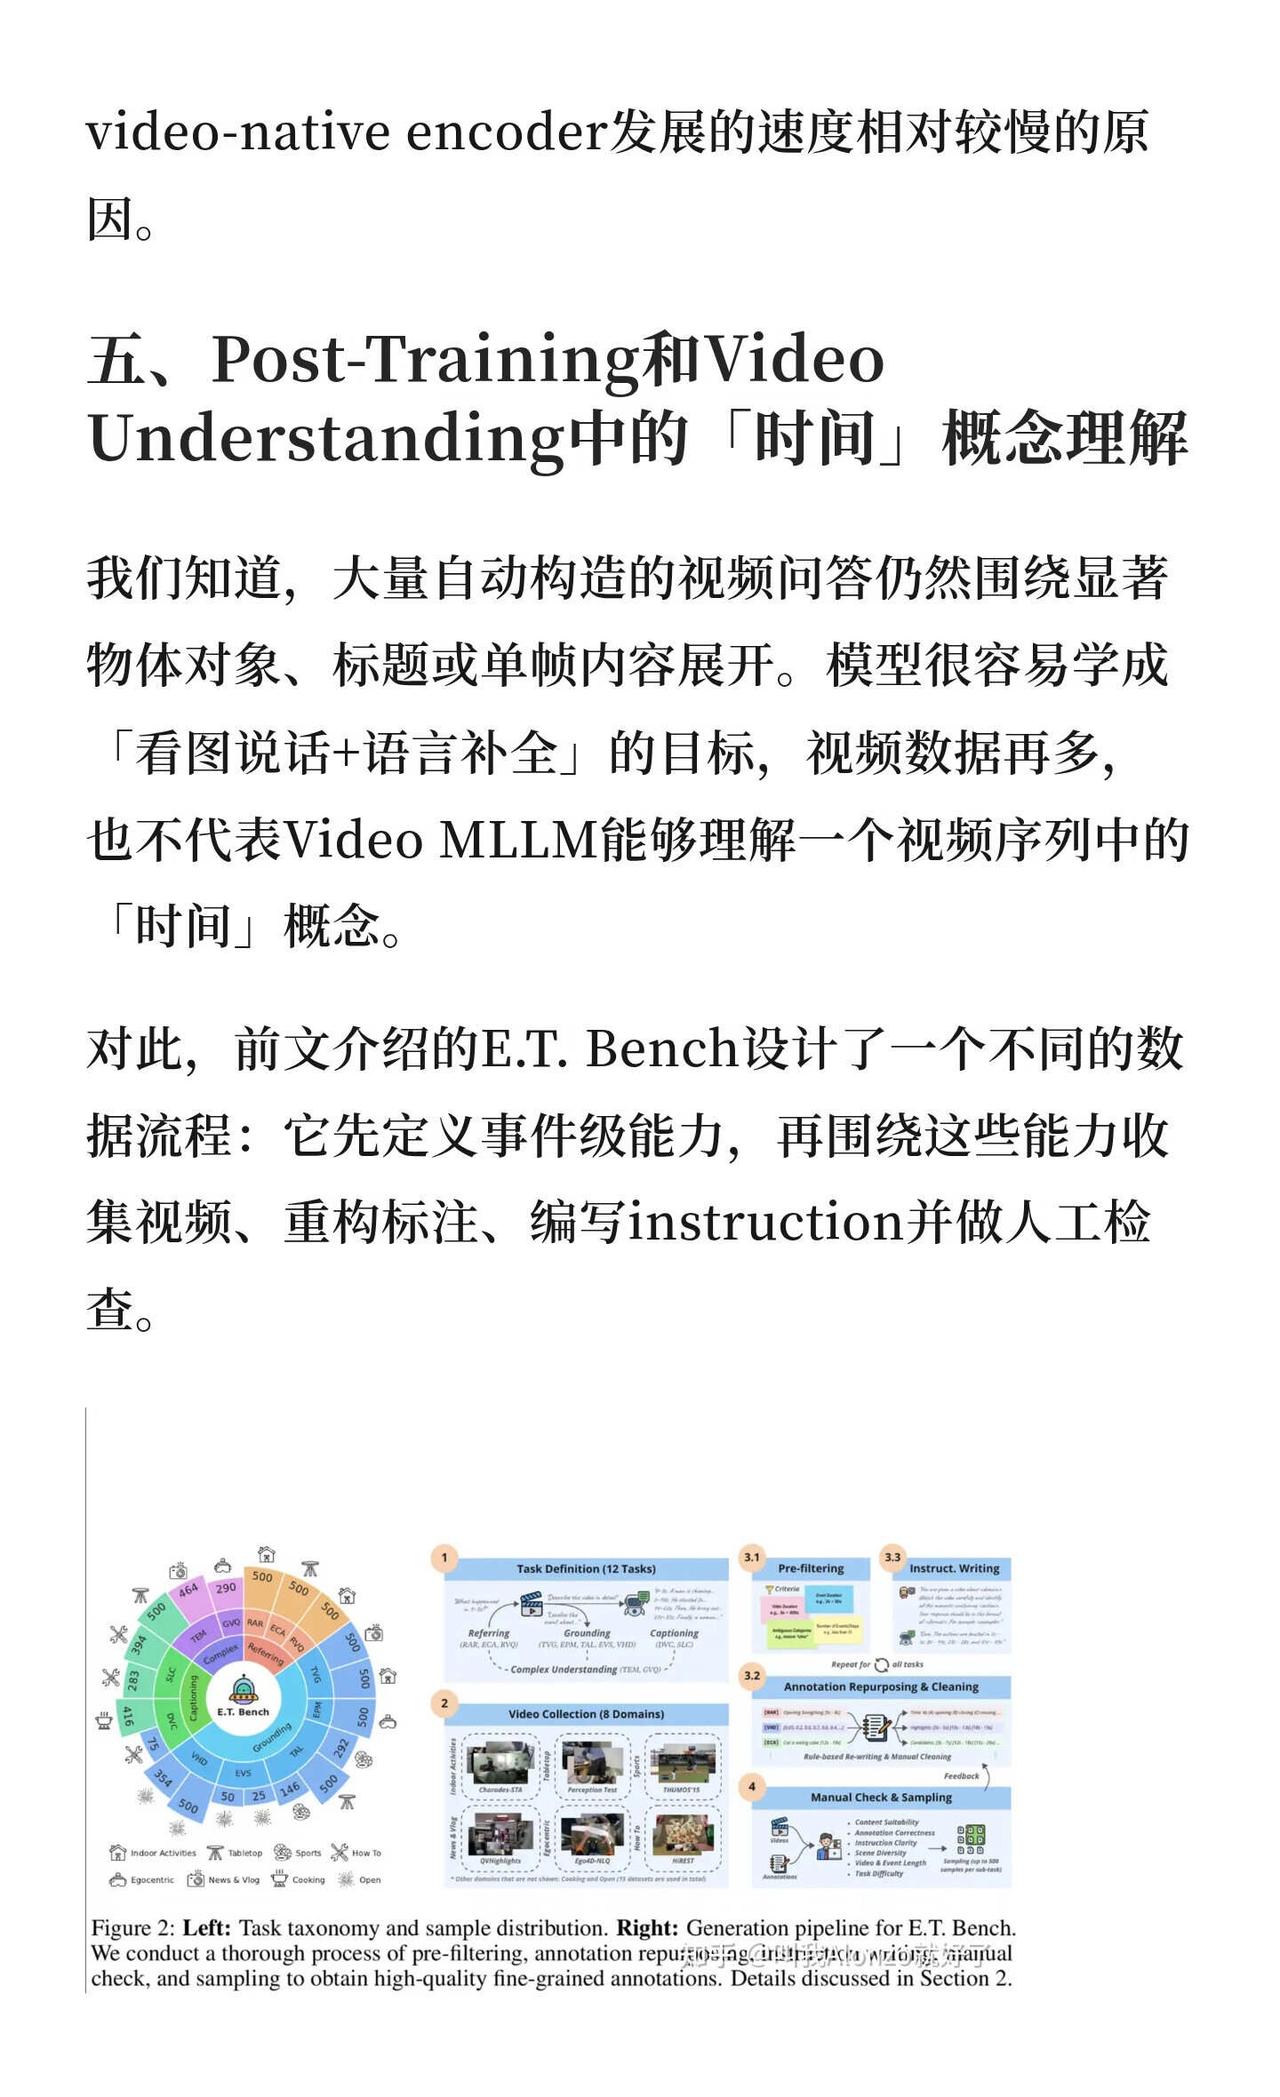
2)E.T. Bench通过定义事件级指令数据,强制模型利用时间证据,规避「看图说话」的Shortcut倾向。
(由于文字篇幅限制,具体细节麻烦大家移步图片~👆)
深度学习
扩散模型
计算机视觉
大模型
mllm