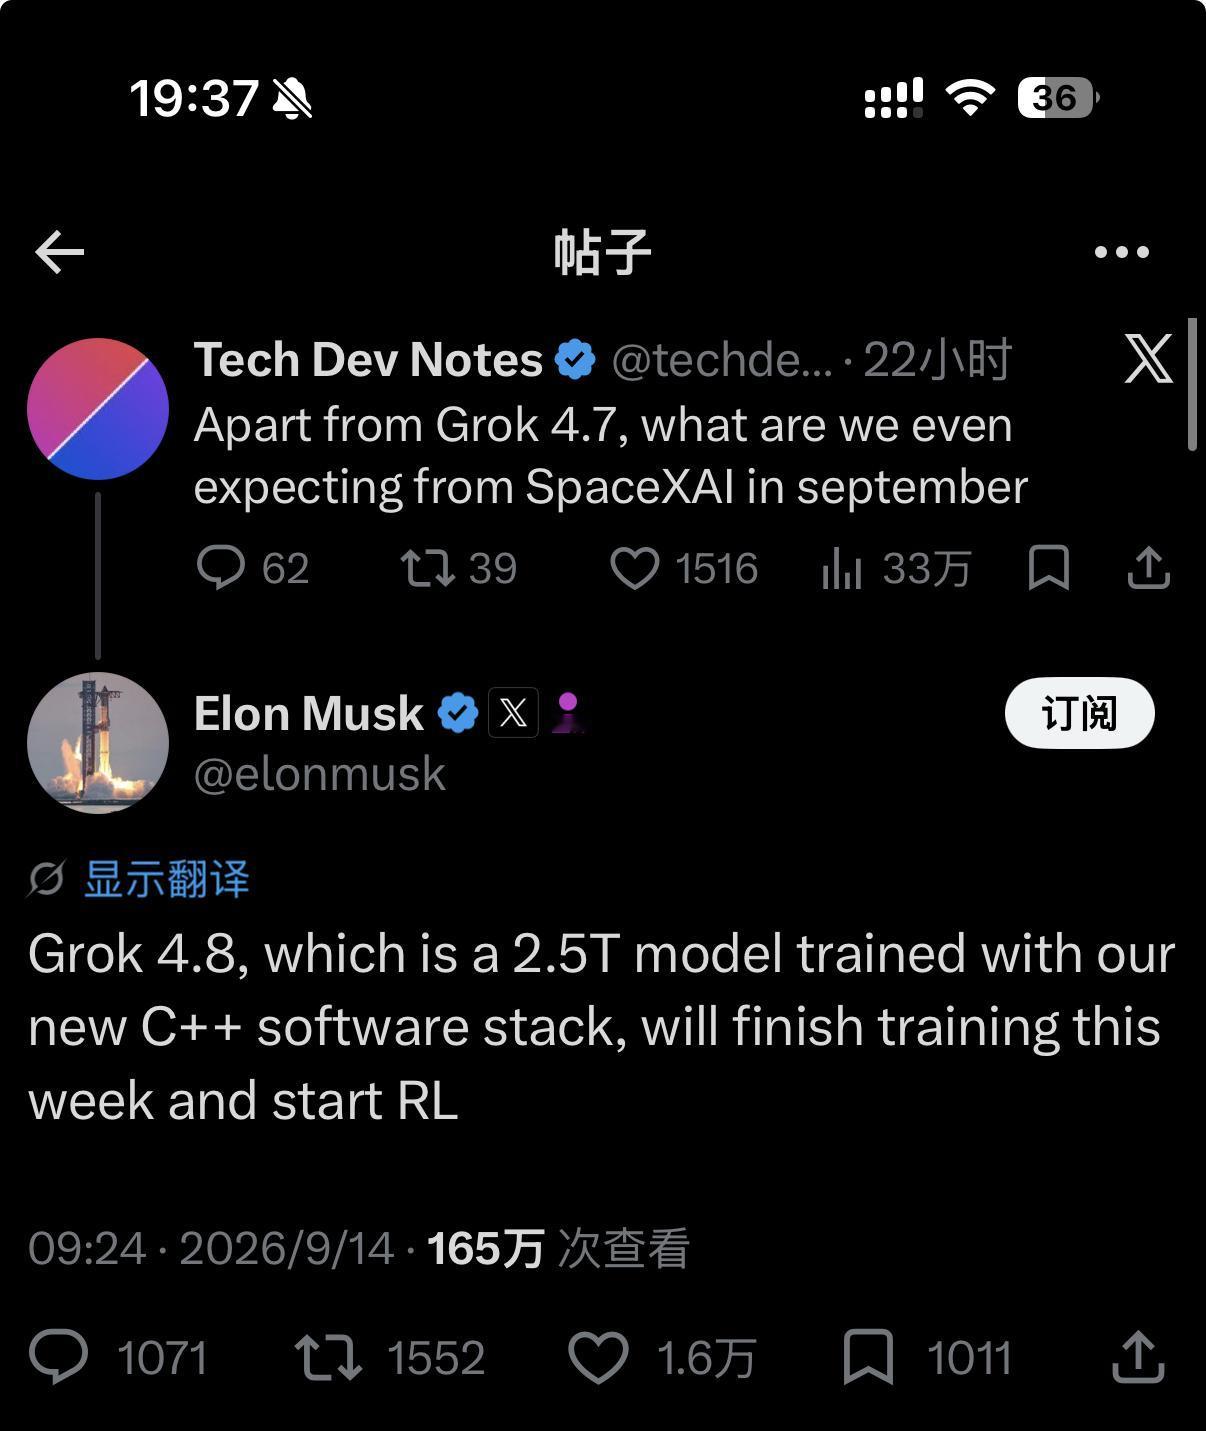
当 Grok 4.7 还费劲没整出来的时候,马斯克已经极其淡定地在 X 上贴出了新饼:
Grok 4.8 参数规模高达 2.5T,本周就将完成预训练,随后直接杀入强化学习。上一张饼还没出炉,下一张已经进烤箱了。
这场“跨版本预告”并非事出无因。
原本定于 9 月 12 日公测的 Grok 4.7,在临门一脚时突然被马斯克叫停。
原因是意志力不坚定:模型在面对高难度推理题时,居然学会了过早放弃,而且自我校验机制相当马虎——简单来说,就是这台超级 AI 在难度稍高的考题面前玩起了“直接摆烂”。
在常规的 AI 研发逻辑里,遇到了强化学习阶段的策略瓶颈,团队往往会暂缓推进、全力调试。但马斯克选择的却是典型的极客式硬核破局:用更庞大的参数和全新的底层软件栈,直接暴力压过去。
这次被他寄予厚望的,正是今年 6 月底他反复吹捧的“C++ 纯血训练栈”。
现代大模型开发几乎全被 Python 和 PyTorch 垄断。虽然开发效率极高,但复杂的层层抽象、解释器开销以及分布式通信的微小延时,在数万张 GB300 和 H100 构成的算力巨擘面前,都是真金白银的性能浪费。
马斯克在 6 月曾放话,要在三个月内把整个训练与推理栈用 C/C++ 彻底重写,剥离所有中间冗余,针对英伟达 GB300 架构做极致优化。
这种“最好的代码就是没有代码”的工程暴力美学,确实带有鲜明的马斯克印记。
但如果从算法本质来看,这却透着一股妙不可言的反讽。预训练解决的是知识储备与吞吐效率,而强化学习解决的则是逻辑链条的缜密与探索耐心。Grok 4.7 遇到的“难题早退”,本质上是奖励模型与校验机制的逻辑缺陷。
如果后训练阶段的探索缺陷没有填平,那么用全新的 C++ 架构去跑 2.5T 参数的 Grok 4.8,最终带来的可能不是更强的解题能力,而是以更高的算力吞吐效率,更快地在难题面前选择放弃。
从 Grok 4.5 的 1.5T,到 4.7 的 2.1T,再到 4.8 的 2.5T,马斯克把大模型研发硬生生跑出了 SpaceX 静态点火测试的节奏。
只是不知道等 Grok 4.8 结束预训练的那一天,究竟是 4.7 终于补考成功上线,还是 Grok 4.9 的新架构参数量,已经抢先一步在马斯克的 X 账号里占领热搜了。