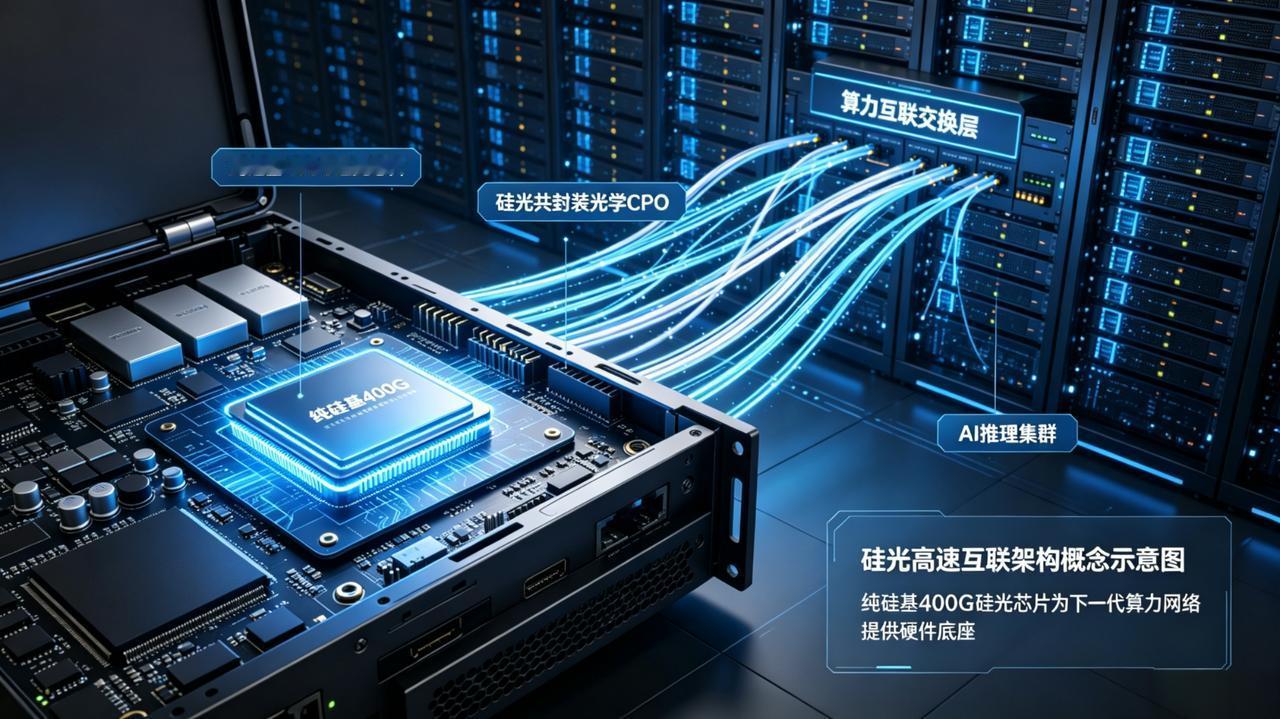
大模型算力越来越强,传统纯电芯片的带宽瓶颈已经成为全球AI产业的共同难题!全世界科研团队都在攻关光计算、硅光芯片技术,但长期受特种材料、复杂工艺限制,落地难度极大。
就在2026年9月13日,第十九届浦江创新论坛硅光创新发展专题论坛,国内一次性公开两项独立的重磅硅光领域全新技术成果,全部采用纯硅工艺,摆脱海外材料体系限制,推动国产光电算力技术从实验室迈向实际应用!
先给大家用大白话讲懂核心痛点。传统的电子芯片算力传输,就像狭窄的单向车流马路,数据量大了就会拥堵、延迟高、功耗高;而光计算、硅光互联技术,相当于给算力修了无数条并行高速通道,速度更快、损耗更低,是下一代AI算力升级的核心方向。
但过去全球高端光芯片、光电计算器件,高度依赖Ⅲ-Ⅴ族特种半导体材料,这类材料制备难度高、供应链长期被海外垄断,是长期卡脖子的技术痛点,也是制约国产光电算力落地的最大阻碍。本次论坛发布的两项成果,由两支不同科研团队独立研发、分别发布,不存在官方绑定协同方案,是国内硅光赛道同期两项里程碑式突破。
第一项核心成果,来自北京大学芯曜跃动团队发布的可编程空间光电异构AI推理芯片。
这款芯片拥有国内首创的数字光强累加与乘加拆分短光路架构,同时搭载电-光-电三维异构集成技术和团队自研流控编译器。
通俗解释:以往的光计算芯片光路设计冗长,极易受环境影响产生运算误差,稳定性差,很难做到可编程通用计算。而这款短光路架构,大幅缩短光信号传输路径,极大降低光损耗和运算误差,解决了传统光计算难以实用化的核心难题。
根据官方公开数据,该芯片成功将首Token延迟降至百微秒级别,能够高效适配主流深度学习框架,适配人工智能推理运算场景,大幅提升光电AI计算的实用性,填补了国产可编程光电异构推理芯片的技术空白。
第二项核心成果,来自上海赛勒光电子团队发布的纯硅基单波400G硅光芯片。
在全球行业内,想要实现单波400G的超高速光传输,行业主流方案均依赖稀缺的Ⅲ-Ⅴ族特种材料,工艺复杂、量产成本高、供应链受限。
而这款芯片是纯硅基全新技术方案,完全不依赖任何海外垄断的特种半导体材料,可直接适配国内成熟的CMOS硅基生产线,具备规模化量产的基础条件。
这项成果的核心价值,是为CPO共封装光学这一下一代算力互联核心技术,提供了国产化底层硬件支撑,有力推动国内高速光互联技术从实验室样机,走向产业落地应用。
我们做一个客观、严谨的全球横向对比。
目前海外头部企业和科研机构的硅光、光计算方案,普遍采用「特种材料+硅基异质集成」的技术路线,不仅材料受限、成本高昂,且多数光计算成果仅停留在实验室原理样机阶段,无法实现通用可编程、工业化量产落地。
国内本次两项纯硅技术成果,开辟了完全自主可控的国产化硅光差异化技术路线,规避了海外材料体系的技术封锁与供应链限制,补齐了国产光电算力芯片、高速光互联芯片的关键短板。
从技术应用价值来看,这两套全新成果,为超大规模智算中心、高速算力互联、通用AI推理等核心场景,提供了全新的国产化技术路径。依托纯硅工艺的高适配性、可量产性,能够有效降低下一代AI算力基础设施的建设门槛,为国内算力产业自主化发展筑牢底层基础。
从行业发展维度客观来讲,是国内硅光光电算力领域的重大阶段性突破。彻底验证了纯硅基光电计算、高速光传输的技术可行性,打破了海外特种材料的技术垄断壁垒,稳步推动我国硅光产业摆脱对外依赖,加速从技术研发阶段,迈入产业化落地的全新阶段。