[CL]《Sliding-window beats linear attention》A Jolicoeur-Martineau, R S Sukthanker, P Cameron, E Gervais [Microsoft] (2026)
在大型语言模型效率领域,如何低成本地解决注意力机制的二次方复杂度是一个悬而未决的难题。过去的方法聚焦于昂贵的线性注意力后训练,其本质原因是缺乏与一个更简单、免训练的基准进行公平对比。
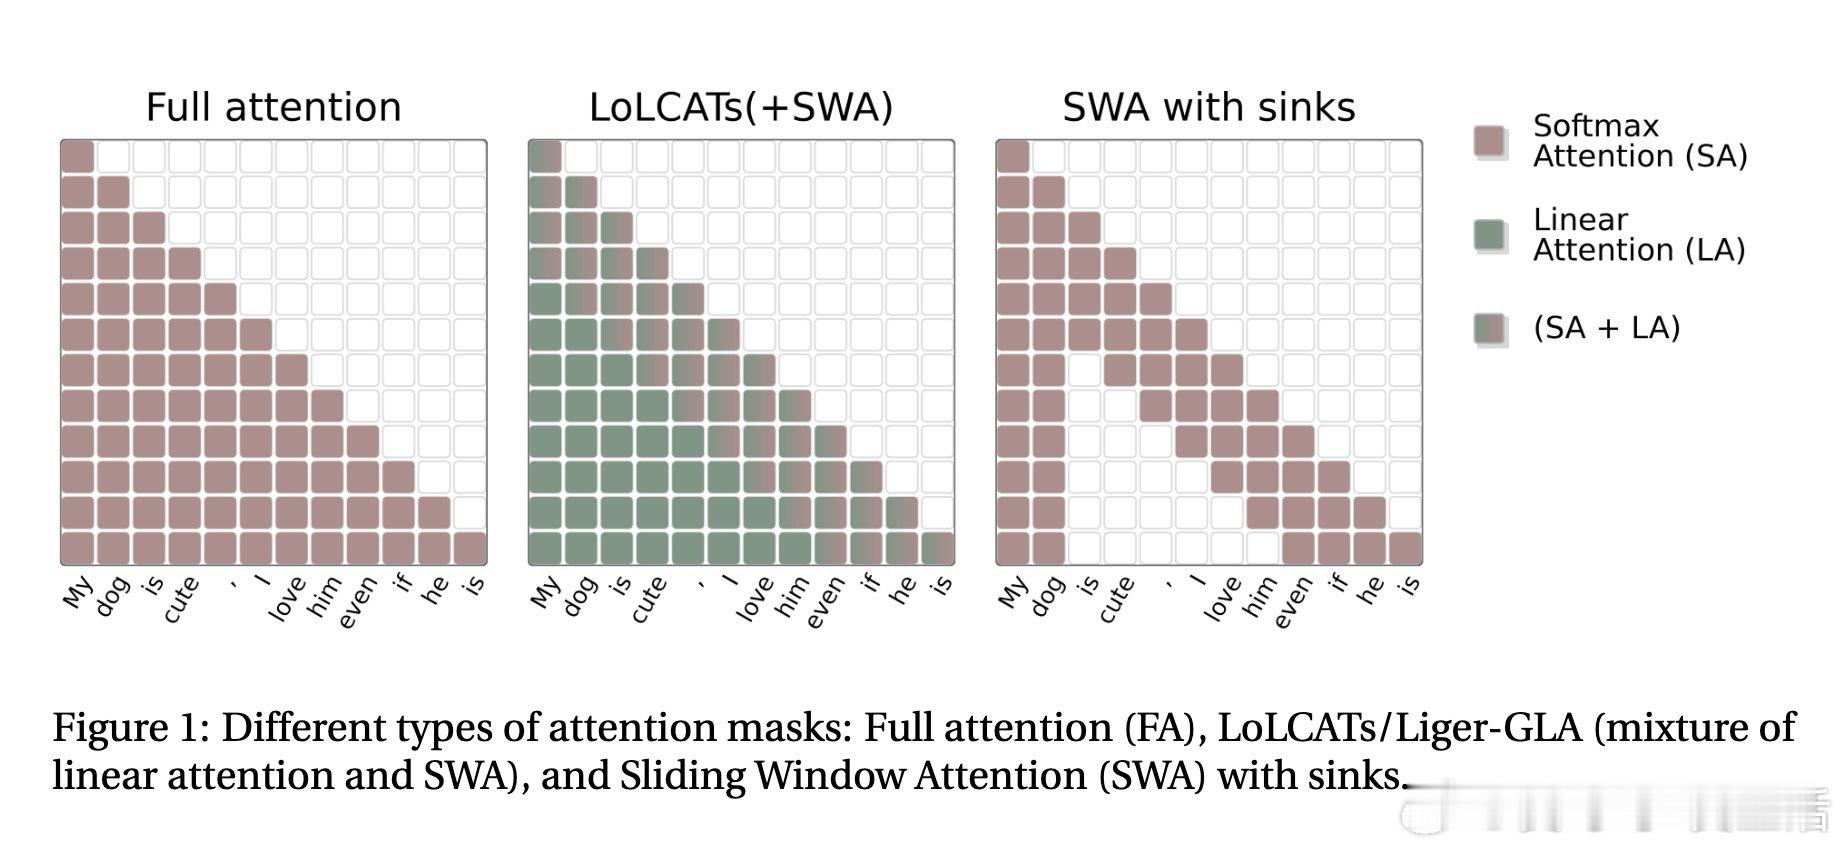
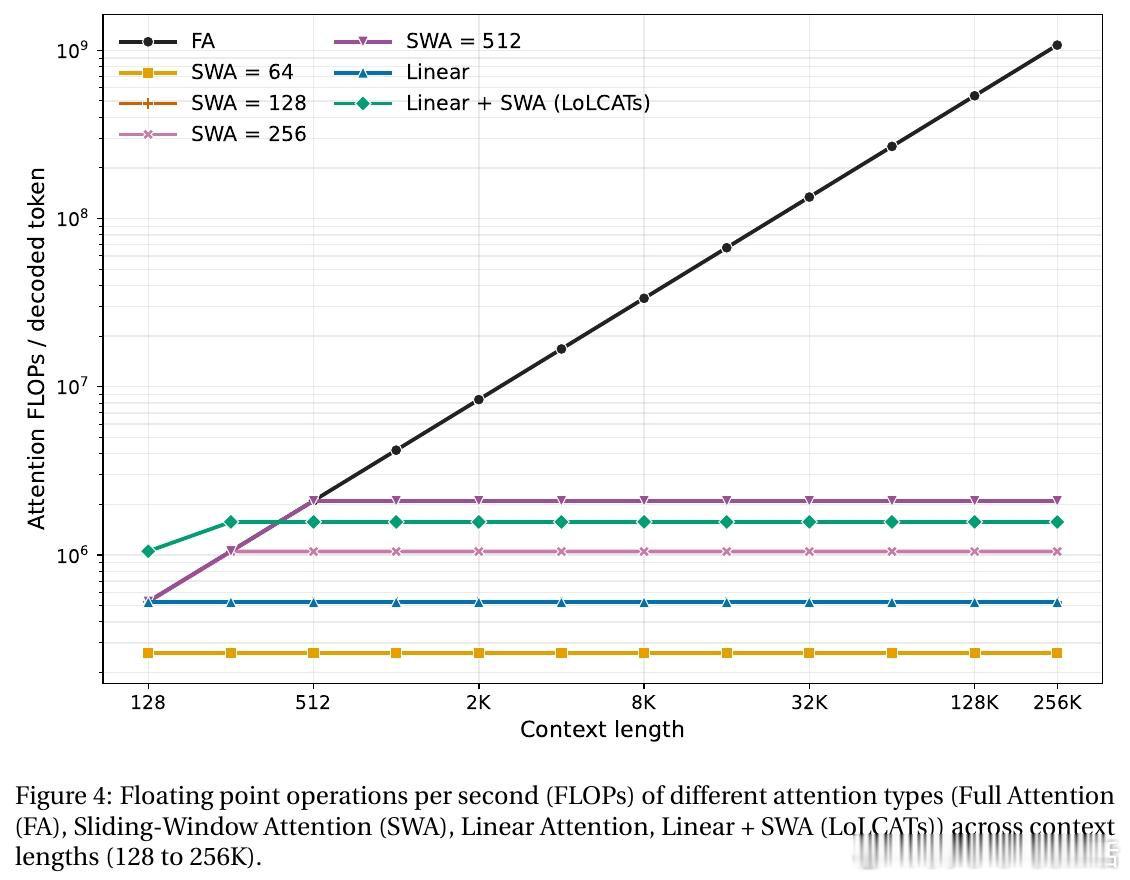
本文的核心洞见是:把“寻找新方法”重新看作“进行一次公平对决”。由此,让各种后训练的线性模型与一个被忽视的旧方法——带注意力汇(Sinks)的滑动窗口注意力(SWA)——直接进行性能比较,这一关键操作揭示了后者的优越性。
这项工作真正留下的遗产是:一个开箱即用且性能强大的LLM推理优化方案。它为后来者打开的新门是,在追逐复杂架构前先用简单基准重新审视问题本身,但尚未跨过的门槛是,探索SWA经由后训练能达到的性能极限。
arxiv.org/abs/2608.28444 机器学习 人工智能 论文 AI创造营