【今日头条 · 微头条】知识库召回率从50%逆袭到82%:我踩过的RAG最大工程盲区
• 文字篇幅:约 560 字 (符合微头条 300~600 字黄金快读区间)
• 推荐配图:单图或三图配置
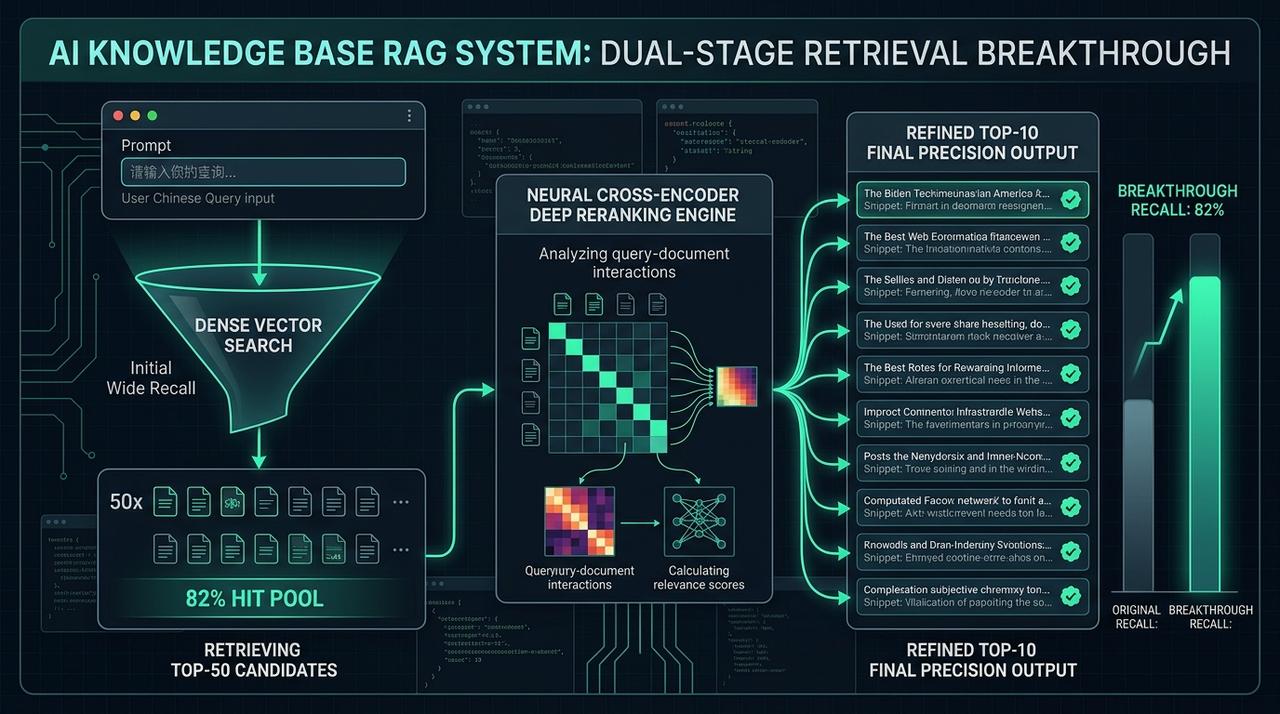
• 图 1: 全链路架构与双阶段检索漏斗
• 图 2: 跨语言语义空间漂移与对照实验对比图
• 图 3: 512字符截断陷阱与沉底打捞破案图
• 挂载话题:程序员 大模型 RAG知识库 人工智能
微头条正文
把 148 本国外经典技术大部头全部切分进向量库,整整 50,602 个向量分片。我以为这个自建知识库已经强无敌了。
结果写完第一批自动化评测集一跑:检索命中率正好 50.0%!有一半的关键事实,系统压根搜不出来!
更离谱的是,无论我怎么微调向量权重还是融合排序,命中率仅仅从 66% 爬到 68%,换排序算法几乎毫无卵用。
到底丢在哪了?排查底层 Chroma 向量库:5 万个分片全部在库,0 丢失!
那为什么进不了前十?我们调出相似度分数一看,真相让人哭笑不得:
因为 148 本书全在讲大模型和 Agent,目标分片得分 0.638 排在第 14 名,而另一本同类书拿了 0.680 冲到第 1 名。仅仅 0.04 的微弱分差,就足够把正确答案挤出前十!同类书太多,Top-10 根本挡不住“神仙打架”!
接下来我们做了一个对照实验:保持向量库不动,把中文题目换成原汁原味的英文问句。命中率当场从 66% 暴涨到 84%!足足多命中 9 道题!
这证明瓶颈是中文与英文书库的语义空间漂移。但用户不可能改用英文提问,系统必须在内部解决!
我们最终用两阶段架构逆袭:
1. 粗排不再死卡 Top-10,直接放宽到 Top-50 宽召回(候选池命中率瞬间拉满到 82%);
2. 本地挂载 Cross-Encoder 重排模型进行深度交叉交互。中间排查掉一个 512 字符硬截断 Bug 后,8 道沉在 11~48 名的分片 100% 被打捞回前十,0 误杀!Top-10 命中率直接飙到 82.0%!
0 次调用外部大模型,纯本地毫秒级推理搞定!
做 RAG 别再去调 Prompt 了,架构选型和底层评测才是硬道理。你在做知识库时遇到过这种同类文档互踩的暗坑吗?
程序员 大模型 RAG知识库 人工智能
程序员 大模型 RAG知识库 人工智能