全球唯一内置光源的量产NPO光引擎落地!华为首发全新架构AI超节点,不靠堆模块、不靠堆功耗,用全新光电互联方案,解决了超大算力集群长期以来的世界级高速通信难题!
2026年9月17日,上海华为全联接大会2026现场,华为轮值董事长汪涛正式发布全球首个搭载NPO近封装光学引擎的昇腾960超节点,搭配自研Hi-ONE NPO近封装光学引擎,刷新了当前大规模AI算力集群高速互联的量产技术上限。
用大白话通俗解释行业核心痛点:过去搭建超大规模AI算力集群,只能依靠海量传统光模块堆叠组网。模块数量越多,整机功耗越高、布线越复杂、故障率越高,一旦扩展到几十万卡超大集群,功耗和运维压力会达到行业难以承载的极限,这也是全球超算、智算中心长期卡脖子的工程难题。
而华为本次创新,大幅减少光模块数量、极致降低整机功耗,彻底优化了传统堆叠方案的固有缺陷。同等算力规模下,仅需5500个Hi-ONE光引擎,即可替代传统方案4.8万颗800G光模块,整机功耗直接降低超550千瓦,系统可用度高达99.8%,集群稳定性、能耗效率实现跨越式升级。
本次搭载的Hi-ONE NPO光引擎,是当前全球传输容量最大、也是行业唯一实现内置光源的量产NPO产品,单光引擎带宽达到7.2T。
这里补充全球行业客观技术背景:
目前全球下一代光电互联主要分为两条差异化路线,CPO共封装光学、NPO近封装光学。
CPO技术理论带宽上限更高,但硬件架构改动极大、设备不可维护、量产落地难度大,短期内无法适配大规模商用智算集群;
而华为NPO是介于传统可插拔光模块与高端CPO之间的务实最优路线,既实现了接近CPO的超高互联性能,又完整保留了设备可维护、可替换、易部署的优势,是目前全球唯一可大规模落地的高阶算力互联量产方案。
对比海外所有在售、在研NPO产品,海外厂商全部采用外置光源方案,链路结构繁琐、信号稳定性弱、集成度低;华为首创内置光源一体化设计,从硬件底层规避信号漂移、链路损耗问题,量产成熟度、集成度、稳定性、能耗比全面全球领跑。
在核心算力规格上,昇腾960超节点参数完整且行业顶尖:
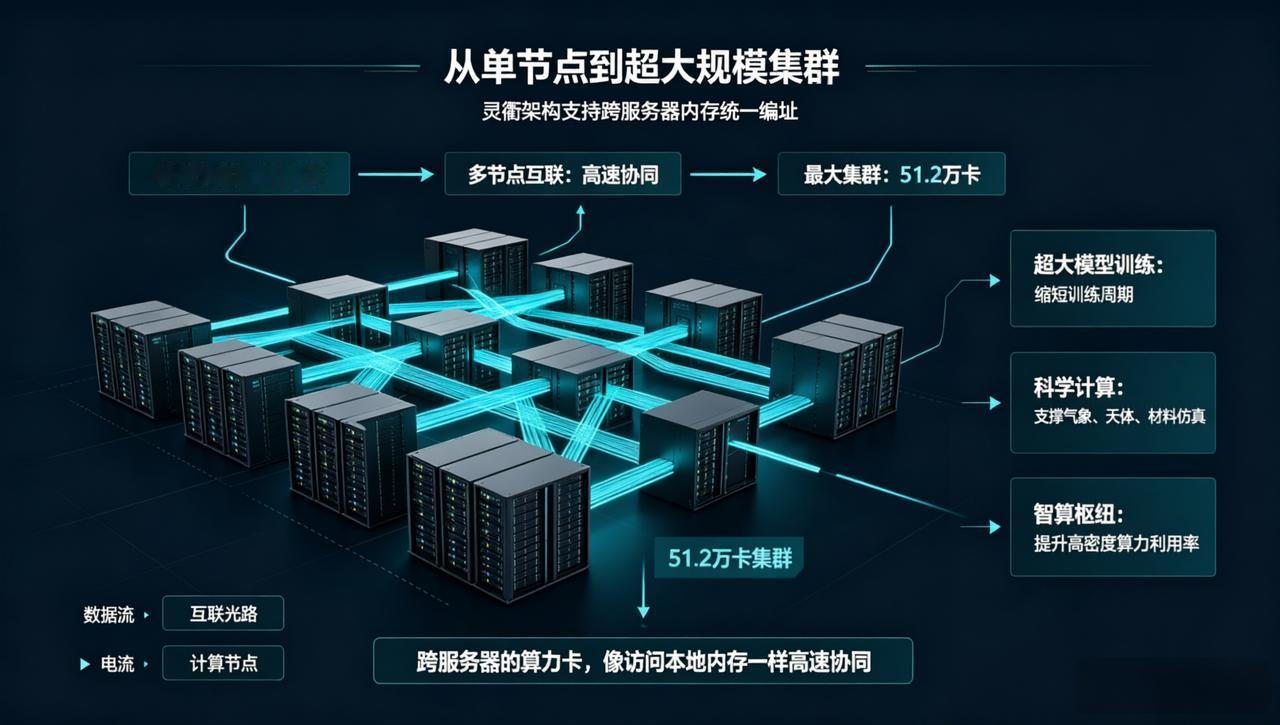
单超节点最大支持4096卡算力扩展,搭载1PB超大HBM显存容量,算力可达8EFLOPS(FP8)、16EFLOPS(FP4);依托华为自研灵衢架构,实现跨服务器内存统一编址。通俗理解:跨服务器的海量算力卡,能实现如同单机本地内存一般的高速互通,彻底消除跨设备数据搬运延迟。
多节点集群组网状态下,整套系统可平滑扩展至51.2万卡超大规模集群,专门适配十万亿级别超大型AI模型的完整训练与高强度推理任务。
从全球技术格局来看,华为本次成果属于首创量产落地的NPO超节点体系,攻克了超大算力集群高速互联、高功耗、难运维的世界性工程难题。在高端算力光电互联领域,摆脱了海外传统技术路线的局限,走出了完全自主可控、可规模化普及的国产算力基础设施路线,打破了长期以来海外光电互联方案的技术垄断格局。
在核心应用场景中,这套系统具备不可替代的价值:
超大模型基础训练场景,解决几十万卡协同运算的通信瓶颈,大幅压缩千亿、万亿、十万亿级大模型训练周期;
高端科学计算场景,支撑气象全域模拟、宇宙天体仿真、新材料分子推演等高精尖科研的超算任务;
国家级智算枢纽建设场景,以低功耗、高集成、易运维的特性,适配东数西算大型算力基地规模化落地建设。
目前全球多家权威算力科研机构、光电技术行业媒体,均将本次昇腾960+Hi-ONE NPO组合,定义为下一代大规模智算中心的标杆级量产方案,为全球超大规模AI集群建设提供了全新标准化技术路径。