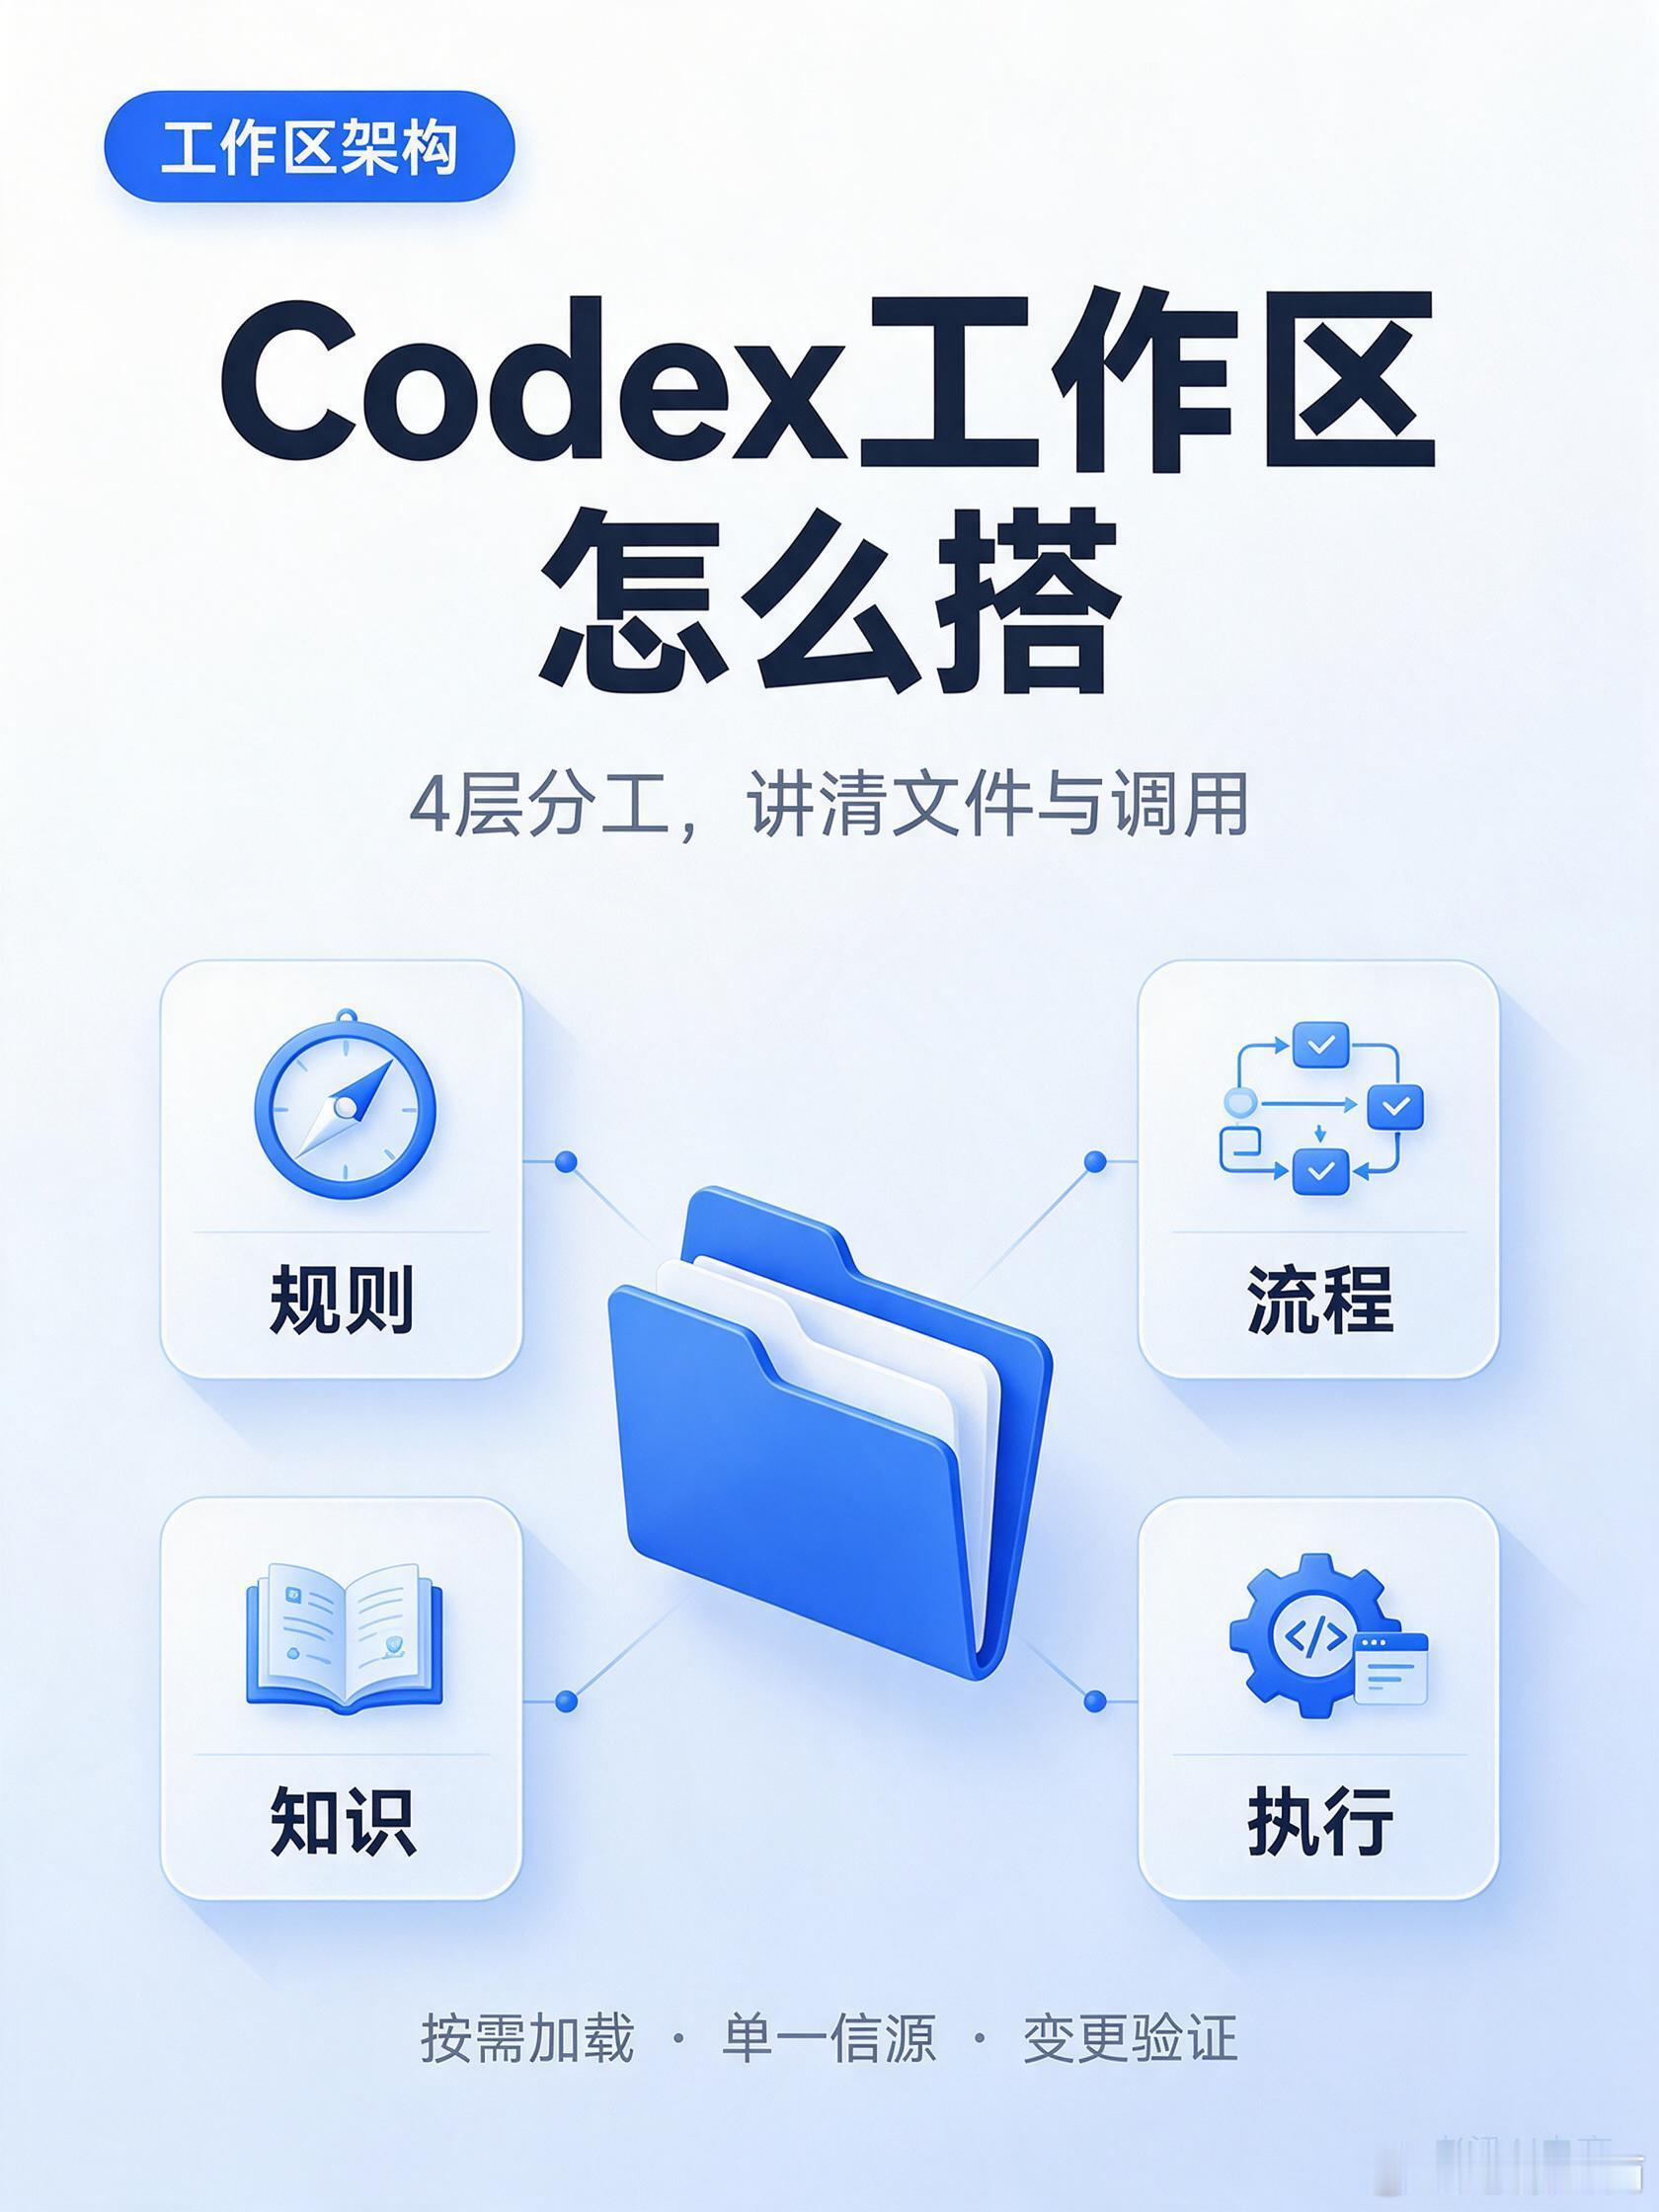
Codex 工作区,先把四件事分清:长期规则、任务流程、事实与方法、程序执行。
分清以后,才能回答三个具体问题:这次任务应该读什么?结果出错应该查哪里?资料更新应该改哪一份?
假设一个工作区同时负责小红书、商品主图和详情页。商品参数分别被复制进三个流程,更新时只改了两处,第三个流程就可能继续使用旧参数。
再假设,标题方法、产品知识、工具参数和权限要求,全都写进一份越来越长的 AGENTS.md。每次调整,你都需要先判断这一段会影响哪些任务。
这些问题可以通过清楚的文件职责和调用关系来处理。
下面用一条“根据商品资料写小红书”的示意任务,把工作区怎么搭讲清楚。
📌 01|四层分工:每一层都有明确职责
这里的“四层”是一种推荐的工程组织方法。它用于帮助设计工作区,不是要求所有项目照搬四个固定目录。
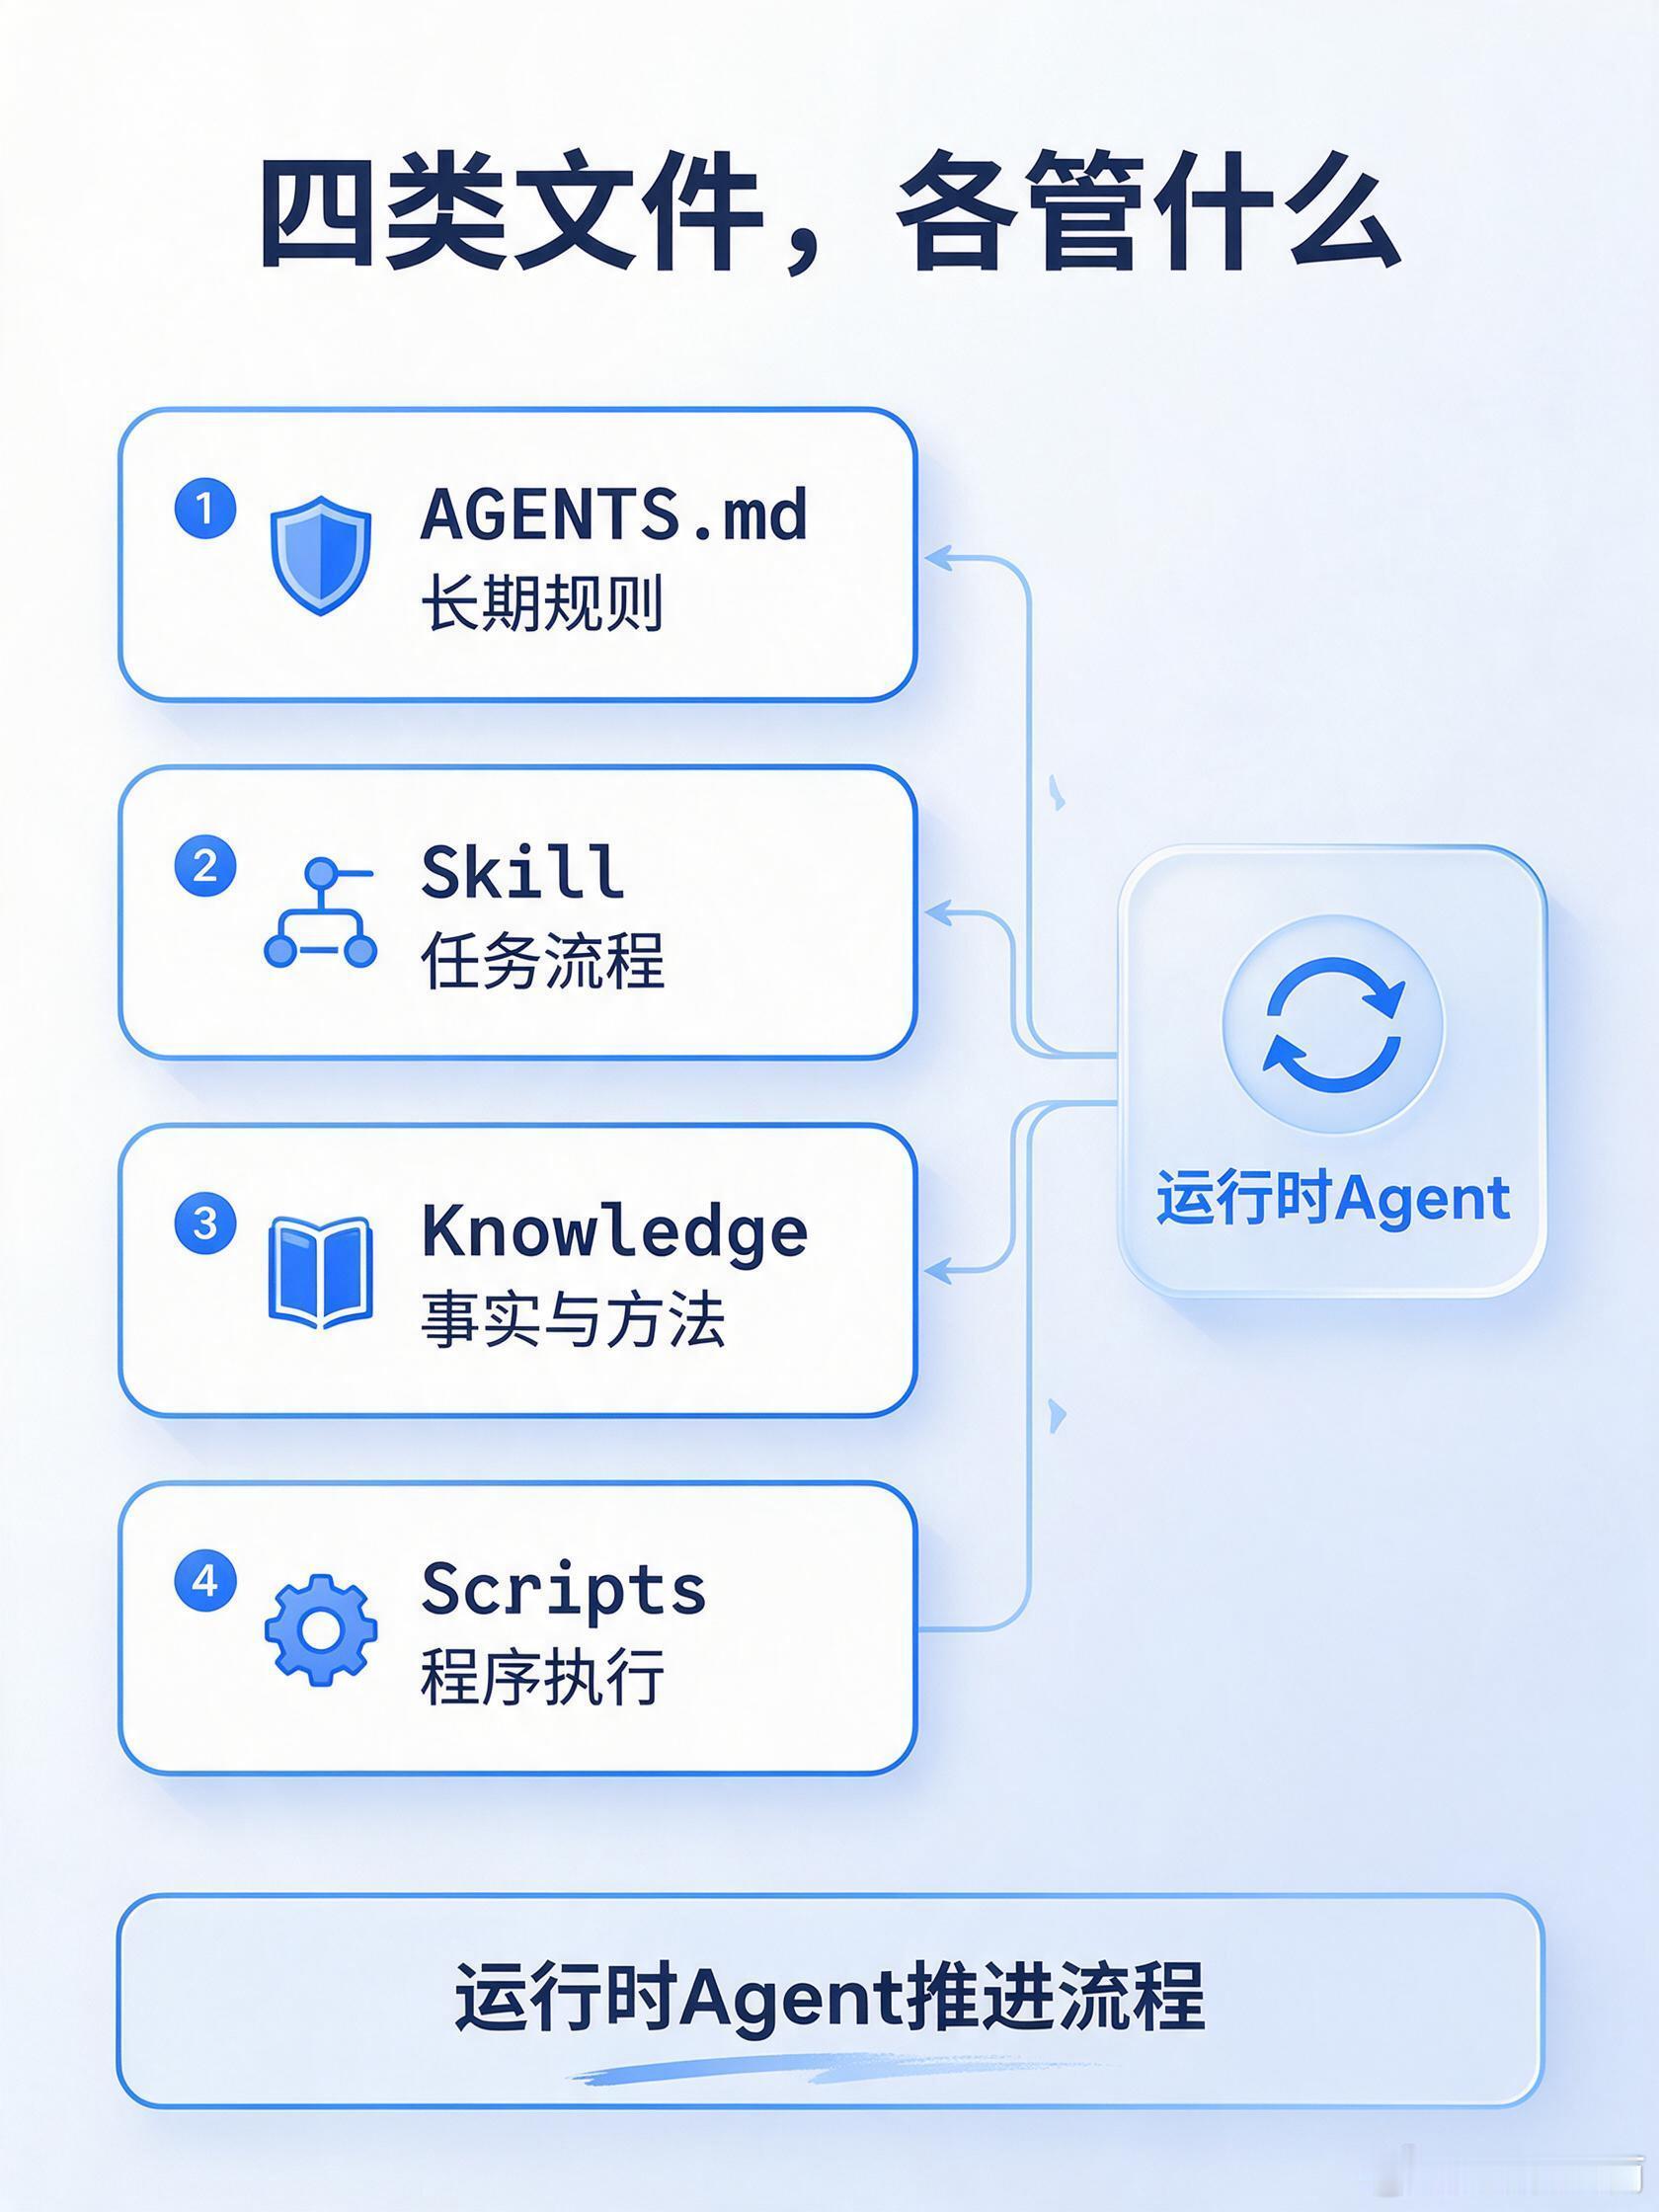
① AGENTS.md:长期规则与导航
适合放跨任务持续生效的要求:
这个 Agent 负责什么;允许访问哪些资料;哪些操作需要授权;结果怎么验收;到哪里寻找对应流程。
例如,“不得编造产品参数”“缺少关键依据时必须报告”,会影响多种任务,适合放在长期规则中。
某一种标题的具体写法,则可以交给对应的方法文件维护。
AGENTS.md 可以提供流程导航。Skill 自身的名称和 description,也要准确说明适用任务,方便 Agent 选择。
② Skill:一类任务的完整流程
Skill 要讲清楚:
什么情况使用;需要什么输入;先做什么、后做什么;每一步交付什么;什么条件下可以继续;缺资料或失败时怎么办;最后如何判断完成。
例如,小红书流程可以规定:
理解商品 → 分析人群与场景 → 确定角度 → 写标题和正文 → 检查事实。
当前任务包含图片时,再进入配图策划与生图步骤。
③ Knowledge:事实、方法与判断依据
商品参数、适用范围、证据资料,属于事实。
怎样判断一个卖点是否有支撑,怎样匹配目标人群,怎样评估标题,属于方法与标准。
Skill 规定“先分析人群,再写标题”;Knowledge 说明“依据什么分析、怎样判断分析是否成立”。
④ Scripts:可以程序化的执行
计算、数据转换、文件命名、批量处理、字段检查等操作,可以交给脚本。
业务假设仍需要保持可见。
例如,“缺失值能否按零处理”要有明确依据。脚本应执行已经确定的规则,维护者也应该能找到这条规则的来源。
如果脚本调用的是生成模型,它可以规范请求和保存过程,但模型生成的内容仍有不确定性。
📌 02|目录按照使用关系组织
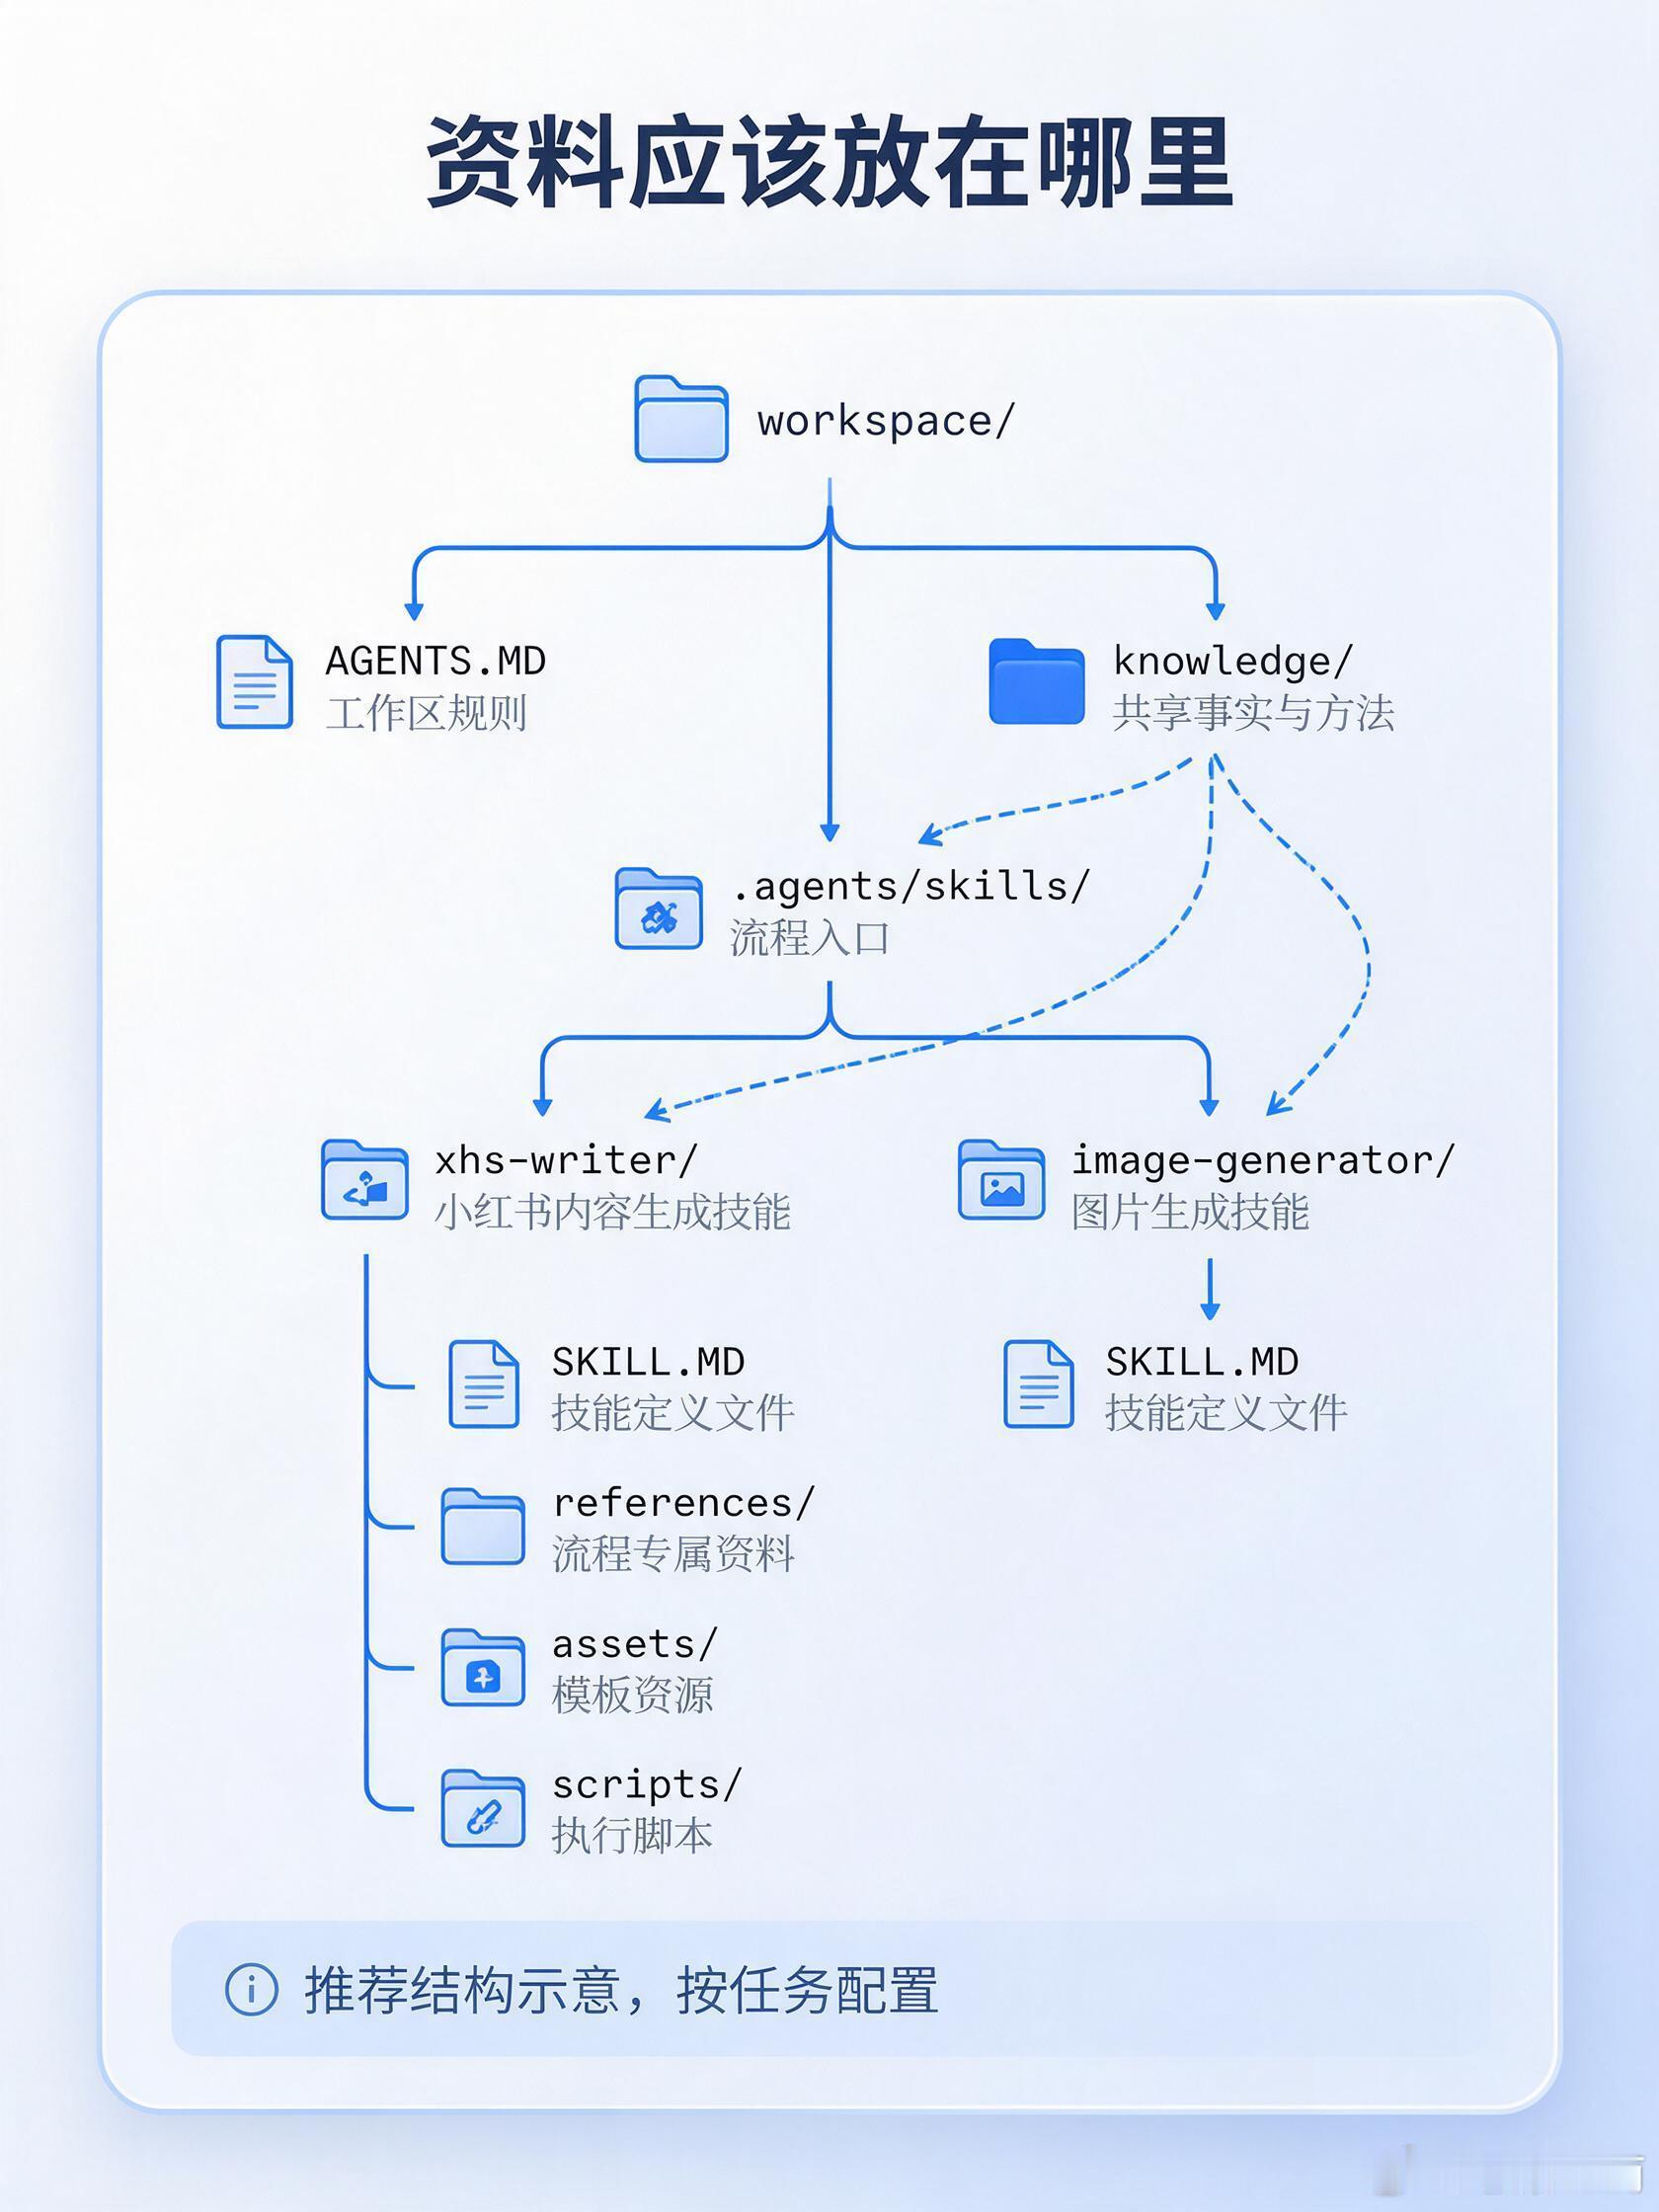
下面是一种结构示意,展示文件可以怎样分工,并不代表这些文件已经具备可运行的内容:
```textworkspace/├── AGENTS.md├── knowledge/│ ├── products/│ │ └── product-a.md│ └── methods/│ └── product-understanding.md├── .agents/│ └── skills/│ ├── xhs-writer/│ │ ├── SKILL.md│ │ ├── references/│ │ ├── assets/│ │ └── scripts/│ └── image-generator/│ └── SKILL.md├── output/└── .runtime/```
项目 Skill 按 `.agents/skills//SKILL.md` 组织,入口文件写清名称、description 和流程。
跨多个流程共用的商品事实、产品理解方法,可以放在共享 knowledge 中。
只服务小红书的标题标准、正文方法,可以放在 xhs-writer 的 references 中。
assets 可以放交付模板等资源;scripts 按实际需要添加。
knowledge 是一种资料组织约定。建立这个目录以后,仍需要在流程中明确引用哪些文件、什么时候读取。
文件拆分也要适度。
可以独立更新、独立使用的方法,适合单独成文。总是一起使用、体量又很小的内容,可以放在同一份文件里,减少来回查找。
📌 03|步骤之间,要传递明确的结果
假设任务是:
“根据商品资料,写一篇面向新用户的小红书笔记,并策划配图。”
流程可以这样设计:
第一步,读取商品资料。
交付的是「已确认事实、对应依据、资料缺口」。
第二步,分析人群与场景。
交付的是「目标人群、使用场景、需求与卖点的对应关系」。
第三步,确定内容角度。
交付的是「本篇解决哪个问题、使用哪些事实、哪些表述缺乏支撑」。
第四步,写标题和正文。
继承前面已经确定的事实与角度,形成完整内容。
第五步,策划图片。
交付每张图的用途、图中文字、视觉结构及必要素材。
第六步,在本次授权包含生图时,进入生图流程。
这样,下一步拿到的是可继续使用的结果,而不是一句“上一步已经完成”。
正文阶段知道目标人群是怎么确定的,配图阶段知道哪些卖点有依据,验收阶段也能回到来源核对。
Skill 中还要规定停止条件。
例如,商品适用范围缺失,就先标记缺口;涉及适用范围的内容,不能靠模型猜测补齐。
这些步骤由运行时 Agent 按流程推进。SKILL.md 提供的是工作说明,实际读取、判断和工具调用仍需要执行者完成。
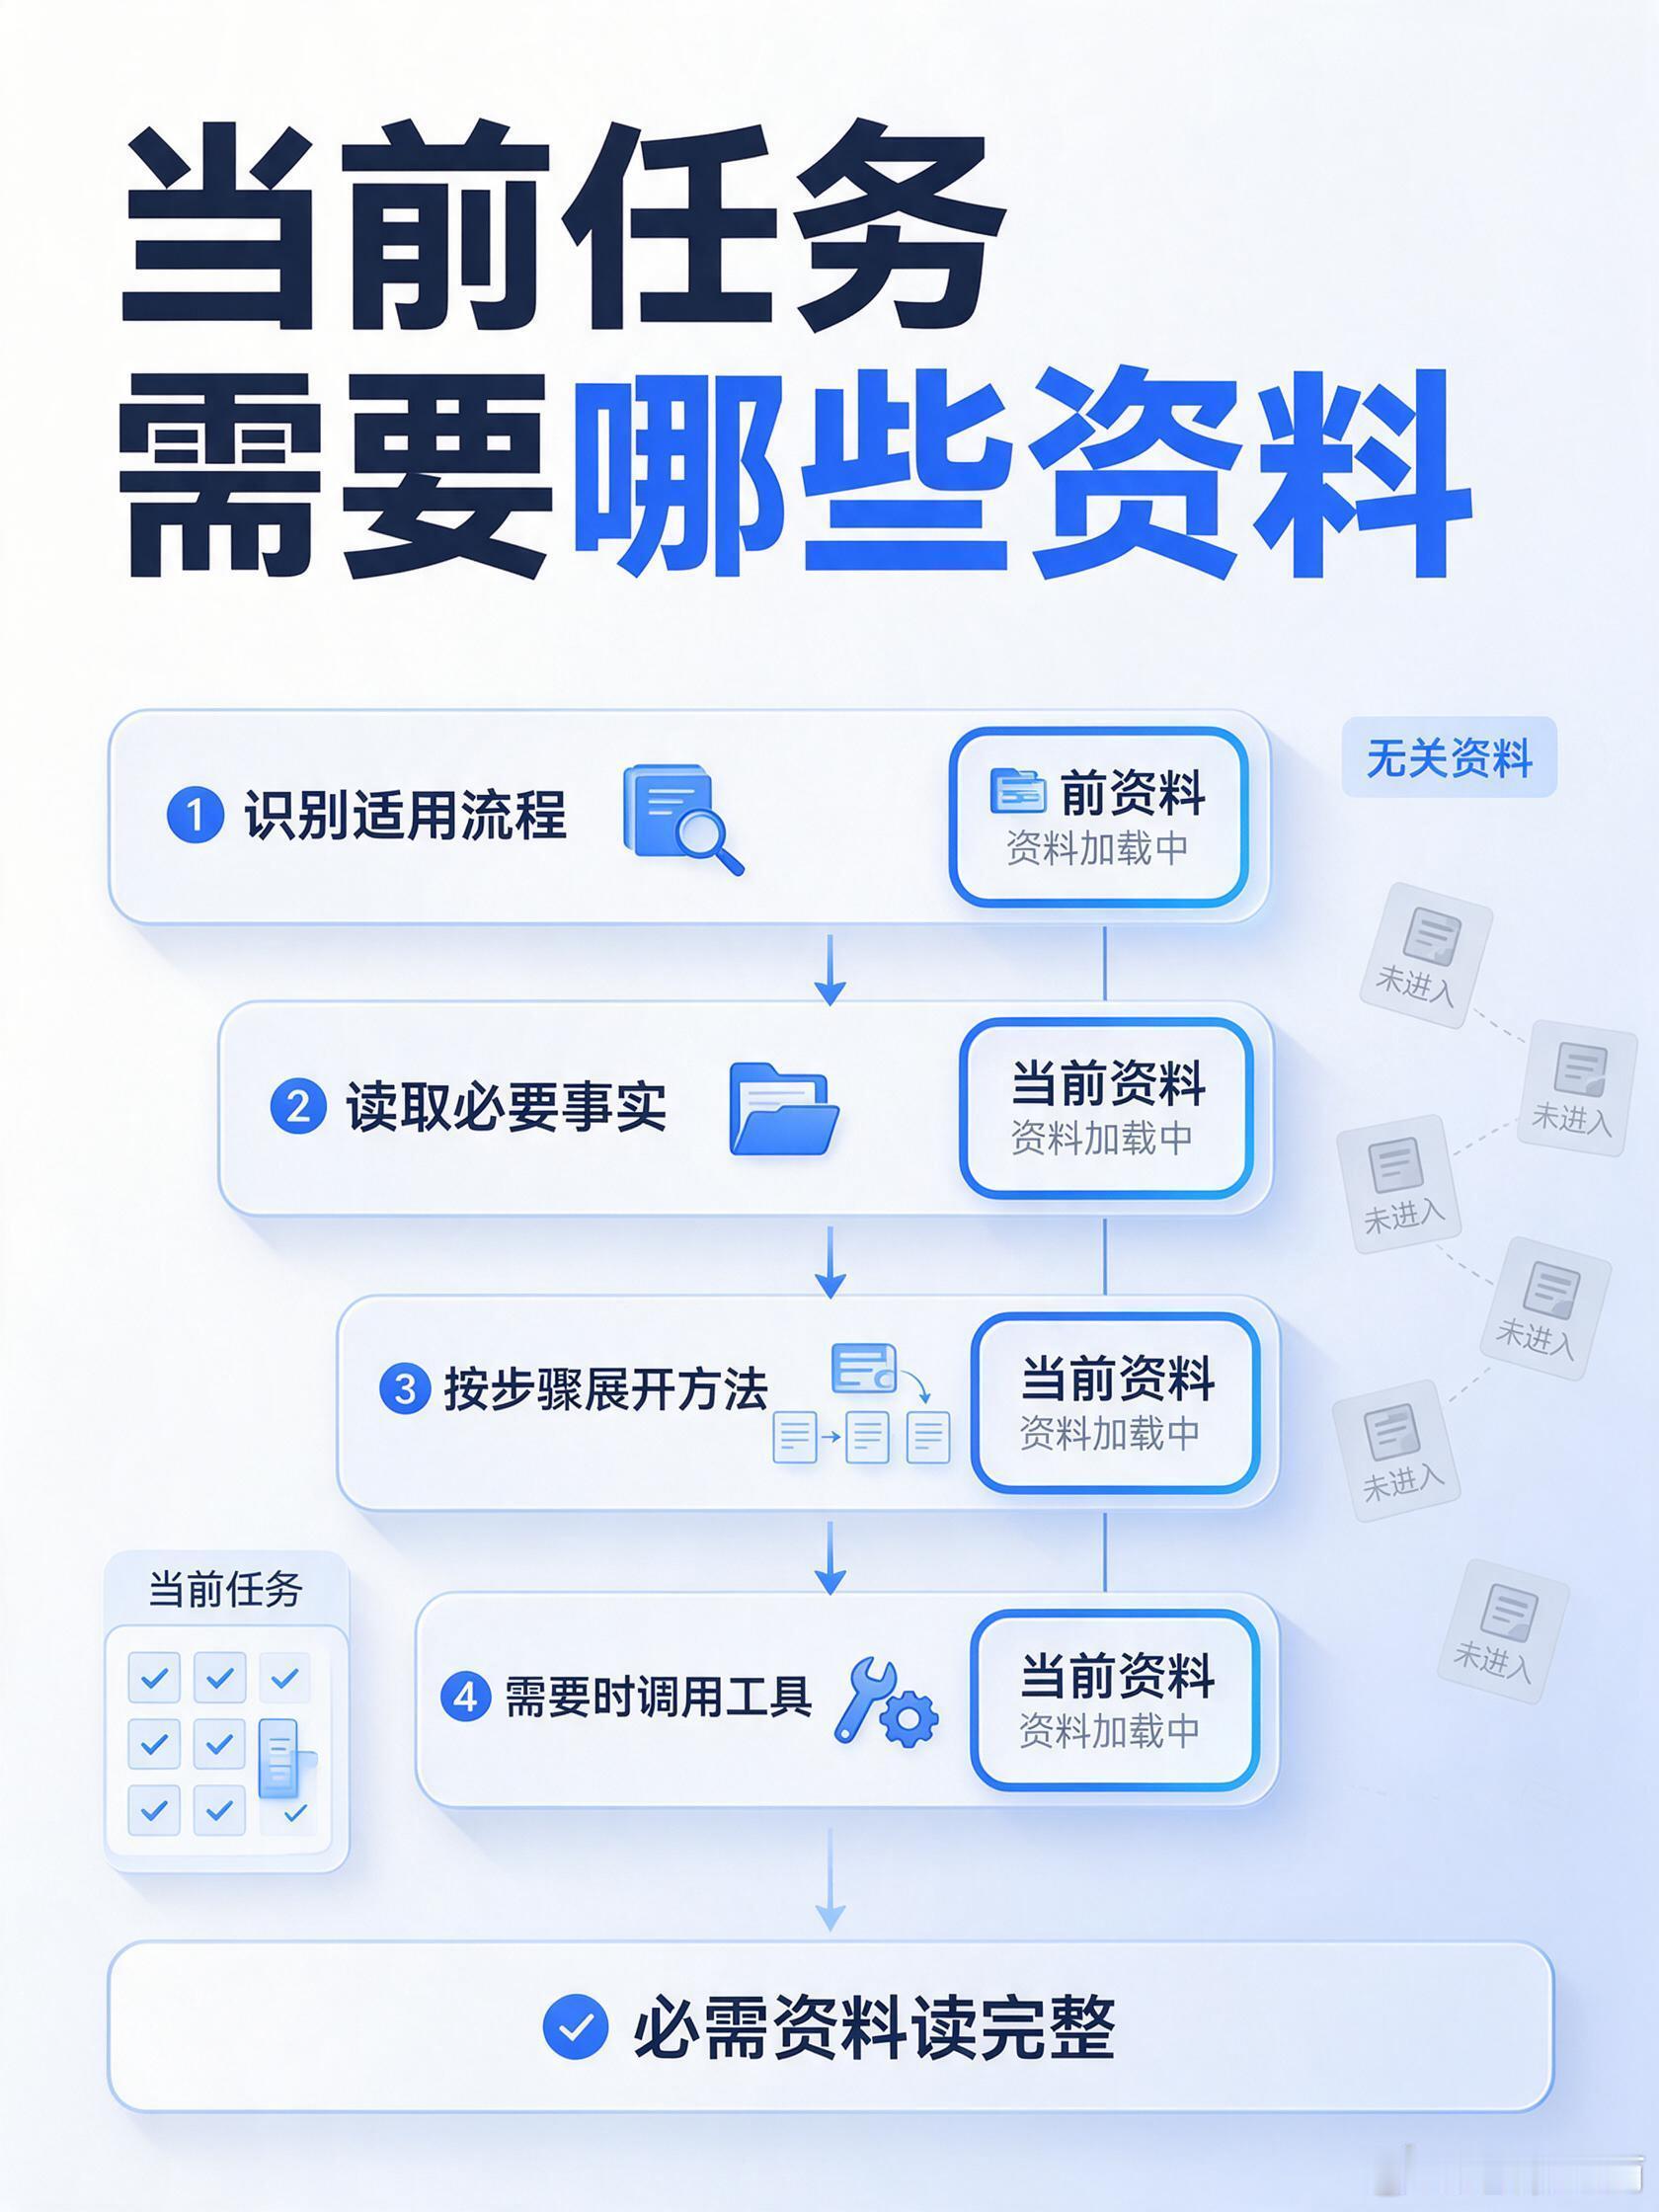
📌 04|按需加载:把上下文留给当前任务
一个工作区可以拥有很多能力,每次任务需要的资料却不同。
只写标题,通常不需要加载图片接口参数。
只整理商品事实,不需要读完所有平台的表达规范。
写小红书时,可以沿着这样的关系展开:
识别适用 Skill;读取该 Skill 的流程;根据当前步骤读取必要事实与方法;确实进入工具执行阶段时,再读取对应调用要求。
这要求 Skill 的触发描述准确、文件引用清楚,流程也要明确哪些资料是必读项。
这里要区分两件事:
「不相关的资料不加载」。「相关的必要资料必须读完整」。
一份商品资料里,卖点和使用限制可能同时存在。如果只提取卖点、忽略限制,虽然读得少了,事实也不完整了。
按需加载的价值,是减少无关资料和重复内容进入上下文,把空间留给当前任务的事实、判断和执行过程。
具体能节省多少 Token,需要结合任务实测,不能仅凭目录拆分就给出固定比例。
📌 05|单一信源:同一项内容只有一个当前维护入口
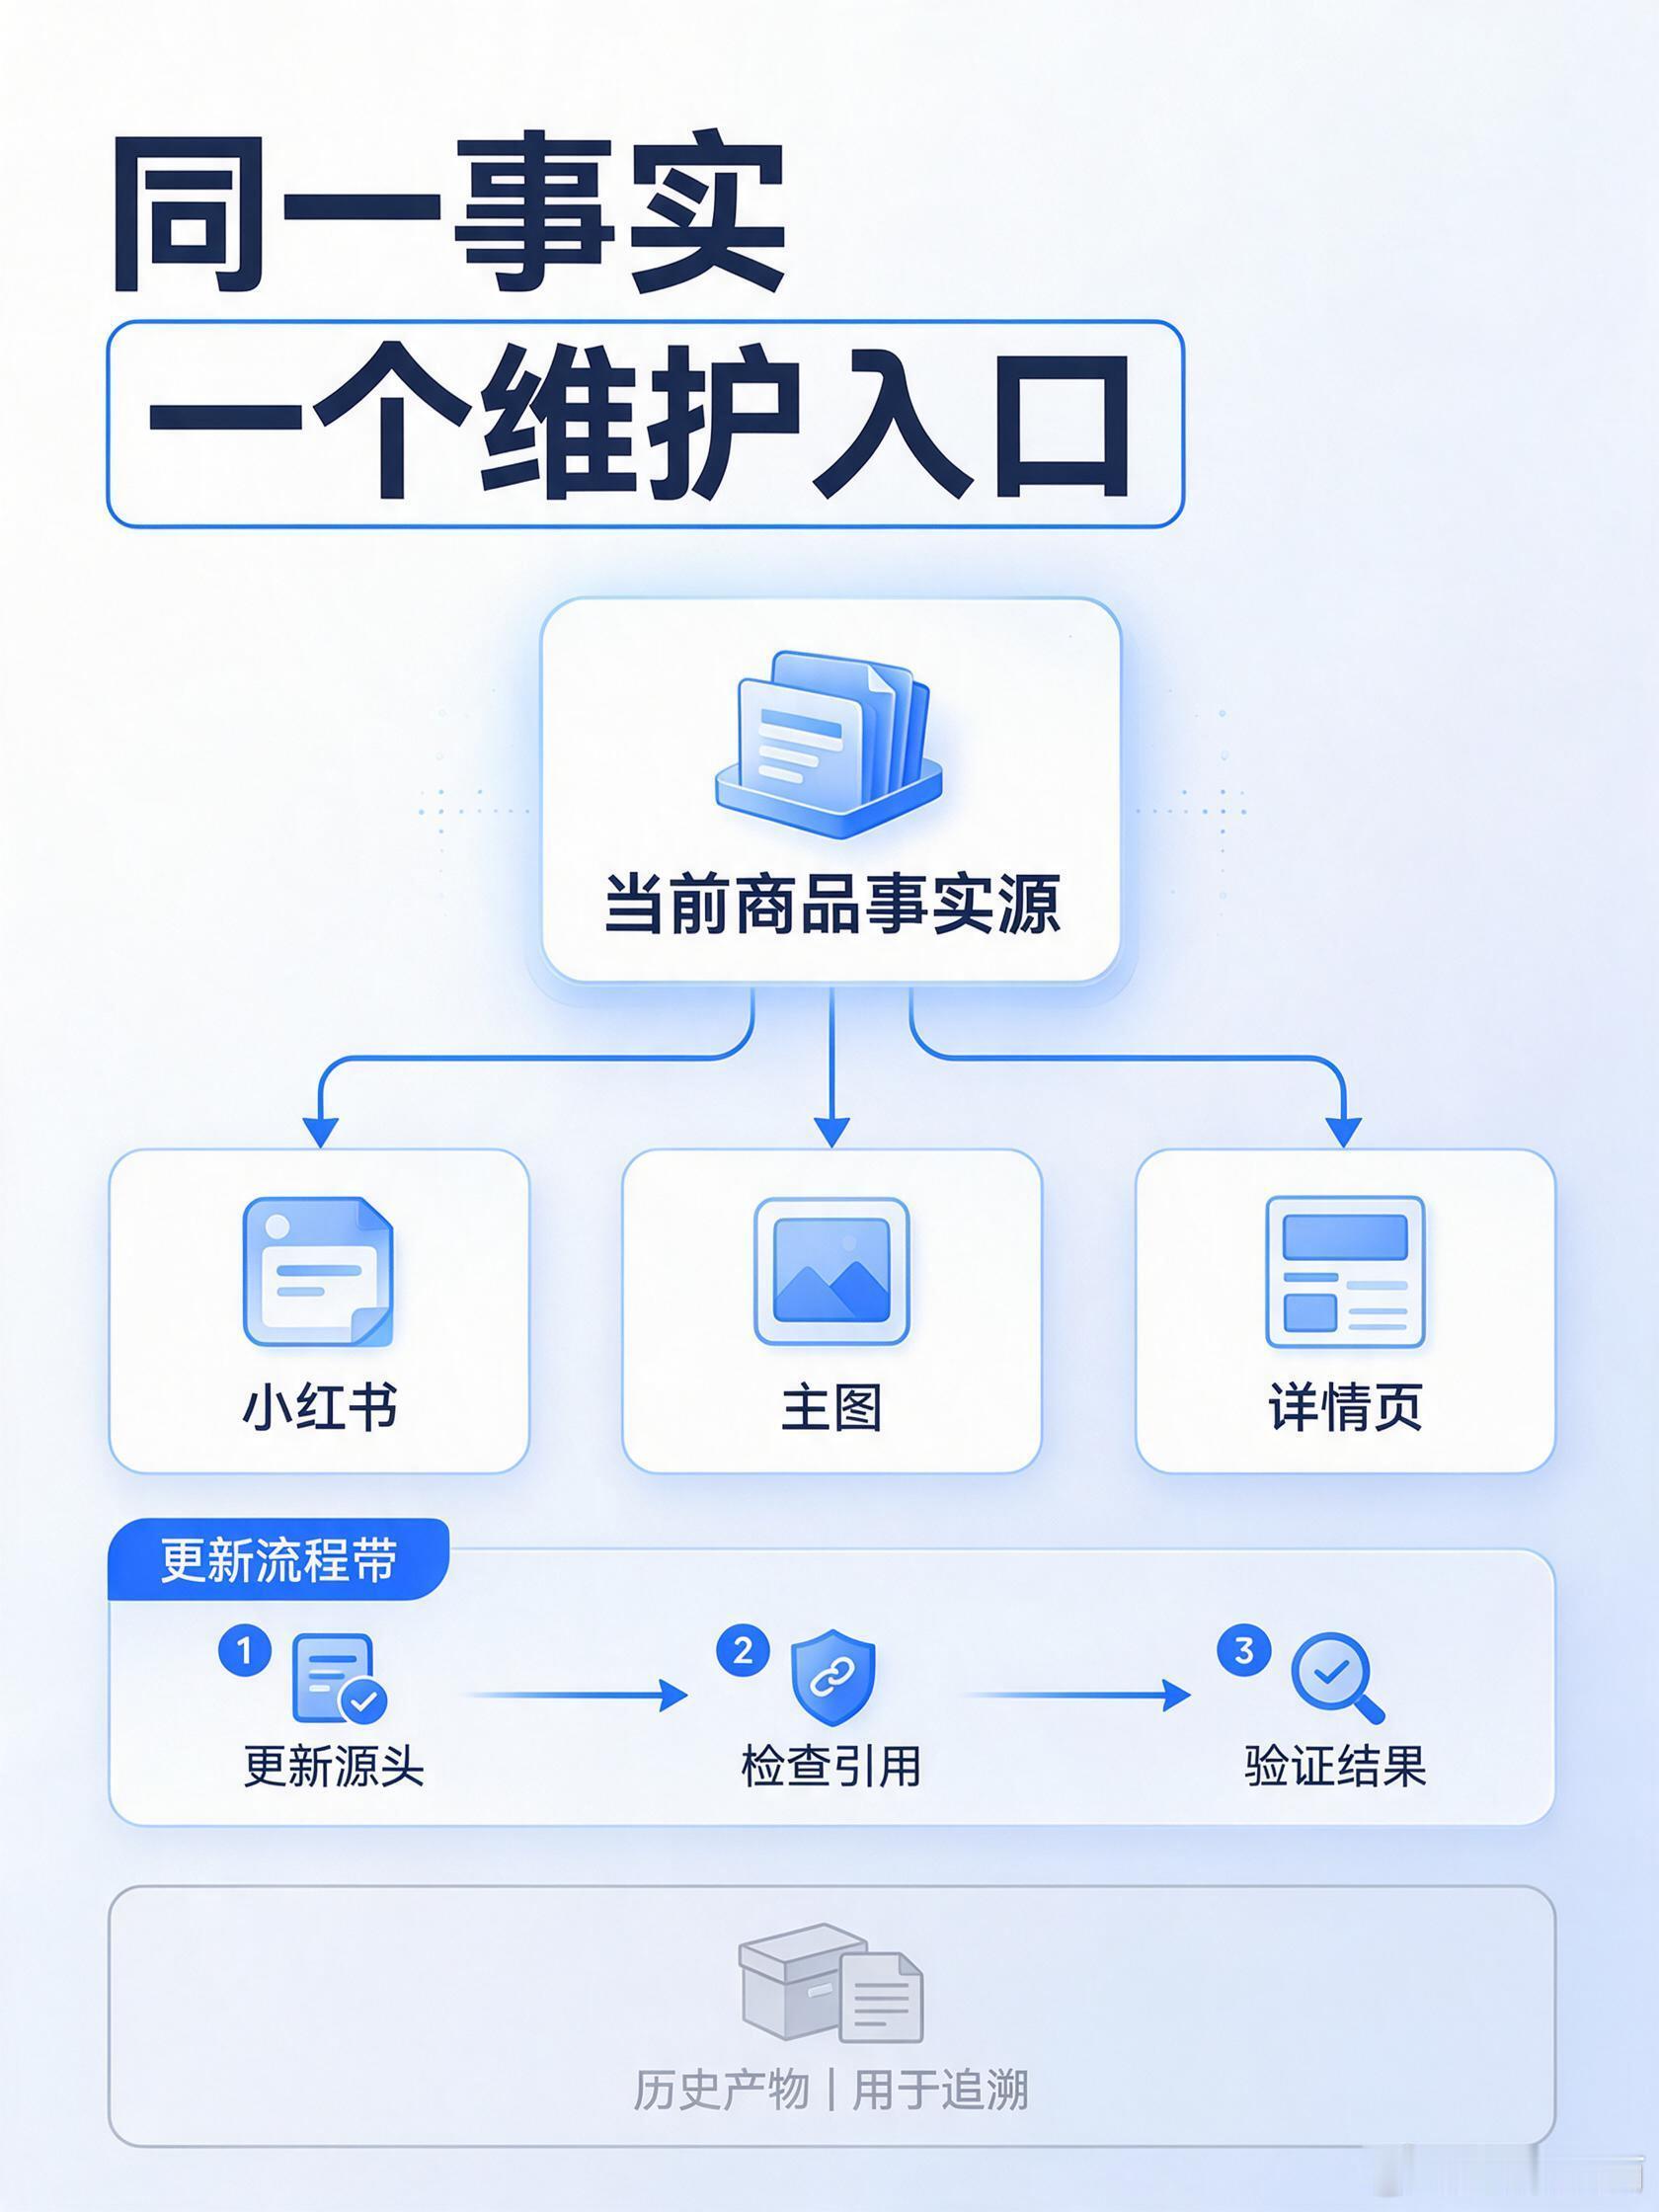
假设小红书、主图、详情页都要使用同一款商品的参数。
可以让三个流程共同引用:
knowledge/products/product-a.md
商品参数变更时,更新这份当前事实源,再验证三个流程是否正确使用了新内容。
这里的“单一”,针对的是同一项事实或规则的维护入口。
商品事实可以由商品文件维护;标题方法可以由标题标准维护;图片调用参数可以由对应工具流程维护。
不需要把所有内容合并成一个巨大的文档。
还要区分「当前事实」和「历史产物」。
过去生成的笔记、旧版方案可以保留用于追溯。它们记录当时的结果,不应因为容易找到,就被当成当前商品事实继续使用。
如果某次任务已经读取了旧资料,源文件随后发生变化,这次任务还需要明确刷新依据、检查受影响内容。单一信源也需要配合版本识别和验证。
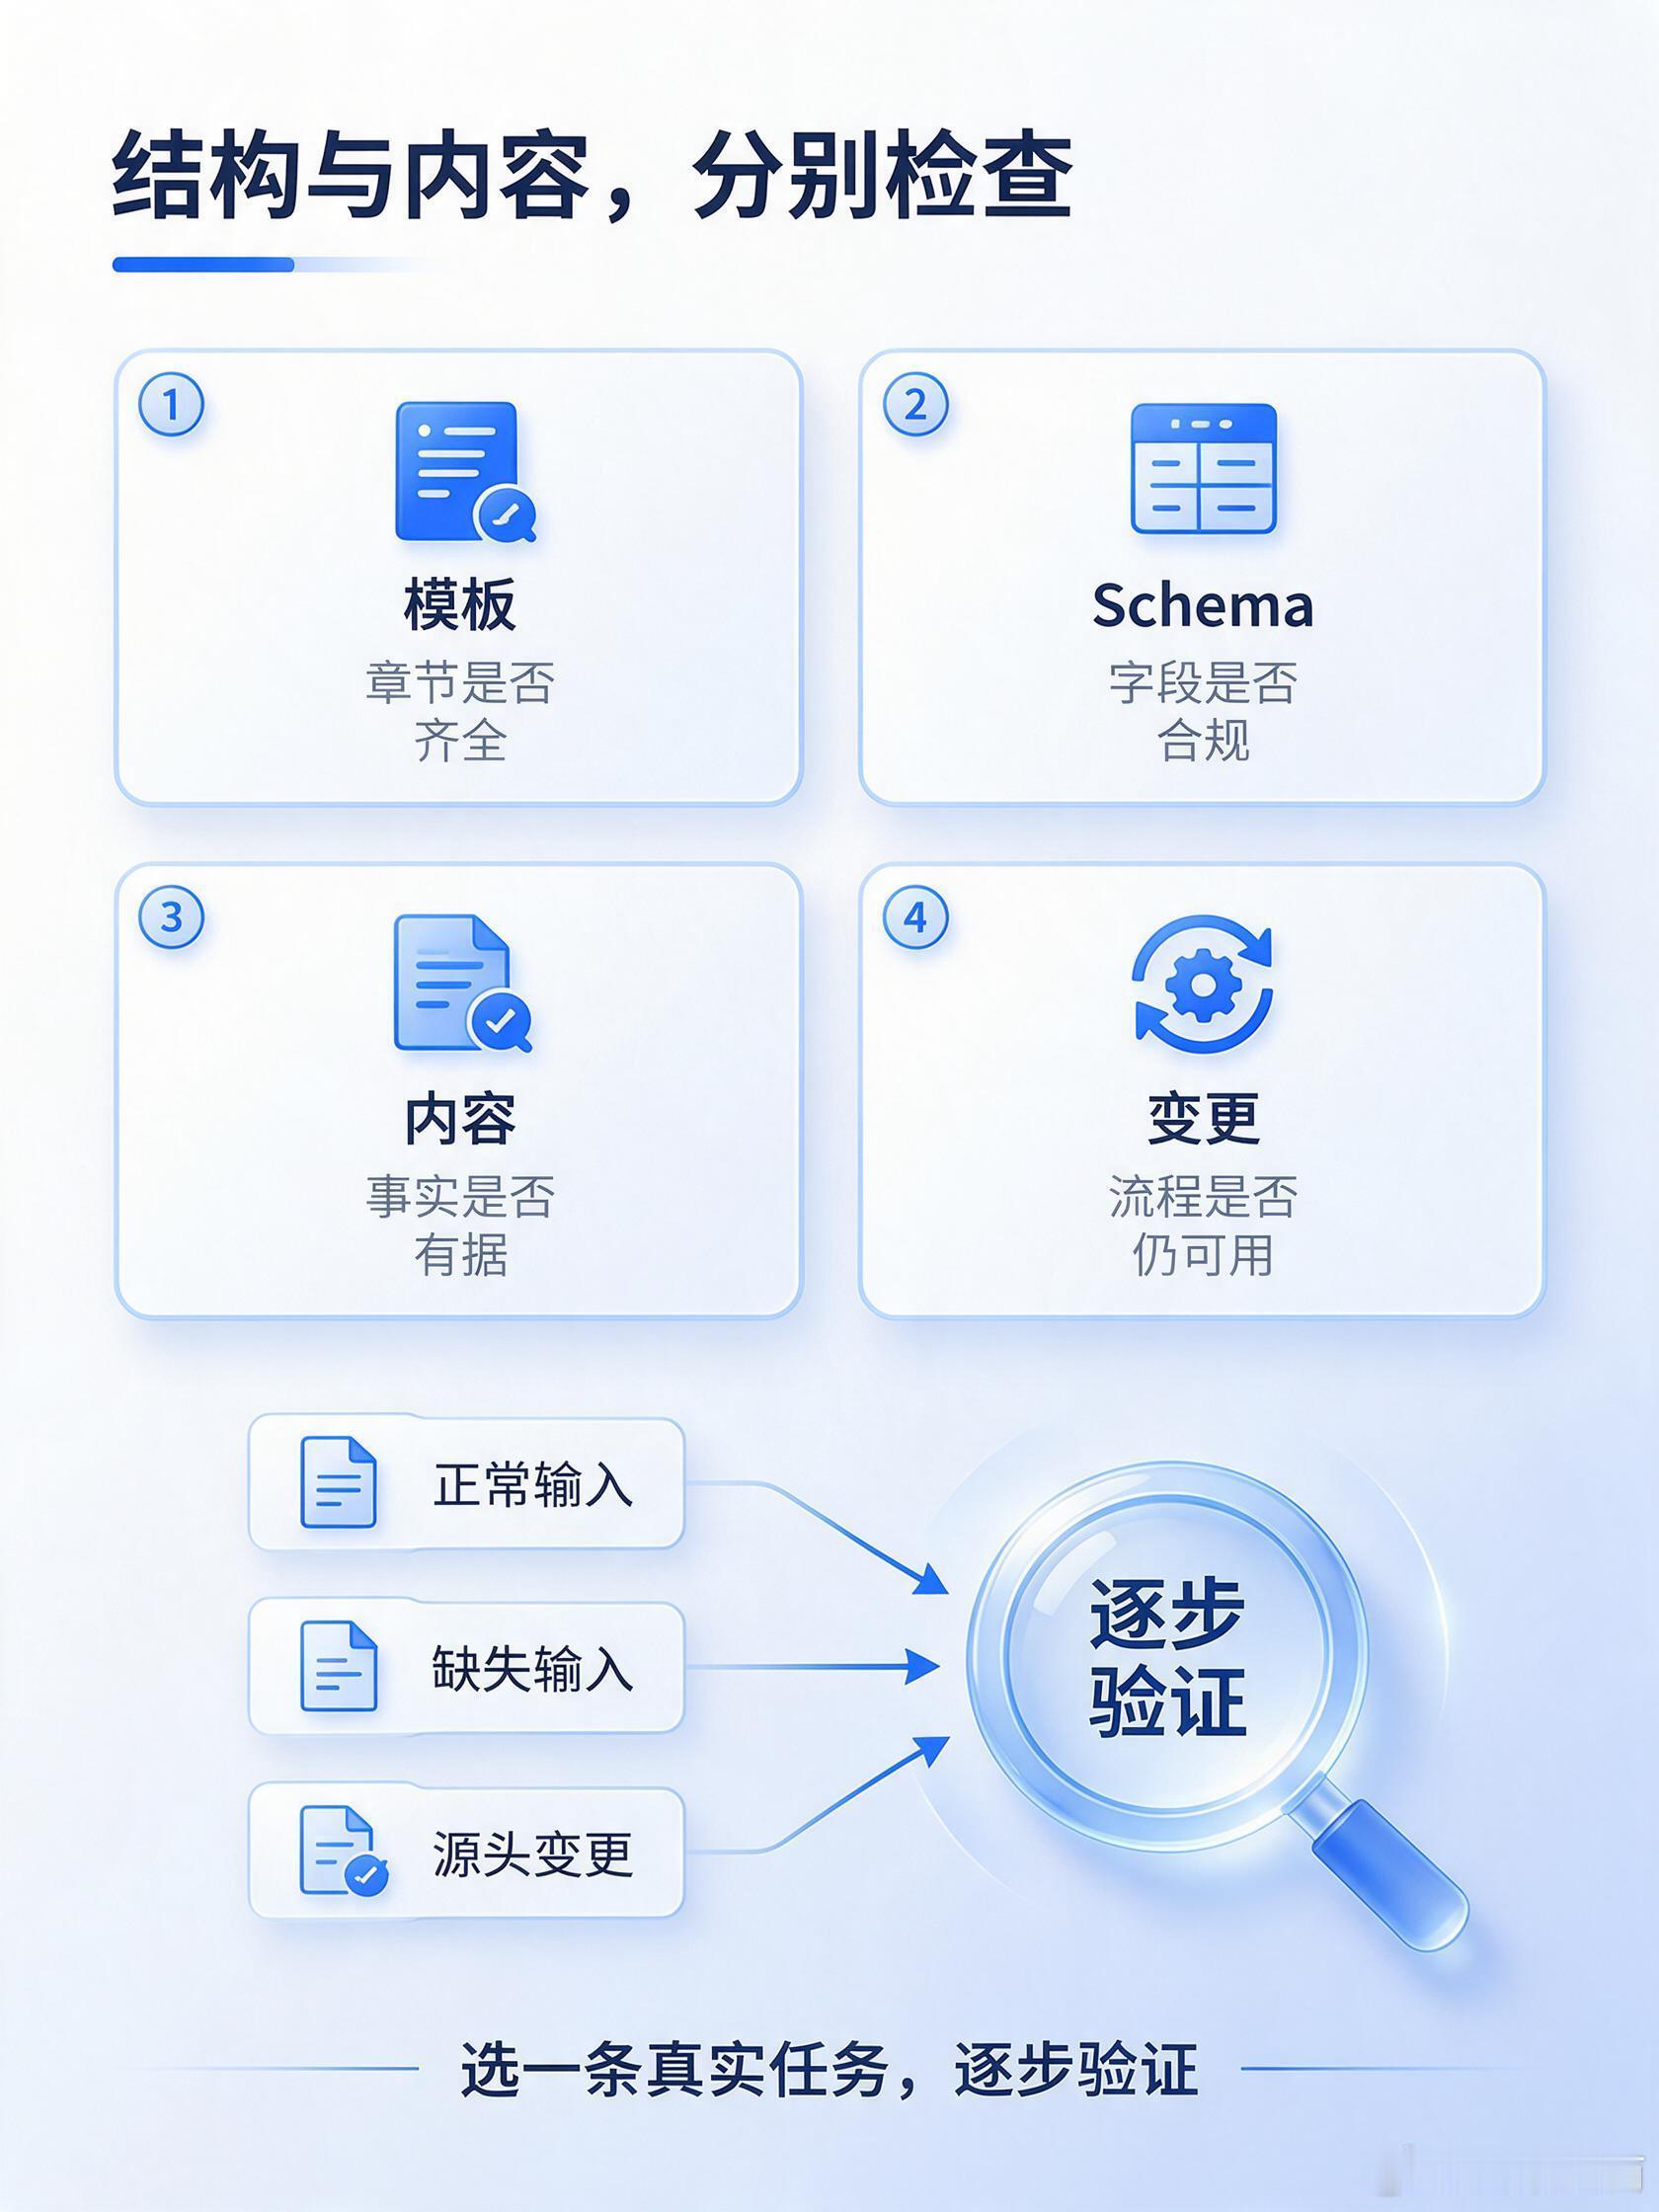
📌 06|模板、Schema、验收标准,分别解决不同问题
这三样很容易被混在一起。
模板规定交付物的骨架。
例如一份商品分析报告,包含:商品事实、目标人群、主要场景、资料缺口。
Schema 规定机器可以检查的结构。
例如:商品编号是必填字段;图片数量必须是整数;资料缺口必须用列表表达。
验收标准判断结果是否合格。
例如:卖点有没有依据;人群与场景是否匹配;正文有没有超出商品适用范围;图片有没有新增未经确认的事实。
一份结果可能字段齐全、类型正确,却填入了错误的商品参数。
所以,结构检查和内容验收都要保留。
📌 07|搭建之后,用任务验证调用关系
目录建好了、文件写好了,还需要验证这套关系能否正确运行。
可以用三类输入检查:
✅ 正常输入
资料齐全时,能否选择正确流程,读取必要资料,逐步交付结果?
✅ 缺失输入
关键参数缺失时,能否明确指出缺口,并停在受影响的步骤?
✅ 变更输入
更新一项商品事实后,引用它的流程能否使用新内容?已经产生的中间结果,是否需要重新检查?
遇到问题,也能按职责定位:
商品参数错误,查事实源及读取过程。内容角度不合适,查方法依据与分析结果。步骤遗漏,查 Skill。字段转换错误,查脚本。交付结构不合要求,查模板和 Schema。操作超出范围,查权限规则及执行过程。
修改后,再运行直接受影响的任务,确认问题已经修复。
新建工作区时,先确定职责与来源,再搭建流程。
使用一段时间后,检查临时要求是否堆进了长期规则、共享资料是否出现多个副本、文件引用是否仍然有效。
整理已有工作区时,先梳理调用关系与改动范围,再分步调整,保留已经验证有效的知识和流程。
让 Agent “学习工作区标准”,指的是读取这些文件并按规范执行。持续有效的依据,需要保存在可维护、可再次读取的位置。
可以先收藏这篇,拿工作区里一条常用任务对照检查:每一步读哪份资料、交付什么结果、依据变更后怎么验证。
CodexAIAgentAgent开发AI工作流知识库 上下文工程老梁AI电商