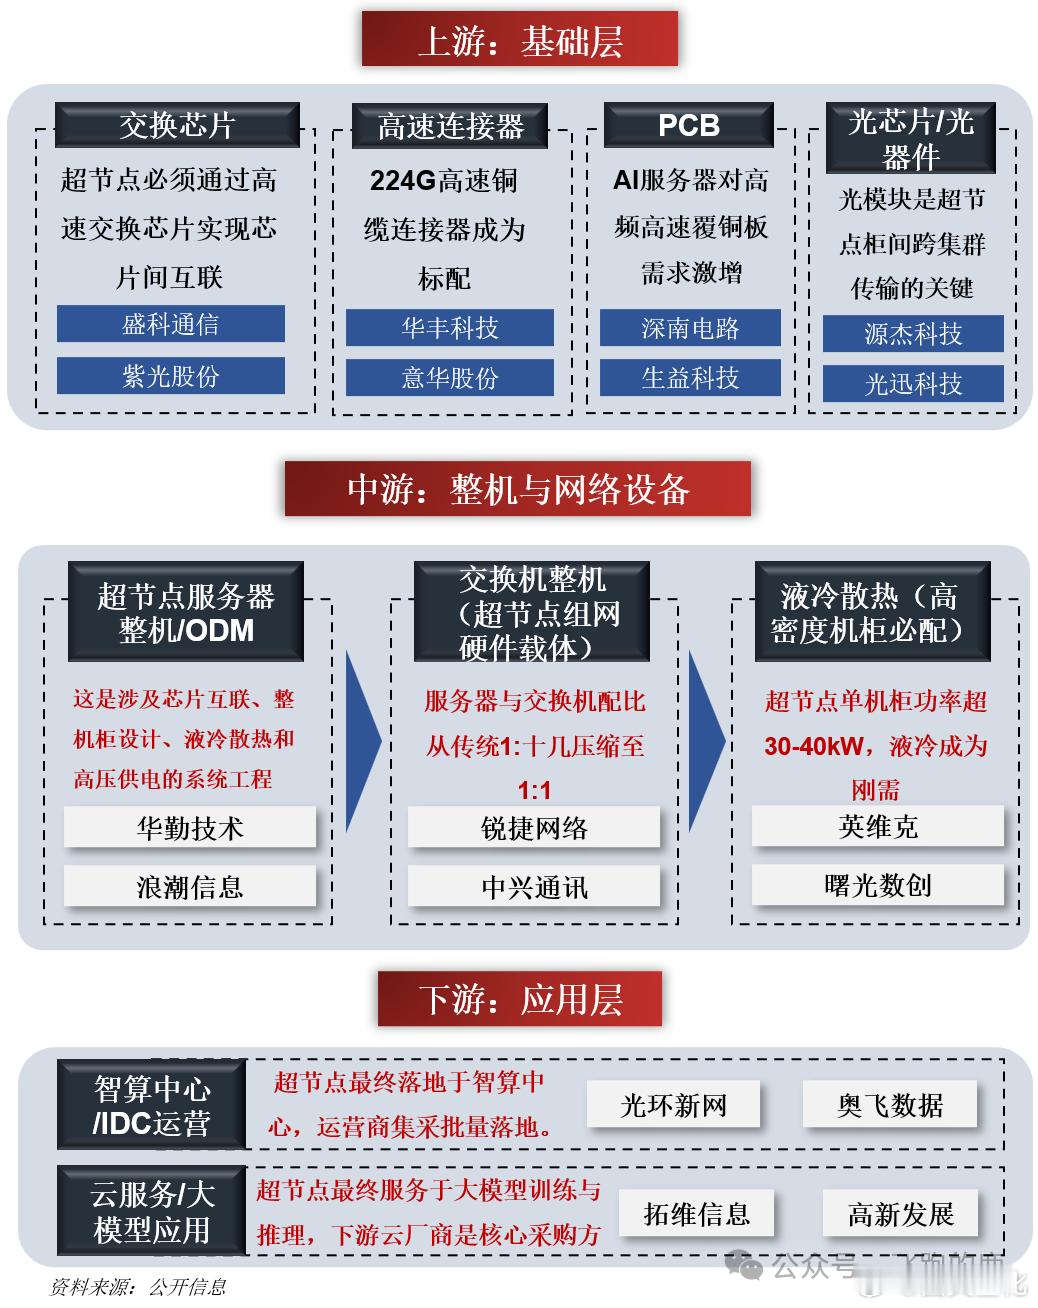
AI算力超节点,一句话:用超高速互联,把几十到几百块GPU/NPU紧耦合,拼成一个逻辑上的“巨型芯片”,打破单机算力瓶颈。
大模型训练要成百上千块GPU协同,每步都频繁通信。跨服务器走以太网/IB,带宽低、延迟高,GPU只能等。超节点用NVLink/NVSwitch,把它们拉进同一个高速互联域,直接读写显存,带宽几百GB/s到TB/s,延迟百纳秒级。不是几台机器联网,而是一块大芯片内部通信。
简单类比一下:以前工人分散在不同房间打电话,容易卡顿;现在拉进同一个大车间,肩并肩用内部广播喊话,几乎像同一个人在思考。
更深一层:通信瓶颈从网络搬进总线,并行切得更细,计算通信重叠,MFU更高。但堆卡不等于超节点,功耗、散热、拓扑、软件调度才是关键。