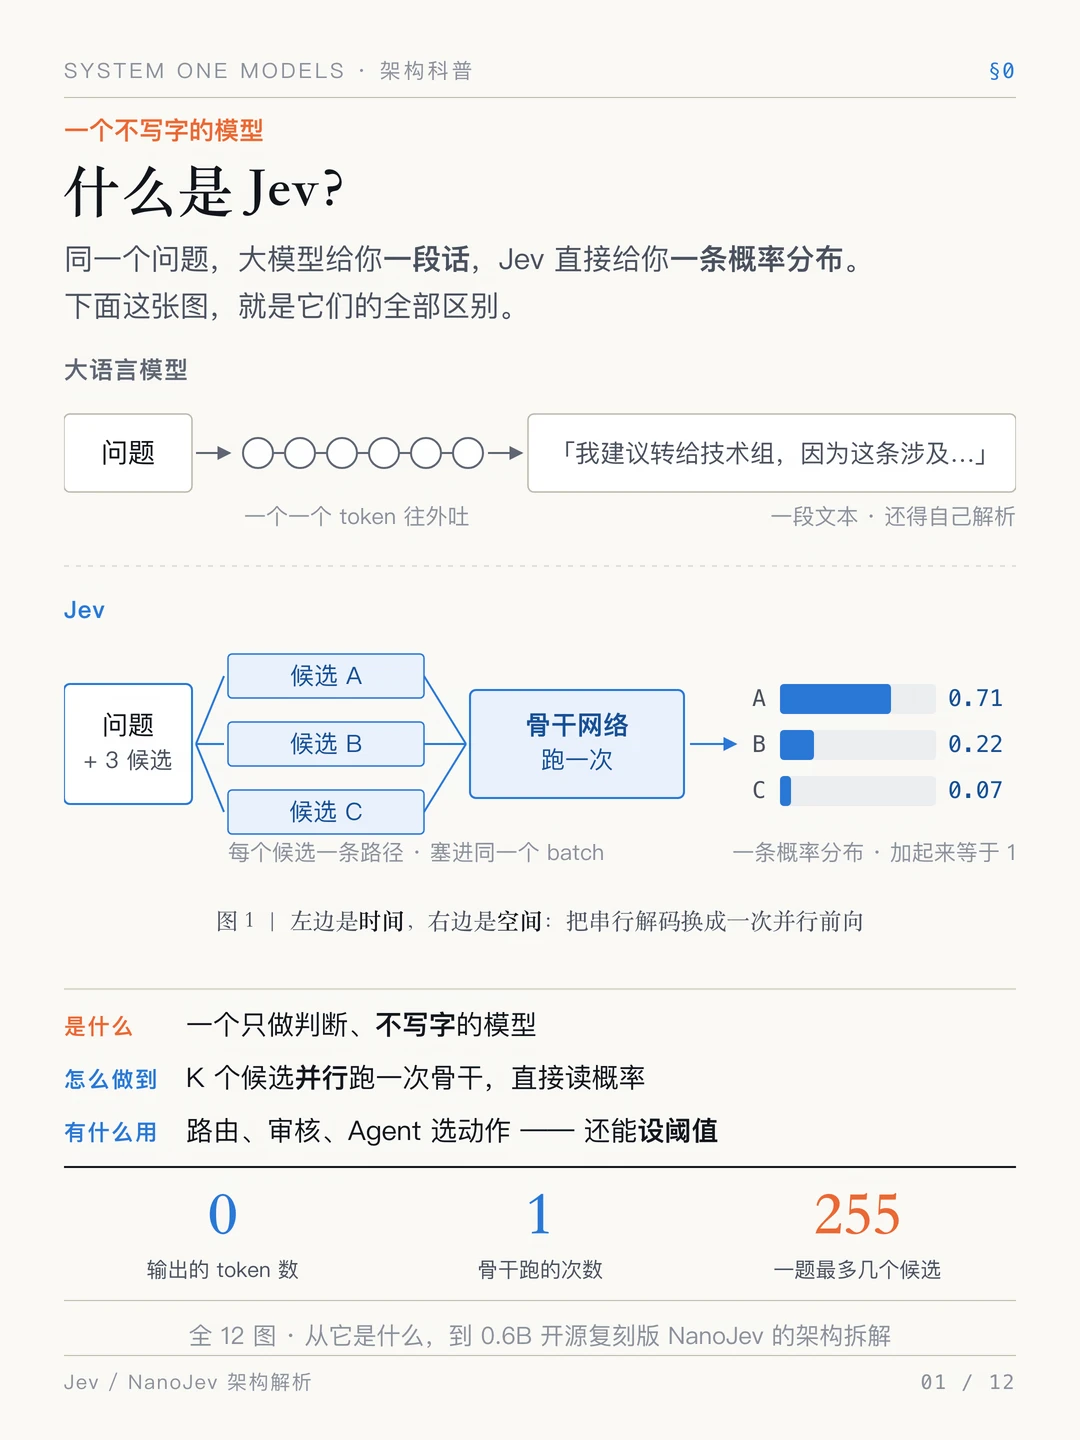
同一个问题,大模型给你一段话,Jev 直接给你一条概率分布。
【它是什么】
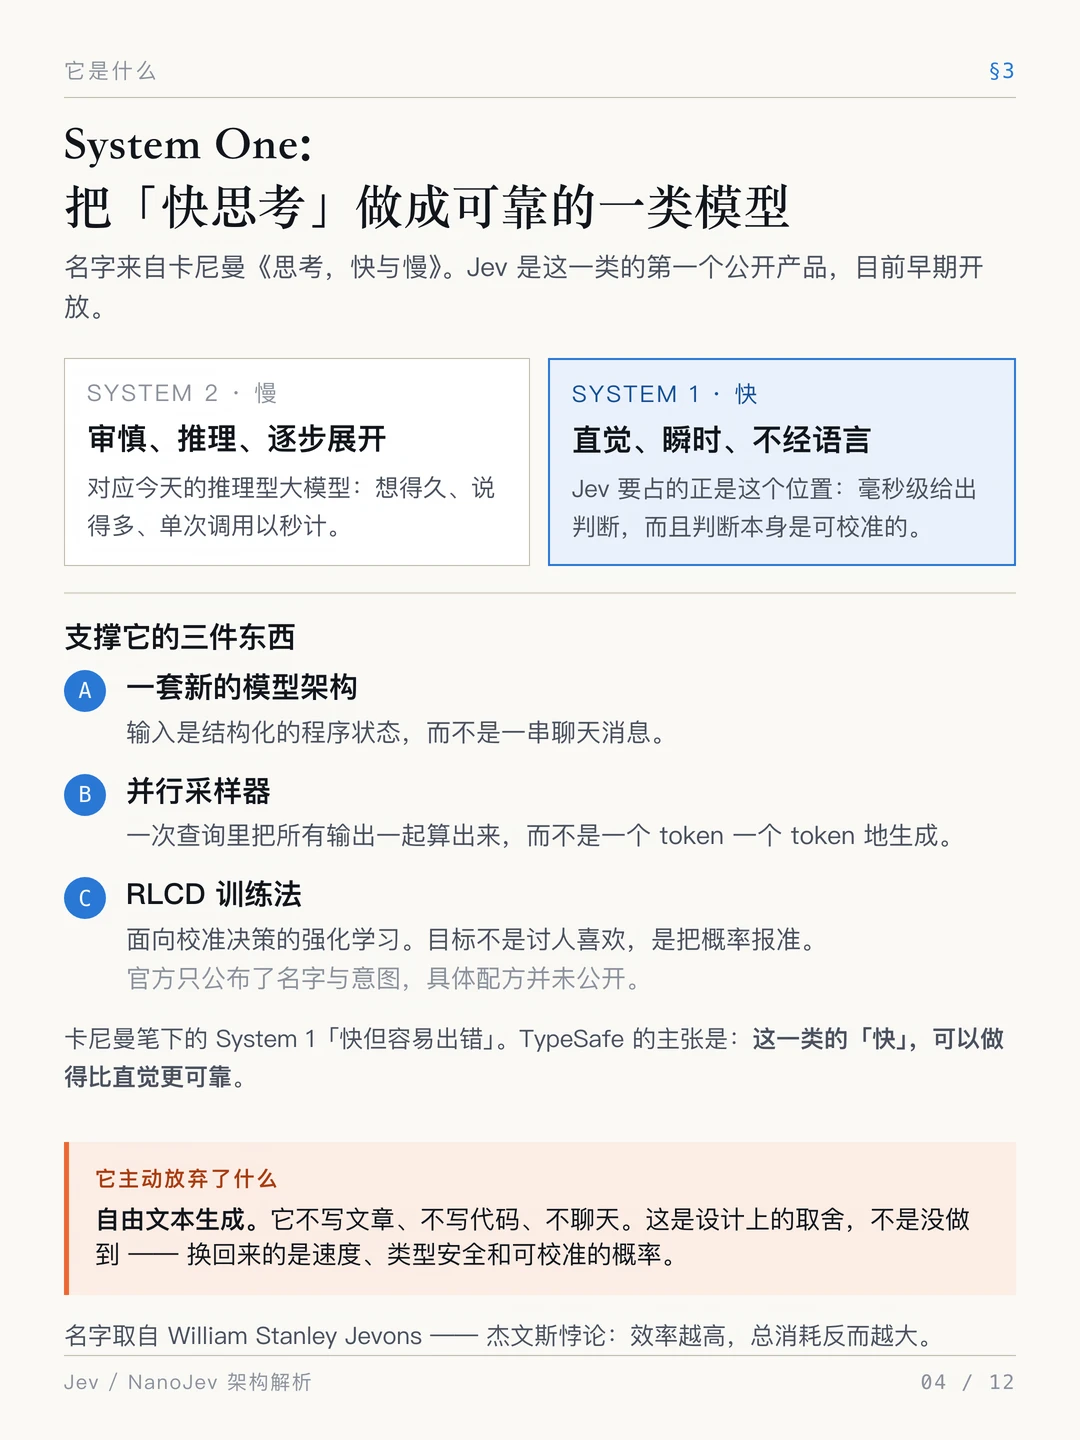
TypeSafe 提出了一类叫 System One Models 的模型,第一个产品叫 Jev——名字取自经济学家 William Stanley Jevons,也呼应卡尼曼说的"系统 1"(快思考)。
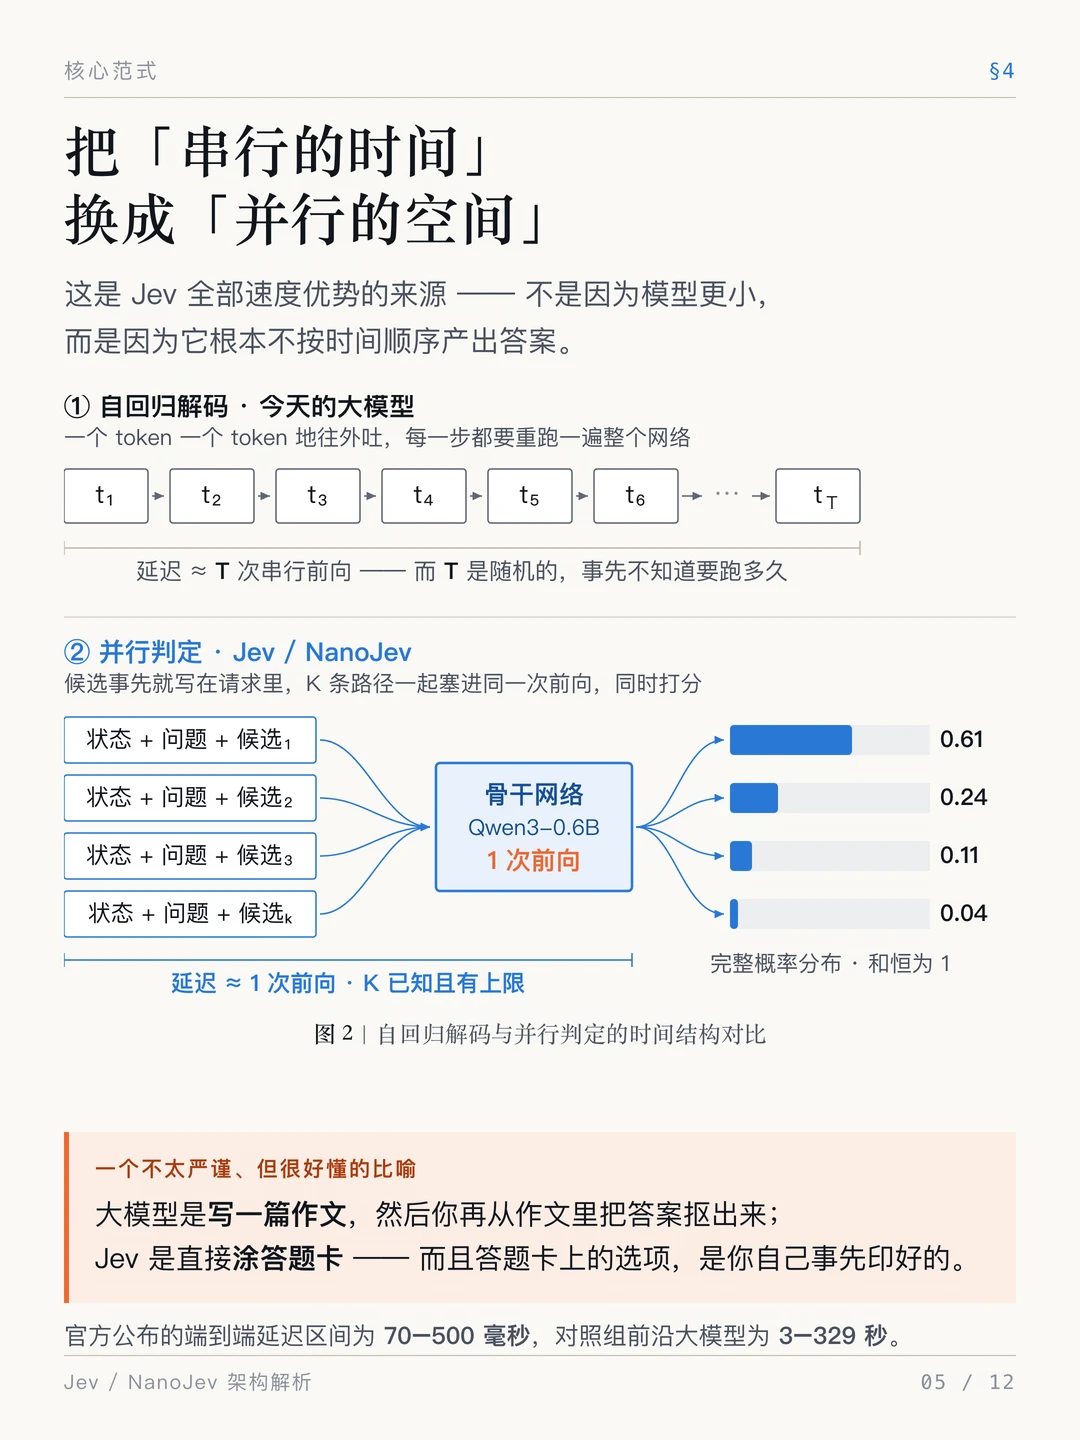
它不写字。输入还是自然语言,输出不是句子,而是候选项上的一条概率分布。一次前向就出结果,输出 token 数是 0。
【和大模型差在哪】
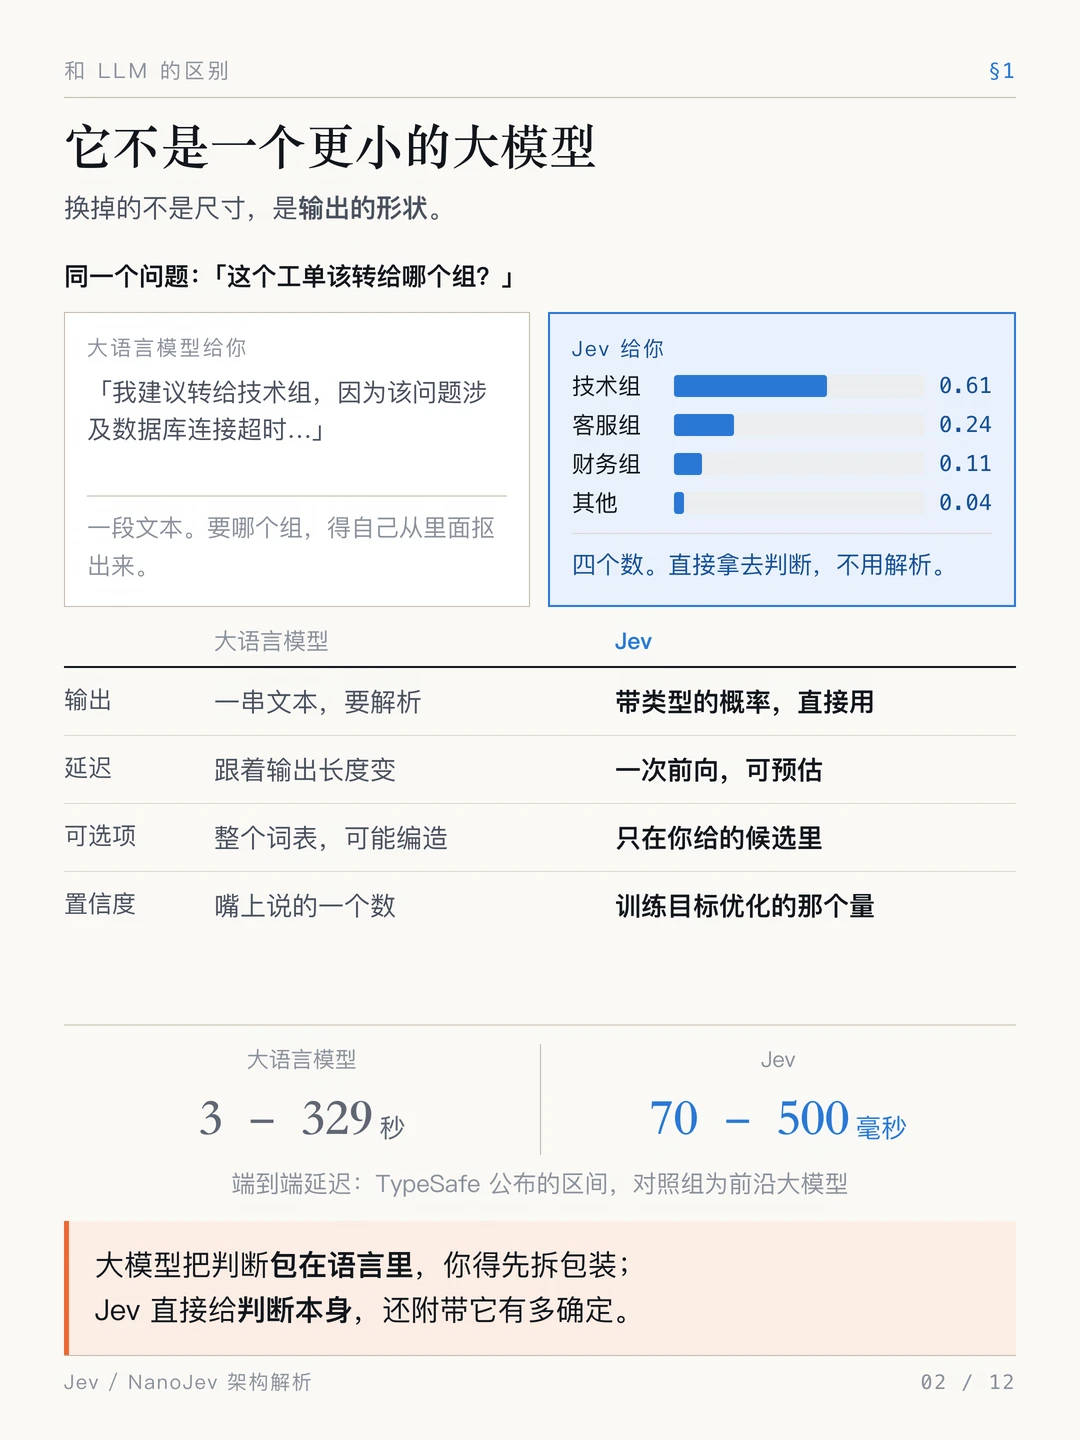
它不是"更小的大模型"。换掉的不是尺寸,是输出的形状。
· 输出:一段话 → 一条概率分布
· 延迟:随字数涨(3–329 秒)→ 固定一次前向(70–500 毫秒)
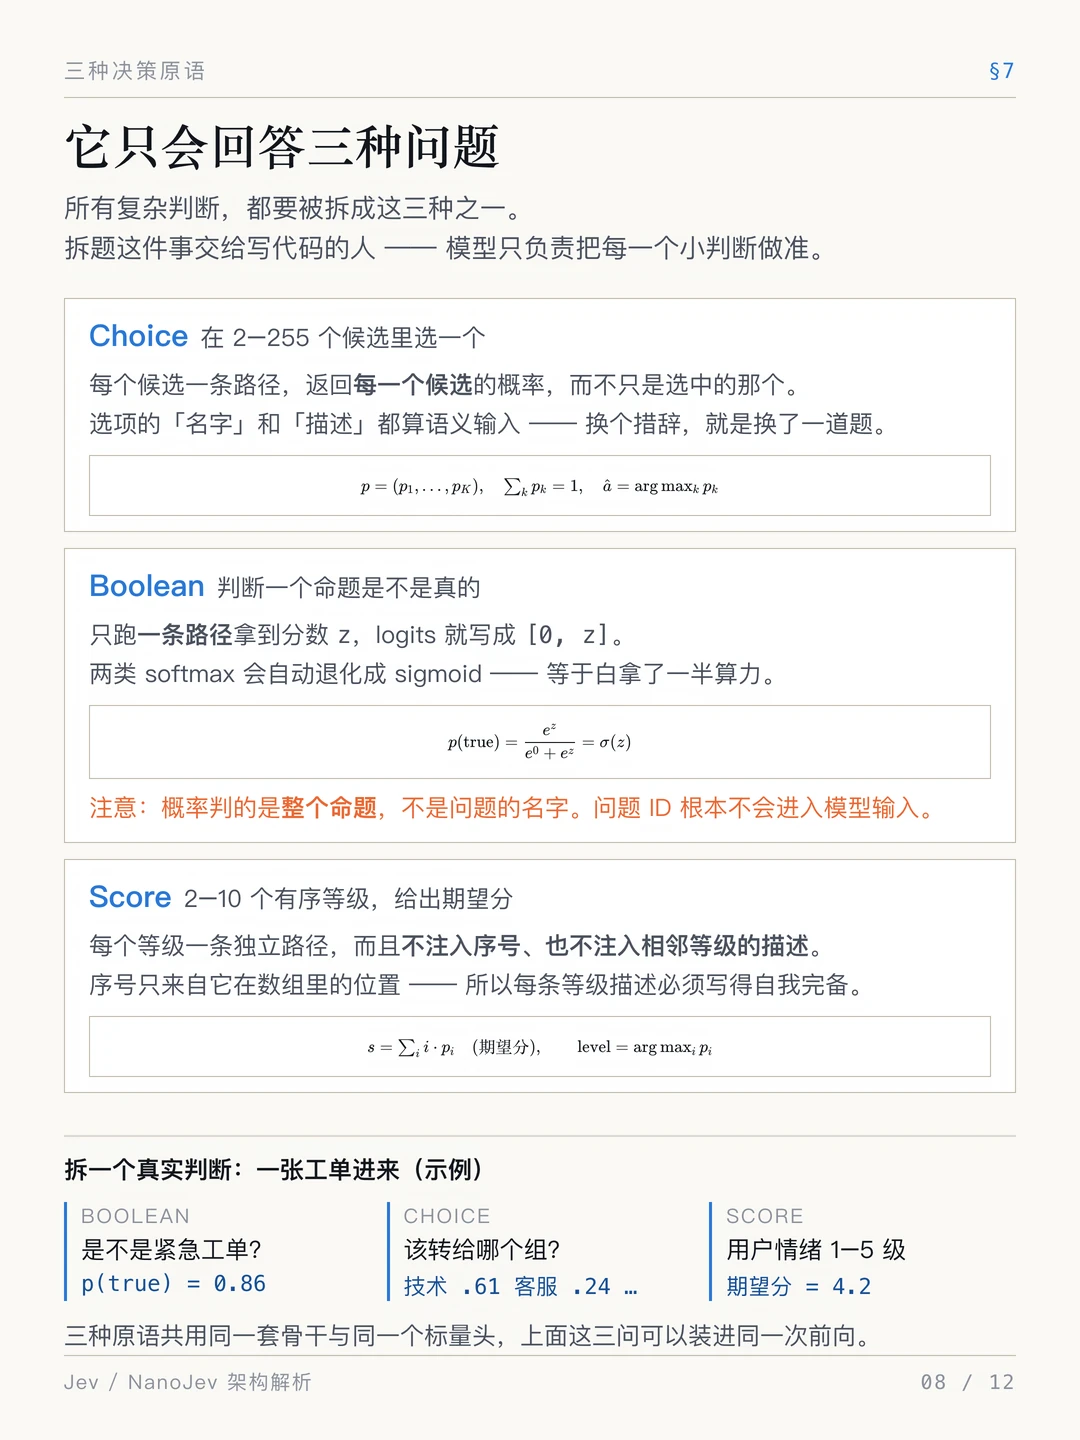
· 选项:藏在文字里要解析 → 2–255 个,你显式给
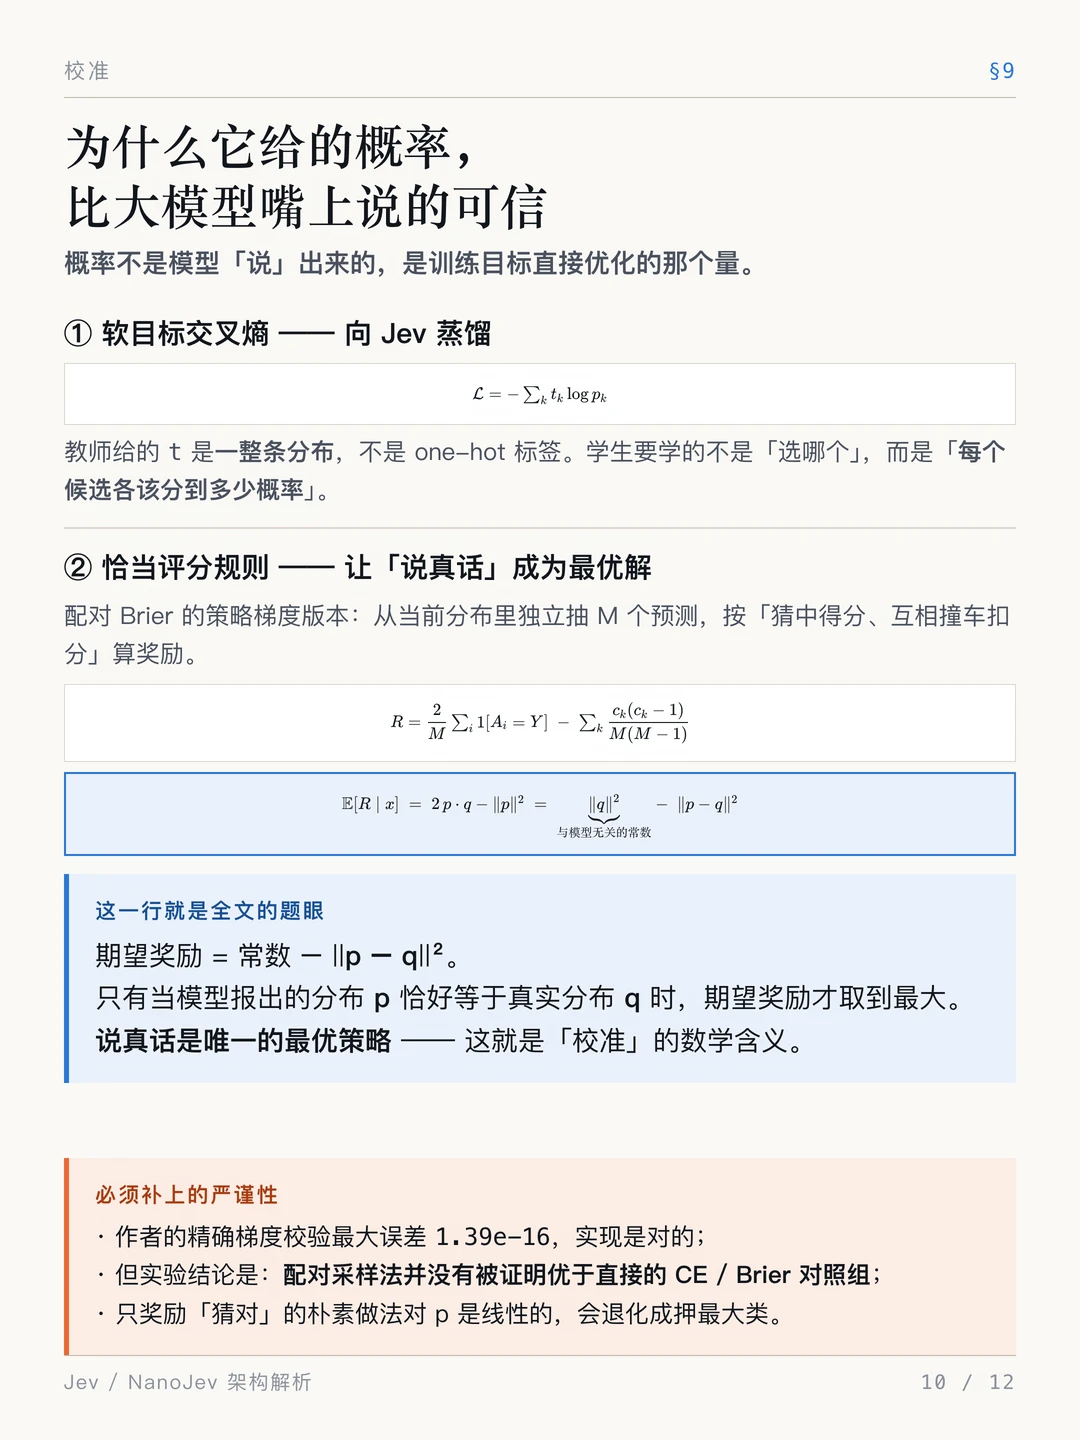
· 置信度:嘴上说"我有 95% 把握" → 训练目标直接约束出来的
【能干什么】
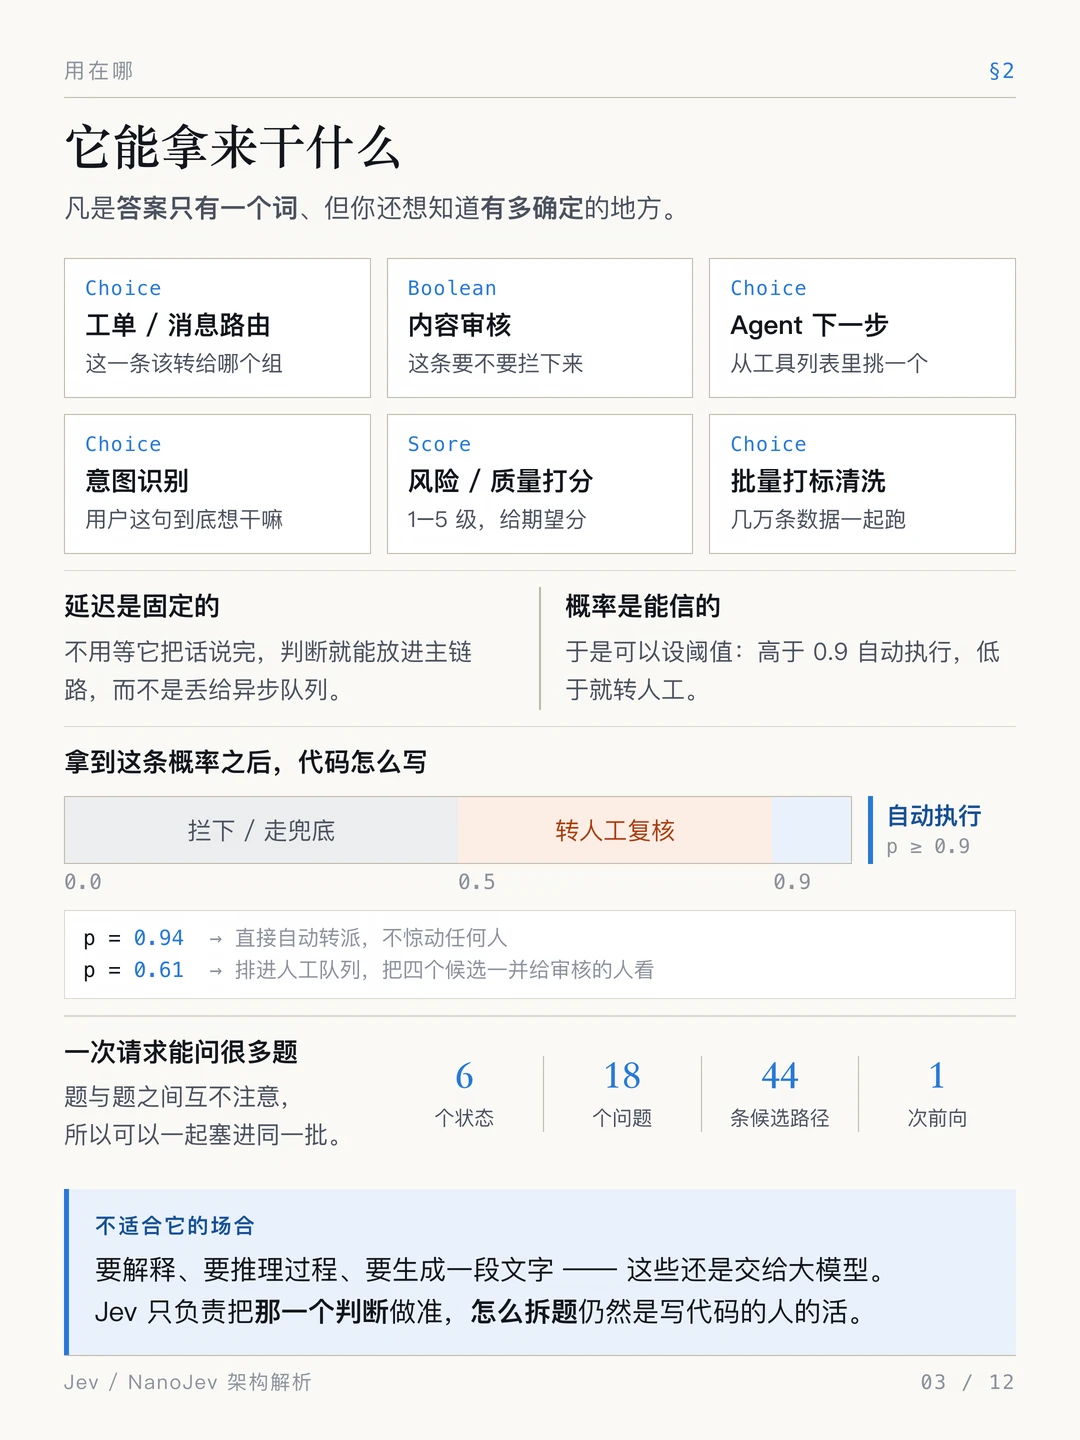
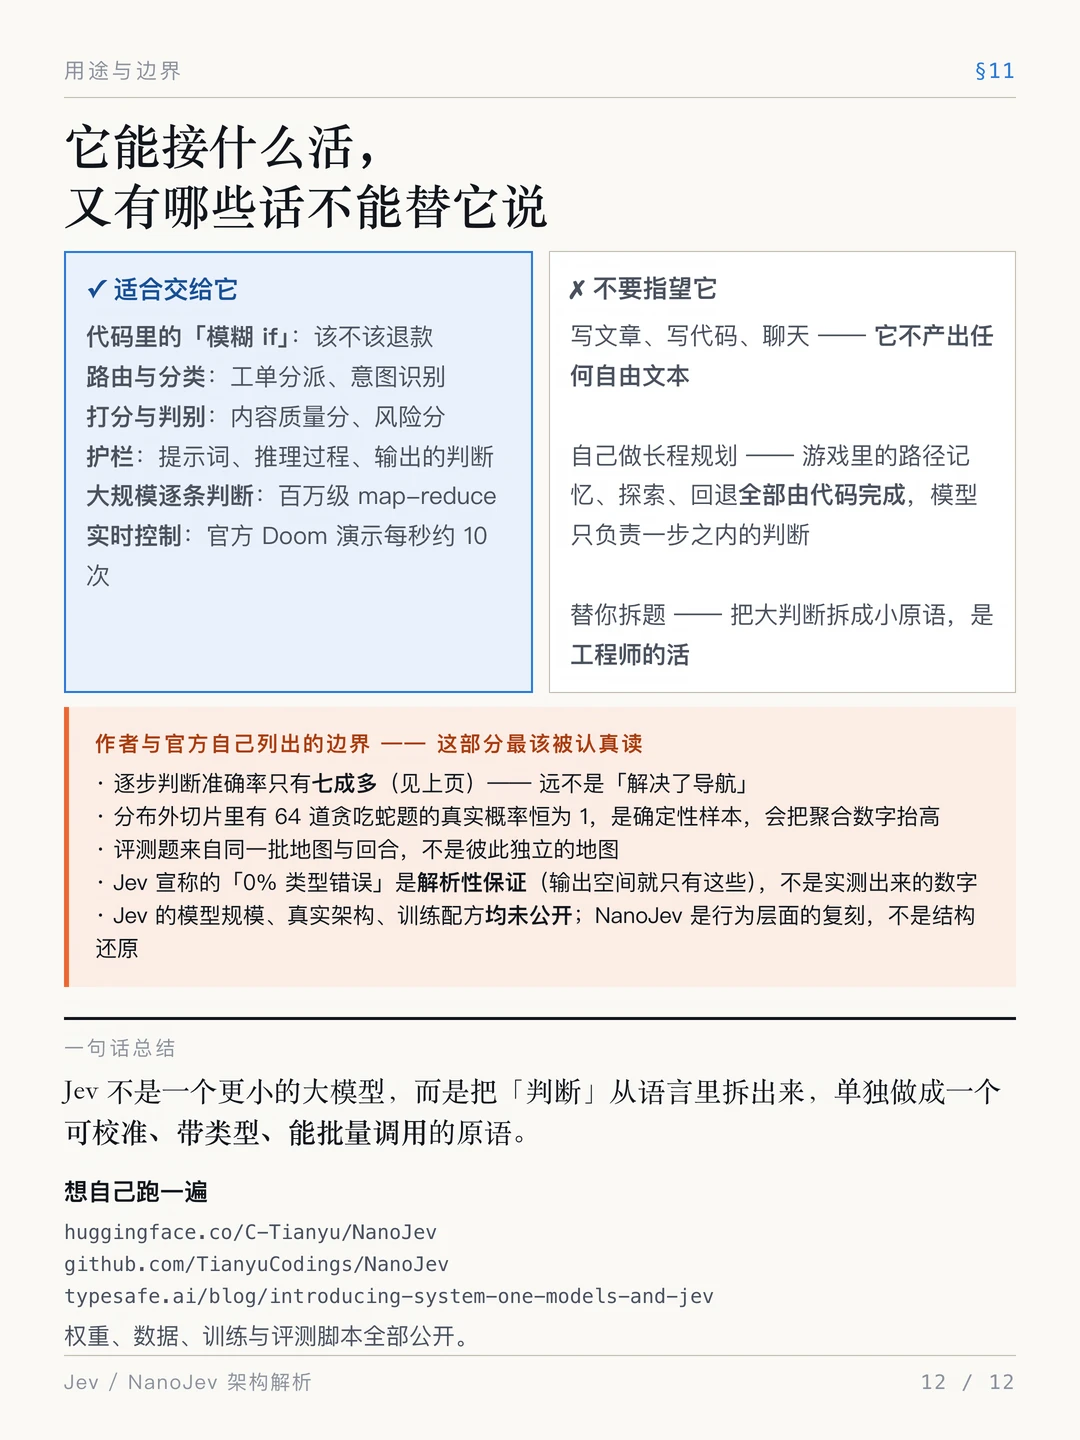
凡是"答案只有一个词、但你还想知道有多确定"的活:工单路由、内容审核、Agent 下一步调哪个工具、意图识别、风险打分、批量打标清洗。
延迟固定,判断就能放进主链路,而不是丢给异步队列;概率可信,代码里就能直接写阈值——≥0.9 自动执行,0.5–0.9 转人工复核,<0.5 拦下走兜底。
【怎么做到的】
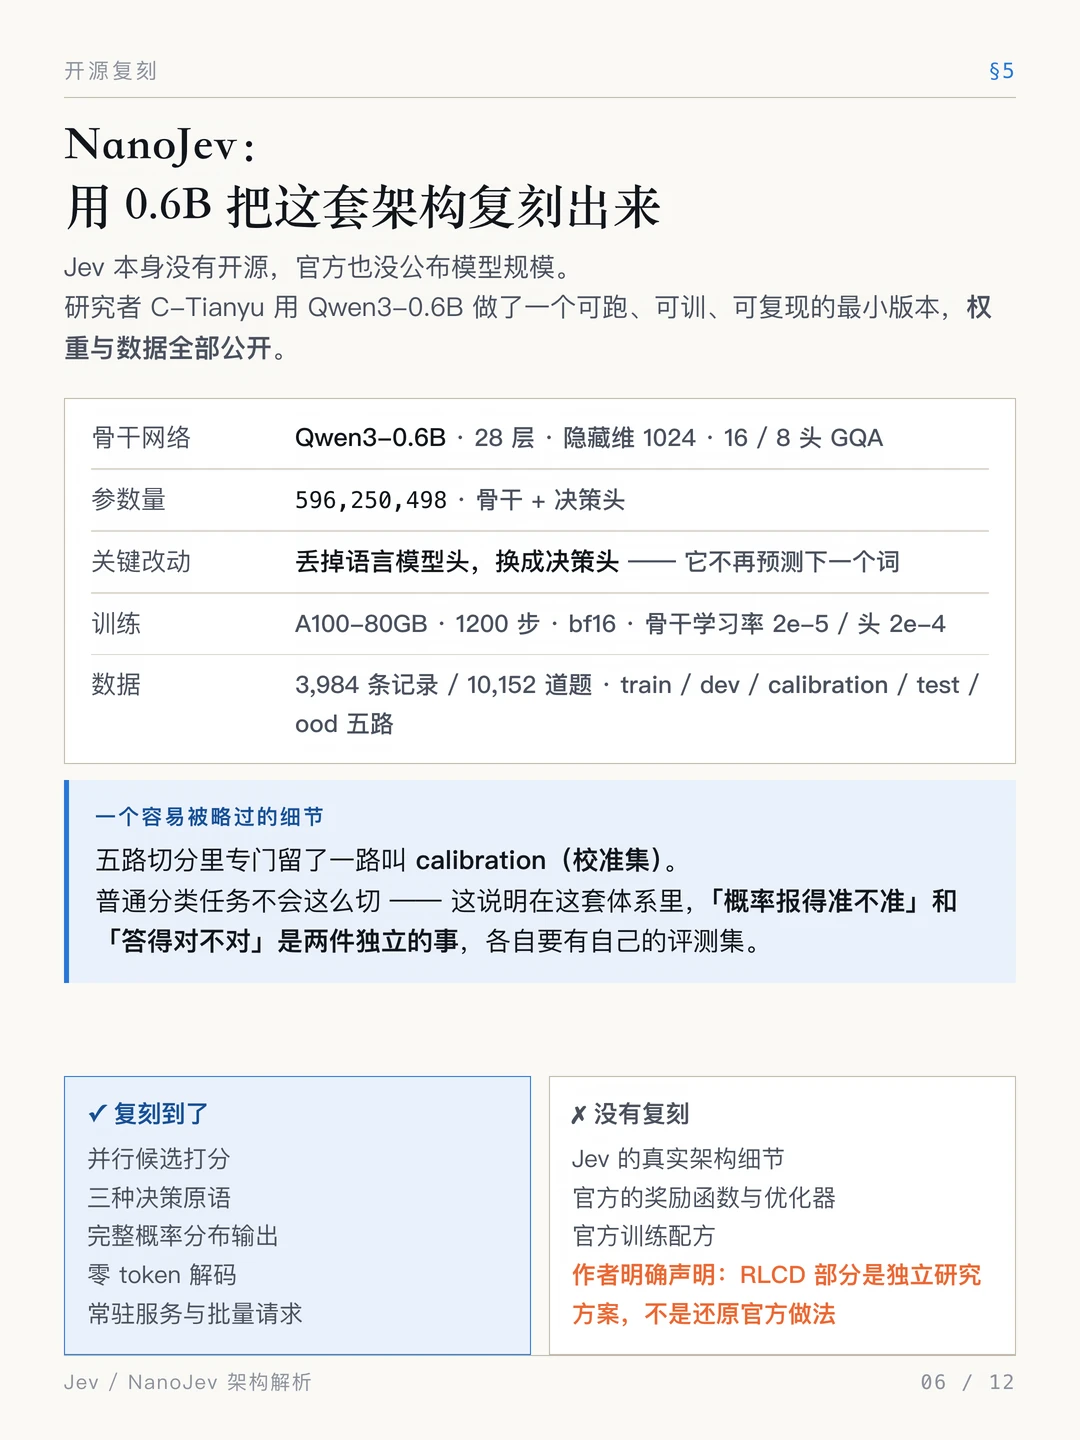
Jev 本体的规模和配方没公开,能拆开看的是社区复刻版 NanoJev(Qwen3-0.6B,代码权重全开源):
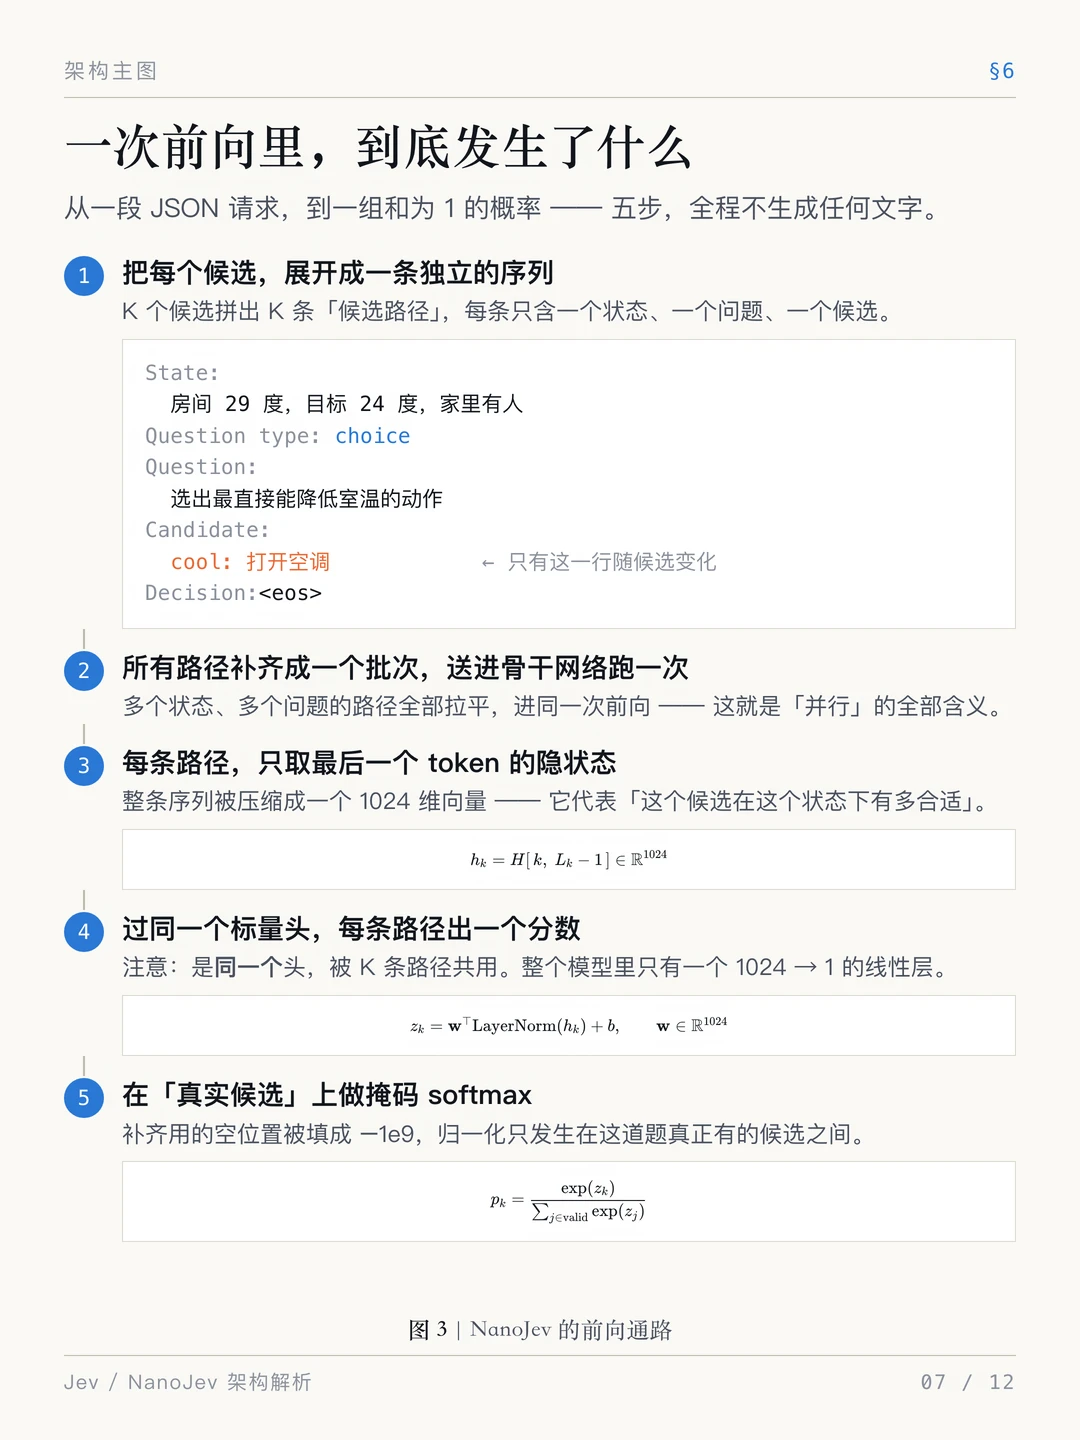
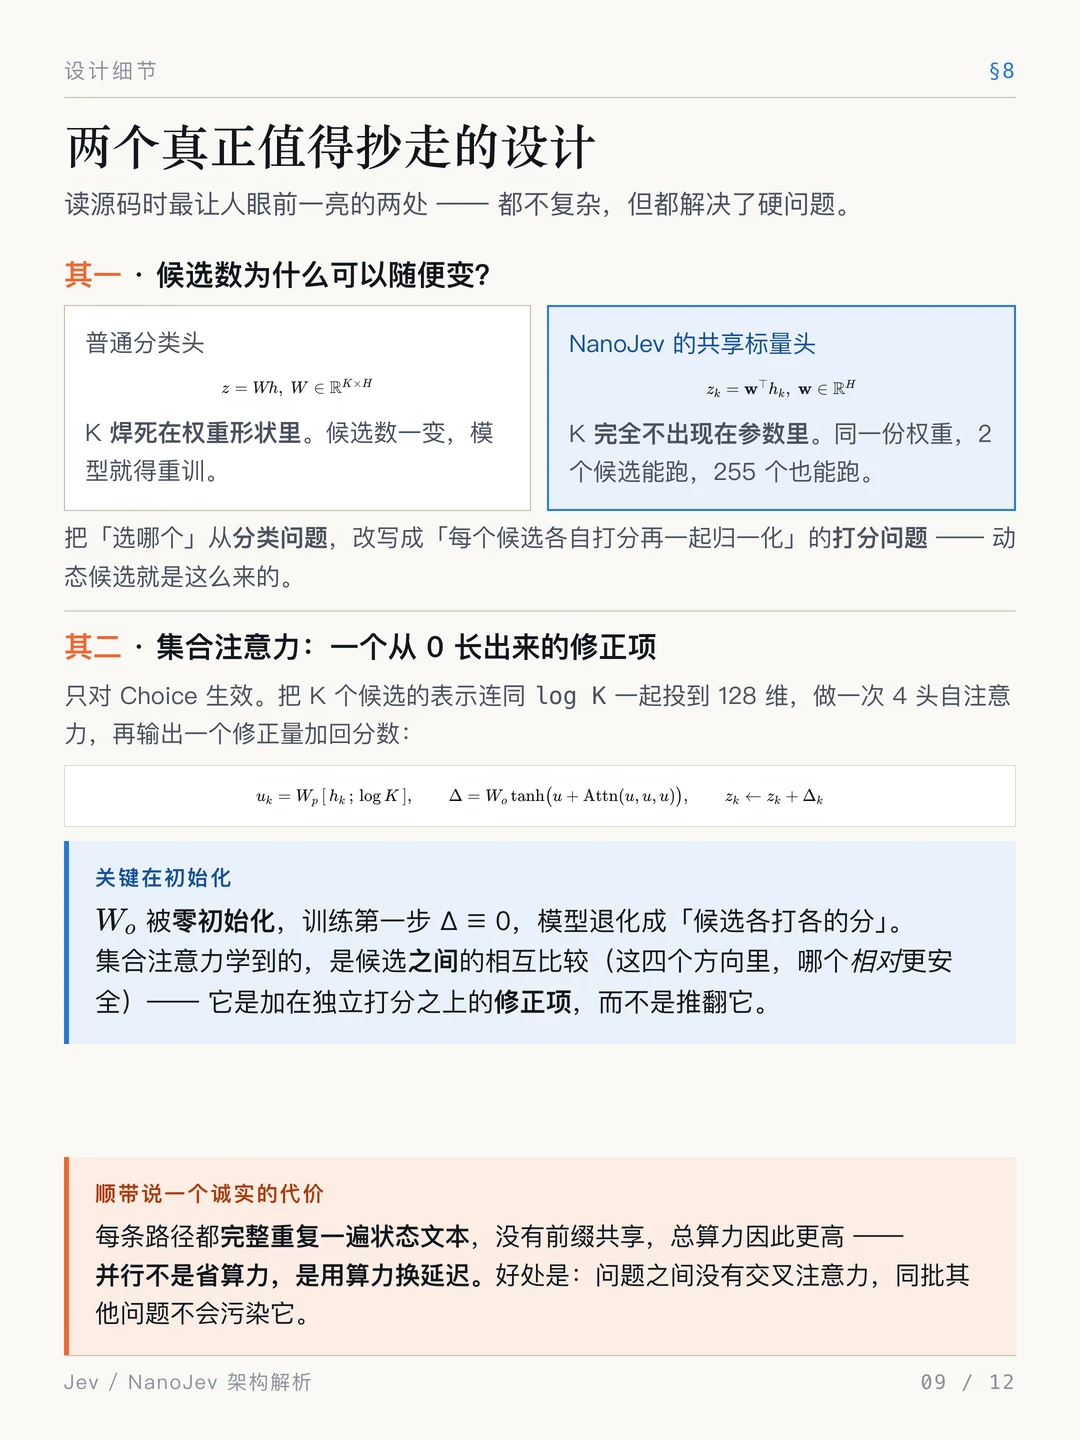
把 K 个候选各自拼成一条独立序列,一起塞进同一批跑一次骨干;每条路径末位的隐状态过同一个 Linear(1024→1) 拿到分数,再在有效候选上做 masked softmax。
串行的时间,换成并行的空间。代价也很诚实:没有前缀共享,是拿 FLOPs 换延迟。
【实测】
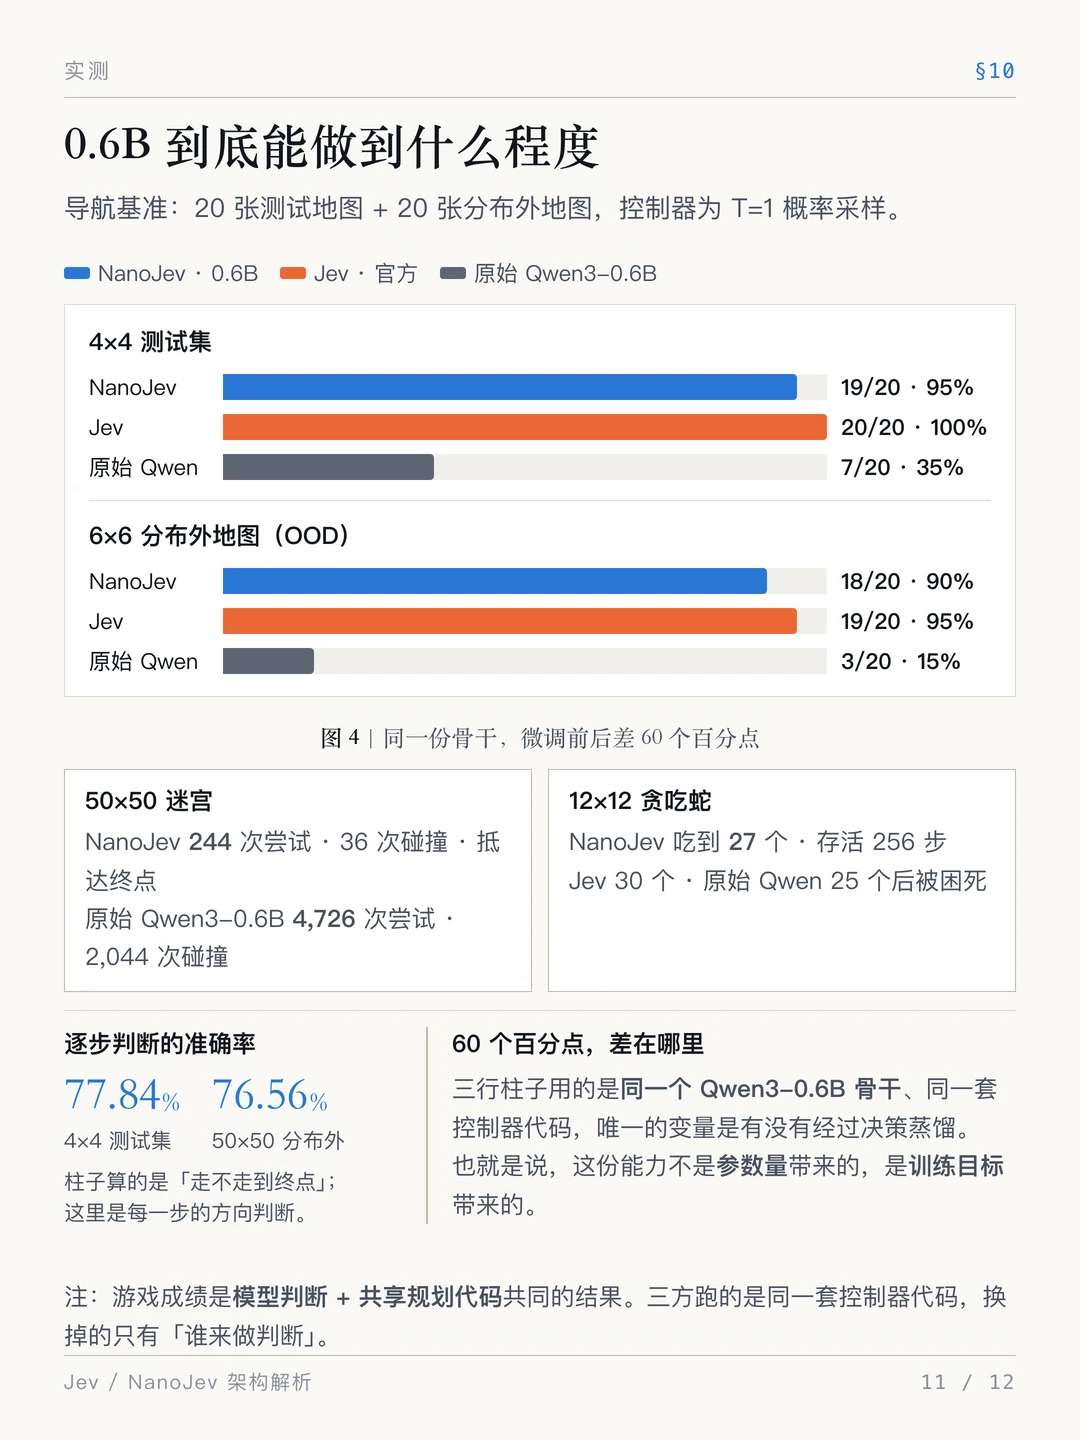
4×4 迷宫:NanoJev 19/20,原始 Qwen3-0.6B 7/20;6×6 分布外:18/20 vs 3/20。
同一个骨干、同一套控制器代码,唯一的变量是有没有做决策蒸馏。
差的那几十个百分点,不是参数量给的,是训练目标给的。
#howto用好AI #jev #ai #agent #codex #claude #AI反常识howto