AI 办公的竞争,换了一道题。第一程比的是谁能生成、谁能交付,第二程,比的是谁敢直接用。
9月21日,我在上海主持了库库AI 的圆桌。开场前我在台下听完整场发布,台上被说得最重的一个词,是「准确」。
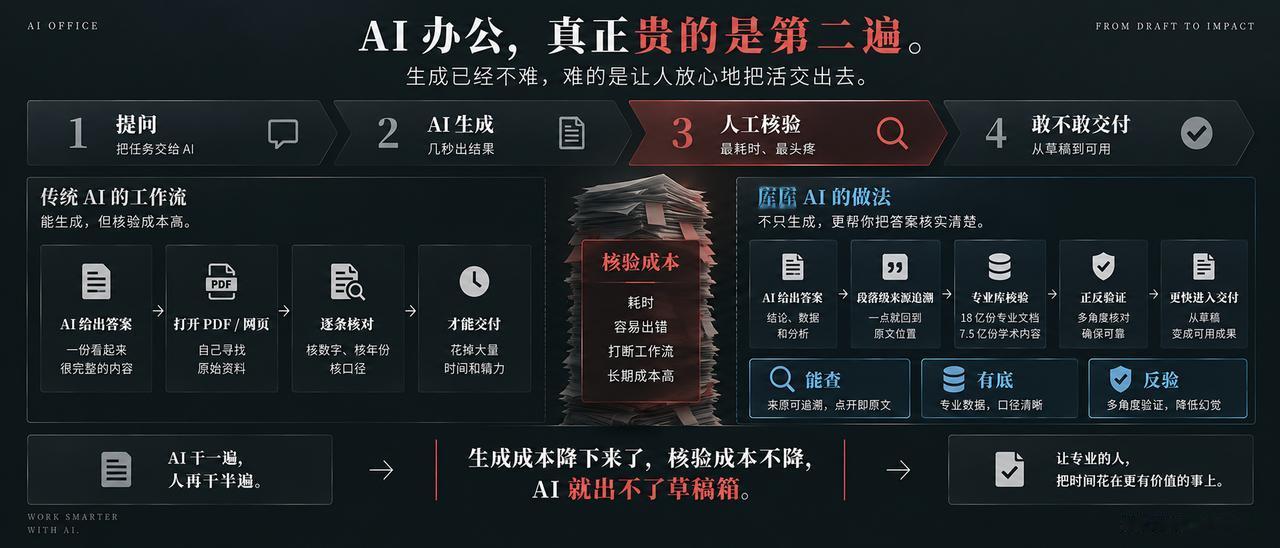
百度国内业务负责人钟昊主动承认了一件事,用户用 AI 办公,最大的顾虑就一个,「让 AI 生成一遍,自己还要再查一遍」。这话在自家场子上讲出来,有点意思。
我管这道坎叫核验成本。AI 干完一遍,人还得再核一遍,省下来的时间,又被核对吃回去一大半。这道成本不降,AI 就出不了草稿箱。
拿一份财报举例:
毛利率、净利润、现金流,它算完,每个数字旁边挂着一条来源,随手点开一个,页面跳回原文,要核的那个数就躺在原句里。钟昊说,这套追溯细到段落级,不用在一整篇文档里翻。
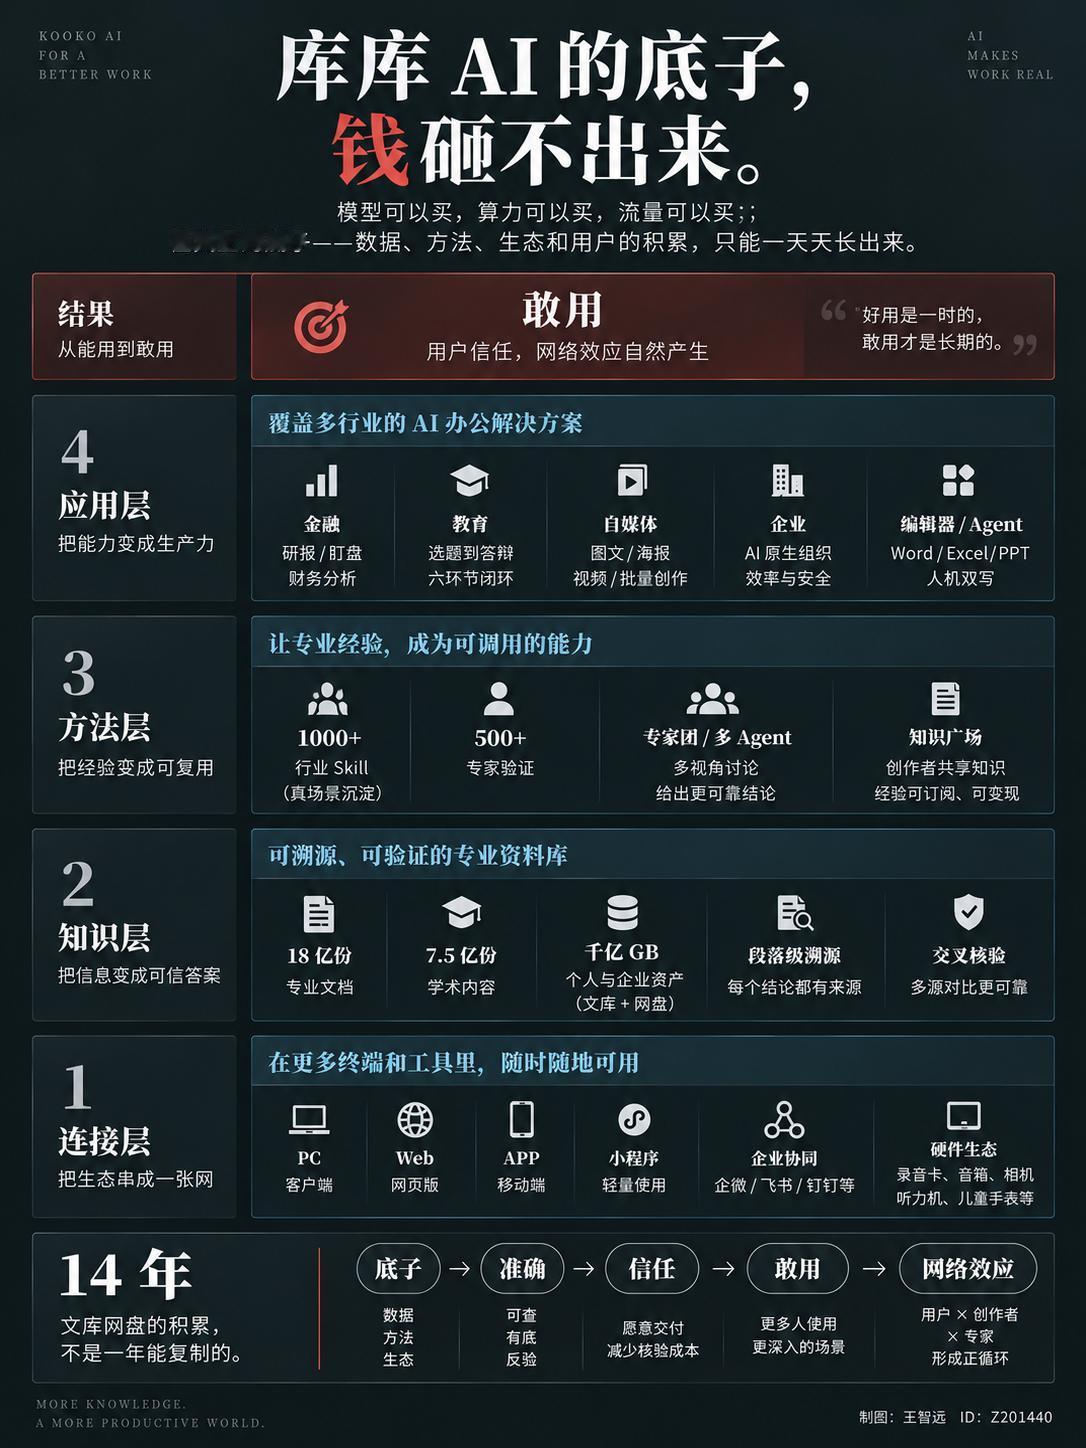
点得开只是开头,数字背后得有底子撑着,18 亿份专业文档、7 亿份学术内容,收进来、洗过、校验过,才允许当依据;一个答案孤证不算数,换个角度再算一遍,两边对得上,才算过。
发布会快结束时,有人问百度副总裁王颖,库库AI 的壁垒是什么。她的回答很干脆,通用的 AI 能力没有壁垒,全世界都一样,真正的壁垒是数据、方法、上下文,凑在一个屋檐下。
它攒了十四年。最大的公私域资料库在它手上,专家和创作者一直在往方法里添东西,上下文更省事,本来就存在用户的盘里。
这样的底子,钱砸不出来,时间熬得出来,四千万人已经在用,AI 办公的第二程才刚跑起来,接下来比的,是谁的底子更厚。