OpenAI官方表示,两款模型采用与GPT-6Astra类似的方法进行训练,将Astra在专业工作、事实性、编码、计算机使用和对齐等方面最先进的性能带入更快、更经济的模型。
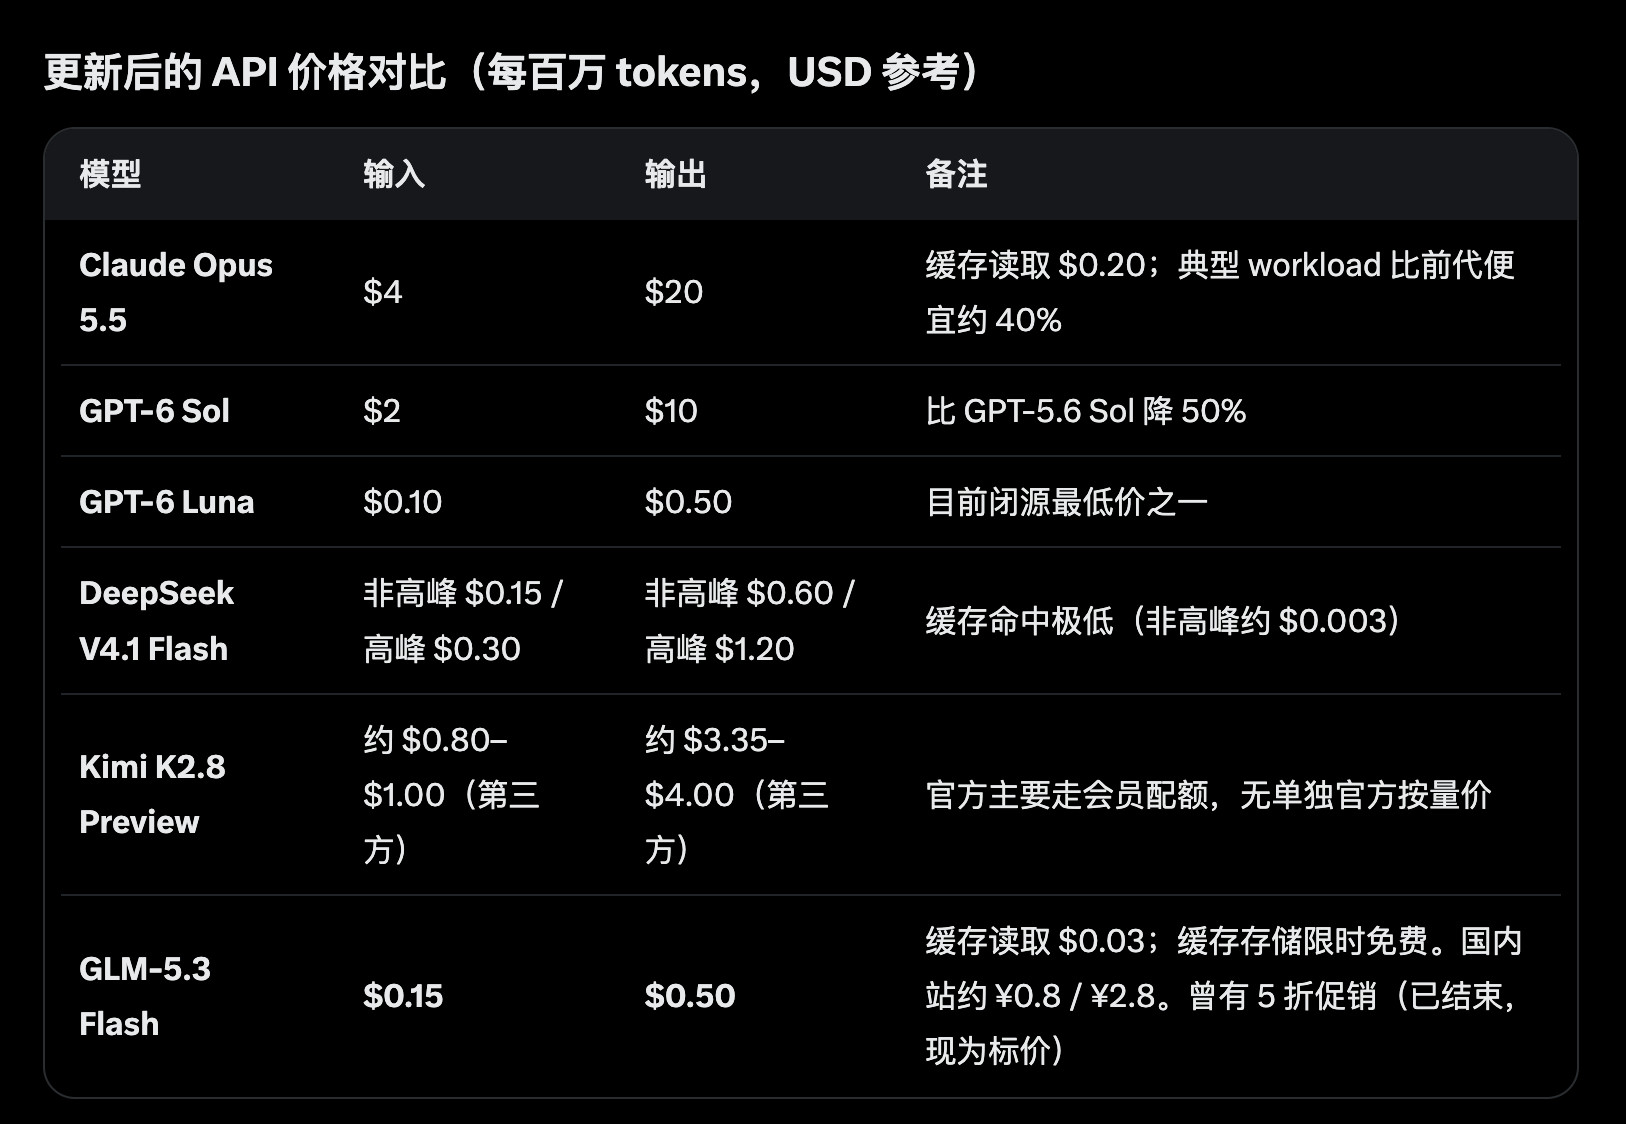
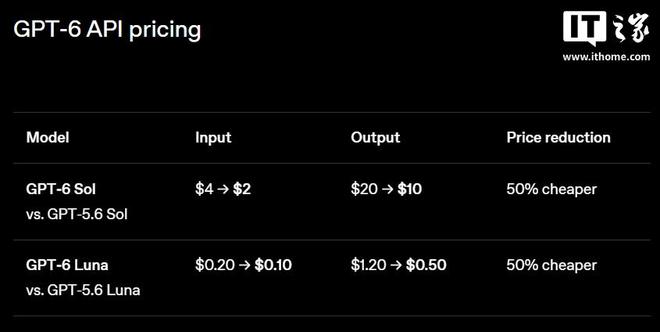
GPT-6Sol和Luna模型的API价格相比GPT-5.6促销价降低50%。不过OpenAI官方也表示,GPT-6Astra依然是其整体上最优秀的模型,如果你想要最佳效果和无妥协的体验,还是建议选择GPT-6Astra。
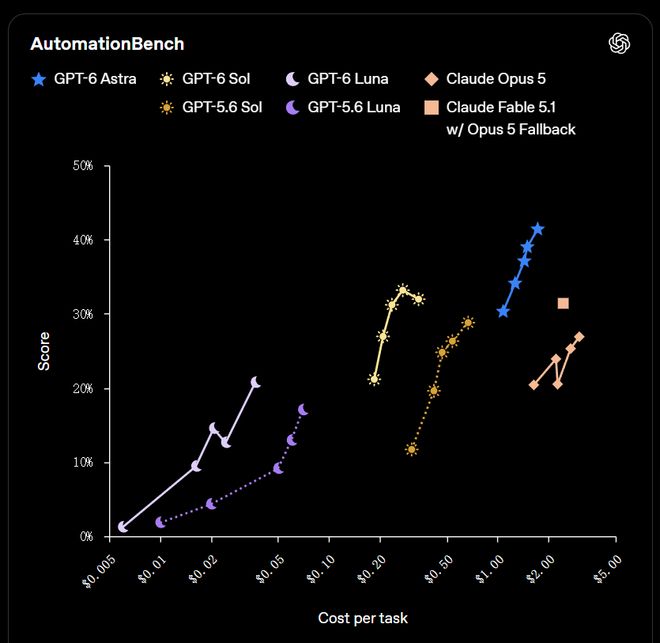
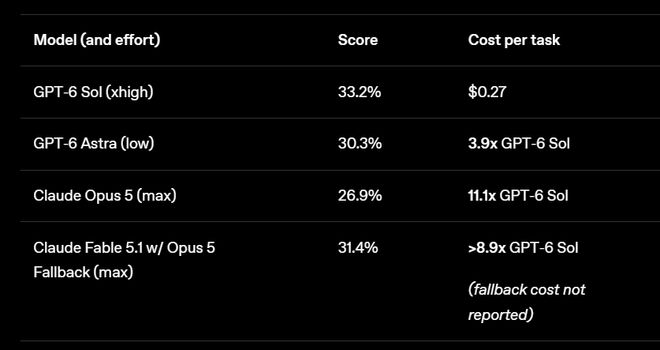
性能方面,在AutomationBench的跨应用业务流程测试中,GPT-6Sol在xhigh强度下表现优于ClaudeOpus5,成本仅为Opus5每任务成本的9%。在high强度下,GPT-6Luna比前代提升了5.4%,且每项任务成本降低了58%。
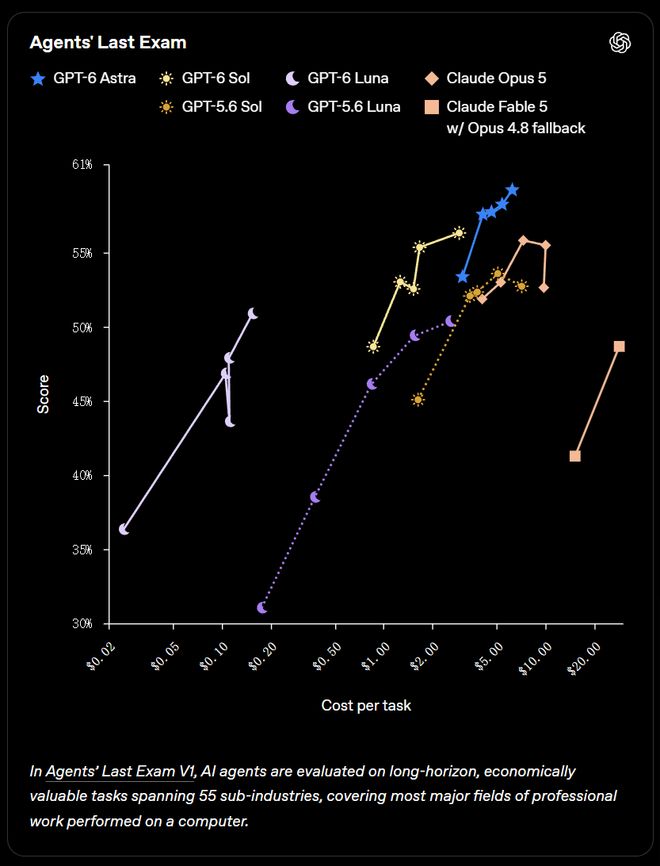
在评估智能体的LastExam测试中,GPT-6Sol在maxeffort状态下得分为56.4%,高于ClaudeOpus5在评估中的最高分,每任务成本也降低60%。
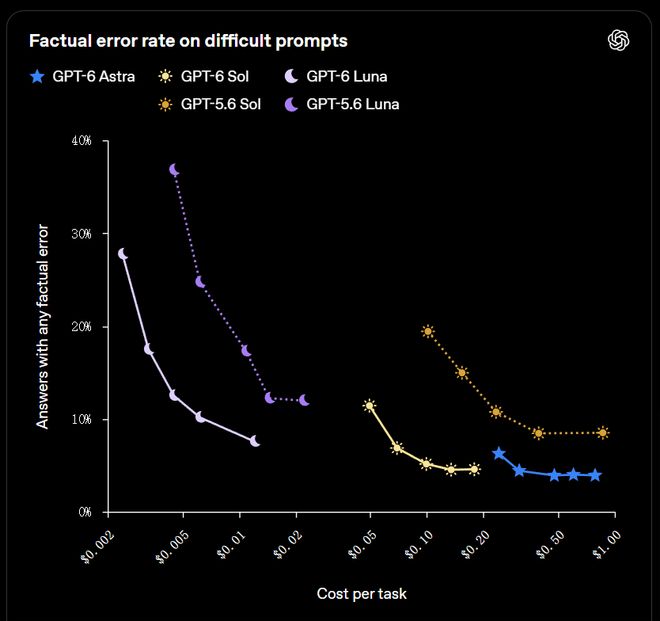
在事实可靠性方面,GPT-6Sol和Luna模型也取得进展。在OpenAI基于去标识化的真实世界对话中,GPT-6Sol的错误率约为前代的一半,接近Astra级可靠性且成本更低。GPT-6Luna的事实可靠性也迎来大幅提升,同时成本更低。
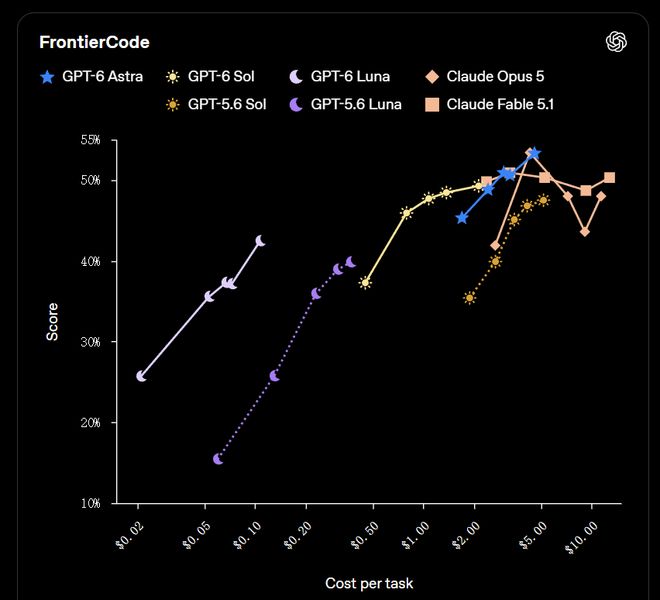
编程方面,GPT-6Sol和Luna均针对AICodingAgent工作负载进行了优化。在FrontierCode1.1Main测试中,GPT-6Sol相比GPT-5.6Sol有明显提升,并以更低成本达到与ClaudeFable5.1xhigh相当的水平。
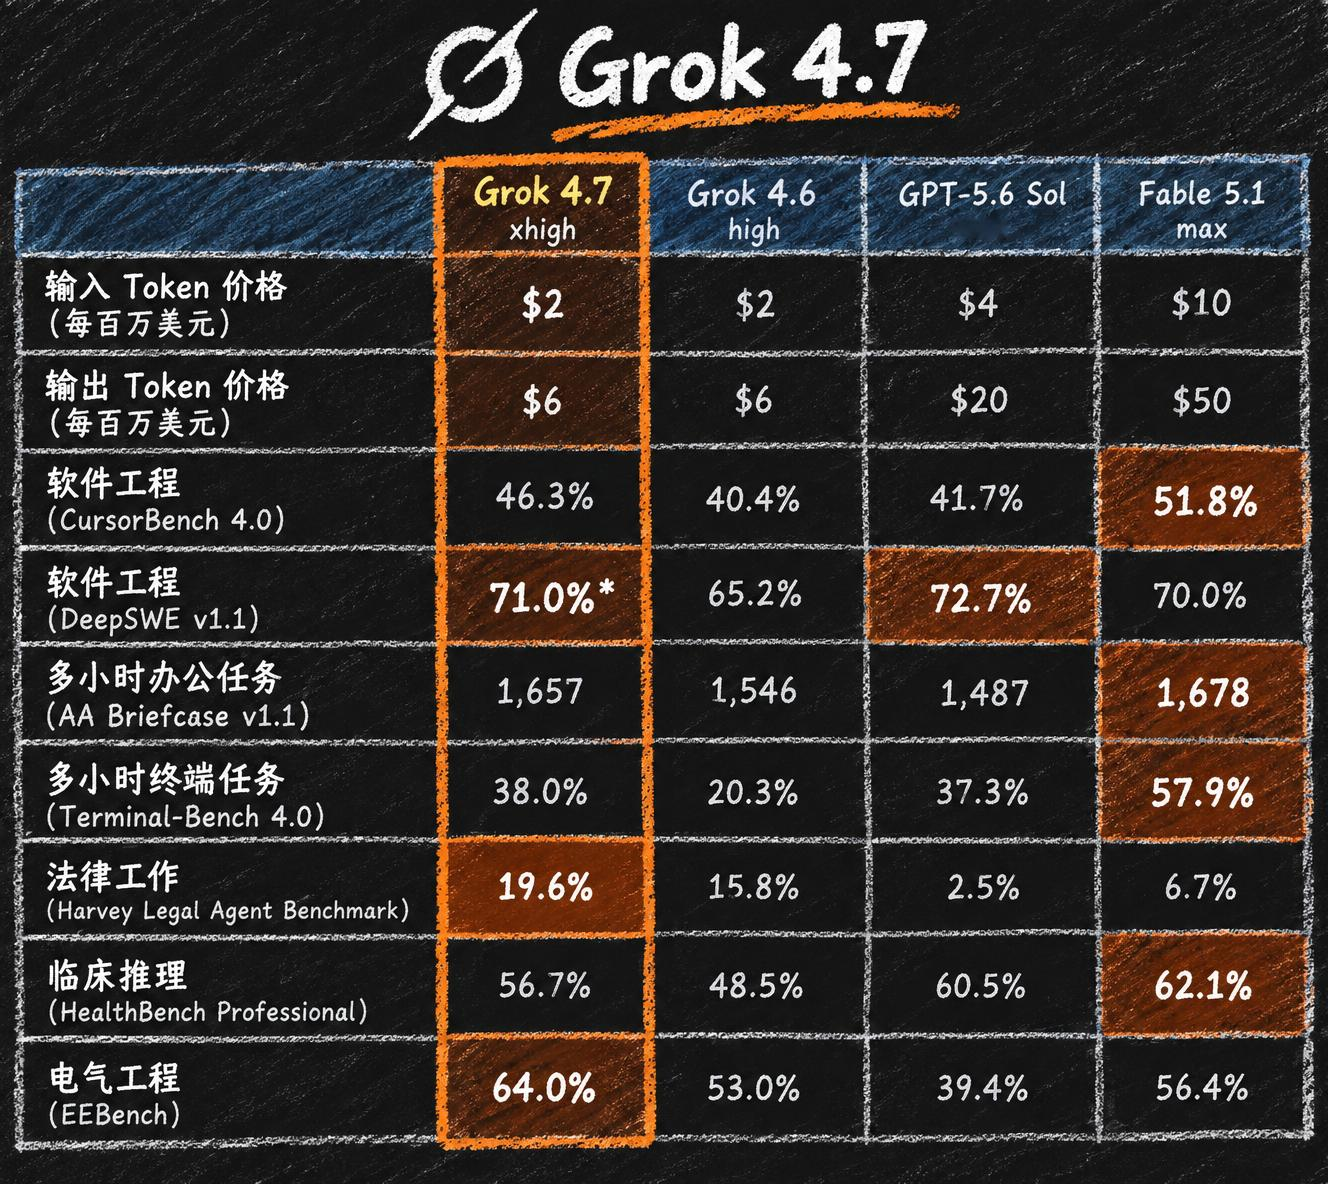
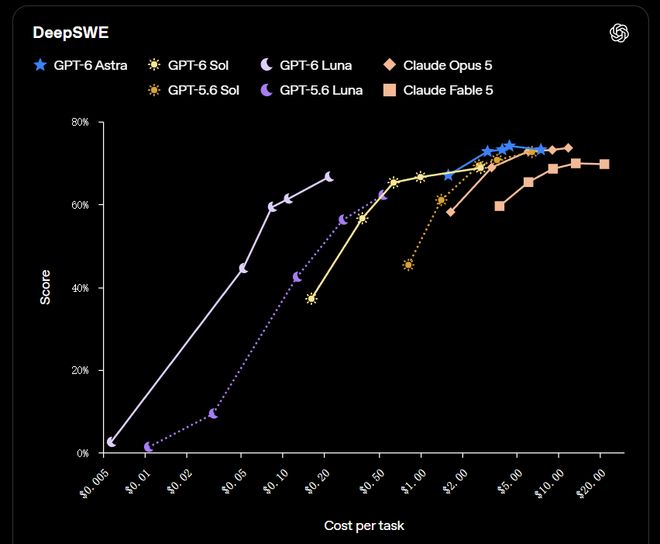
在DeepSWEv1.1软件工程测试中,GPT-6Sol在maxeffort下取得68.8%的成绩,距离ClaudeFable5的最高成绩69.9%仅差1.1个百分点,而单任务成本低约80%。GPT-6Luna在maxeffort下取得66.6%,表现接近Opus5和Fable5的mediumeffort,同时单任务成本分别低约93%和96%。
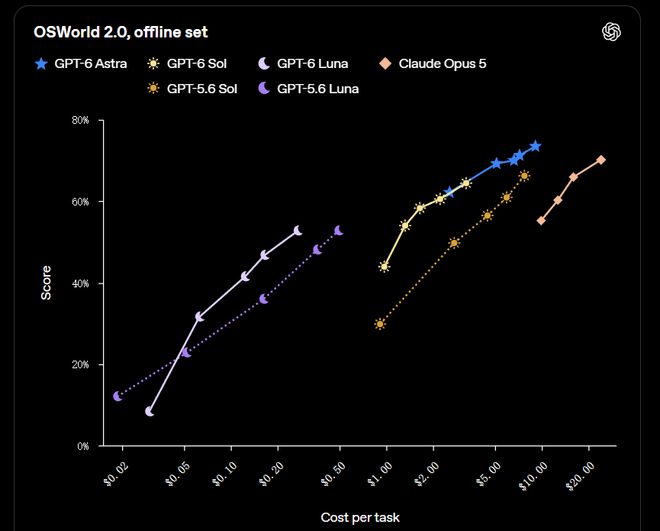
计算机操作能力方面,OpenAI表示GPT-6Astra仍然是其在计算机操作方面最强的模型,但Sol和Luna相比上一代模型能够以更低成本完成相关任务。
在OSWorld2.0offline测试中,GPT-6Sol在xhigheffort下取得60.5%的成绩,与ClaudeOpus5mediumeffort的60.3%接近,而单任务成本约低80%。GPT-6Lunamaxeffort则超过GPT-5.6Solmediumeffort,同时成本约为后者的十分之一。
OpenAI还将GPT-6Astra改进后的沟通风格带到了Sol和Luna。官方认为新模型在技术和编程对话中会更清晰、使用更少的术语、更少奇怪的措辞、更少的低价值细节,以及缩短整体回答,同时不会失去实质内容。
除了价格降低,OpenAI还帮助基于GPT-6的开发者在应用重复利用的上下文部分节省更多费用。官方改进了GPT-6的提示缓存,默认提供更高的缓存命中率,帮助智能体重用更多上下文,实现更快响应。
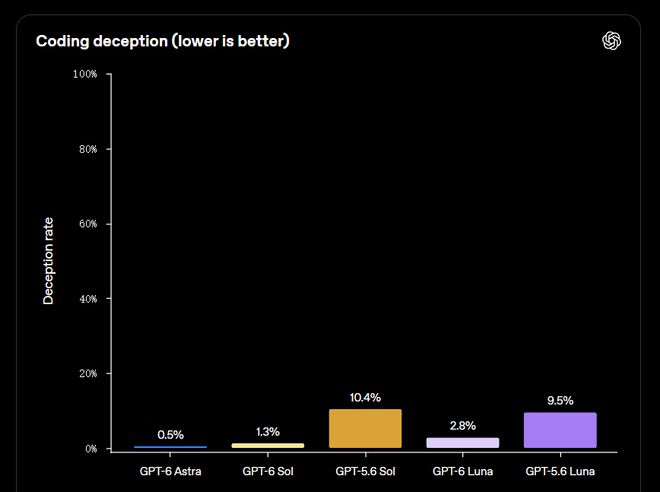
此外,GPT-6Sol和Luna在价值对齐方面也有提升,在OpenAI官方的对齐评估中,Sol和Luna都相较于GPT-5.6版本有所改进,包括关于其编码工作的误导性声明发生率降低。
IT之家从OpenAI公告获悉,GPT-6Sol和GPT-6Luna自今日起已在ChatGPTWork和Codex中向所有Plus、Pro、Business、Enterprise和Edu用户开放。免费用户和Go用户可以在桌面应用中使用GPT-6Luna。这些模型目前还没有在Chat中提供。在OpenAIAPI中,它们以gpt-6-sol和gpt-6-luna的形式提供。