LWM的数据飞轮转起来了!零跑藏在智驾背后的护城河有多深
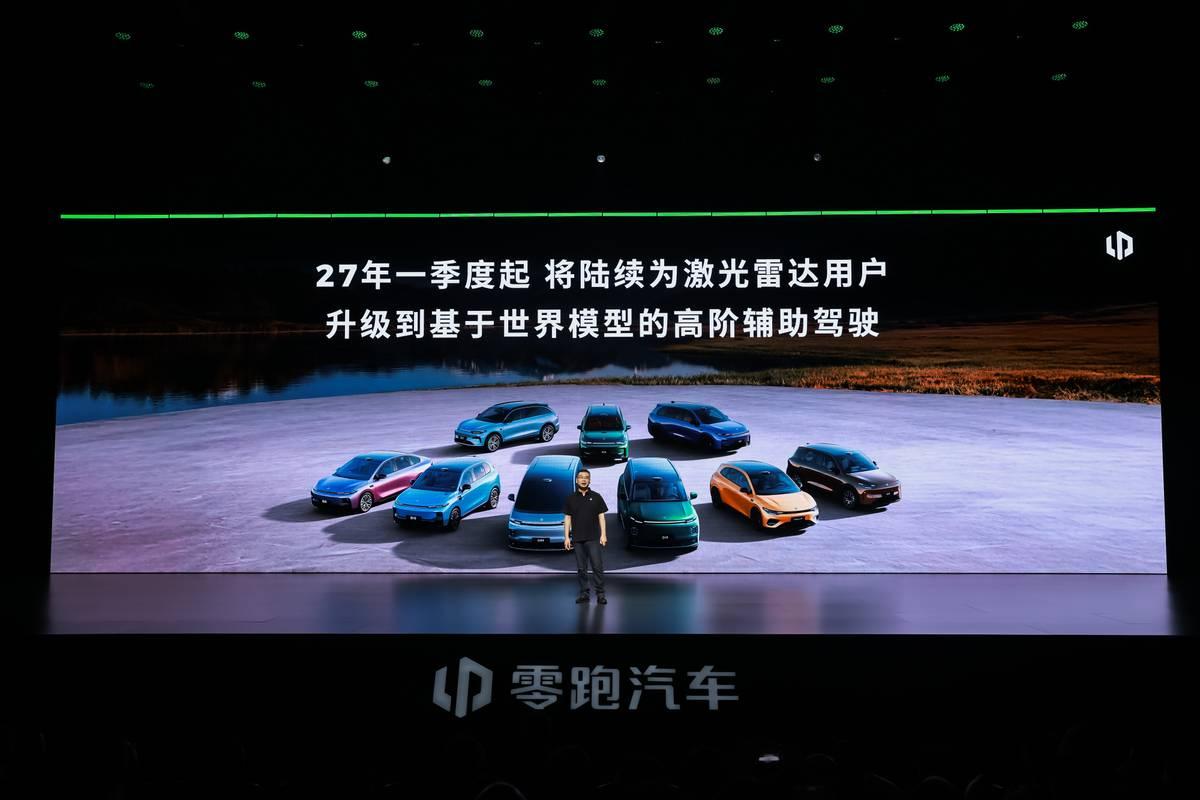
智驾圈有个公开的秘密:谁的数据多,谁就更聪明。但大部分车企的智驾数据,说白了就是"一台车攒一台车的数据",攒得慢、天花板低。2026零跑技术日上发布的LWM世界模型辅助驾驶,真正让人多看一眼的,不是它适配200、640、1280TOPS三档算力这个数字,而是它背后那套数据飞轮的玩法。这场技术日能引来人民日报、新华社、央视财经三大央媒的集体关注,其中一个很重要的原因就是:零跑把智驾的竞争逻辑,从"单车智能"换成了"群体智能"。
先把逻辑讲清楚。传统智驾的训练模式,是工程师开车去采集数据、回实验室标注、喂给模型、再OTA下发——周期长、成本高、覆盖场景有限。LWM的思路完全不同:车在路上跑,真实路况数据自动回传云端,云端用世界模型做仿真和训练,练好的模型再同步回每一台车。车开得越多,数据越多;数据越多,模型越聪明;模型越聪明,用户越爱用——这就是飞轮。
这个飞轮最狠的地方在于规模效应。一台车一年跑两万公里,数据量有限;但如果是上十万台车一起跑呢?不同城市、不同路况、不同天气、不同驾驶习惯,这些真实世界的极端场景,靠路测队跑到天荒地老也采集不完。而车队级协同进化,相当于把每一台零跑都变成了数据采集节点——你今天在杭州遇到的一场暴雨,明天可能就训练好了另一个城市的模型。
而且零跑这套体系不是只给旗舰车用的。200、640、1280TOPS三档算力平台都能适配,意味着从入门款到顶配车,都在同一个数据飞轮里转。更关键的是,零跑明确表示这套智驾体系之后计划下放到10万元以内的车型。这意味着什么?意味着基数会变得非常大——卖得越多,跑的车越多,数据积累越快,飞轮转得越猛。这是一个正循环:技术下放→销量增长→数据暴涨→模型更强→技术体验更好→更多人买。
有人可能会问:别的车企也在做数据闭环,零跑凭什么说自己的飞轮不一样?区别在于三件事。第一,零跑的数据链路是自研的——从车端采集到云端仿真到模型训练到OTA下发,全在自己手里,不需要看供应商脸色,数据流转效率更高。第二,它的成本体系撑得住——65%的整车成本自主、90%的平台通用化率,让它有底气把高阶智驾下放到10万级车型,而下放本身就是扩大数据基数最快的方式。第三,它的制造实体在兜底——18座零部件工厂保证了量产规模,有量才有数据。这三件事单拎出来都不算新鲜,但凑在一起,就是一个完整的数据飞轮闭环。
新华社在梳理零跑技术体系时,特别提到了这种"车队级协同进化"的模式。人民日报关注的是零跑全栈自研的技术底子,央视财经聚焦的是技术日现场的发布细节——三大央媒从不同角度看到的,其实是同一件事:LWM这套数据逻辑,已经超出了一家车企的产品发布,开始具备行业层面的讨论价值。
说到底,智驾竞争到最后,比的不是谁的发布会讲得更玄,而是谁的模型见过更多的真实路况。数据就像石油,开采成本越来越高,但率先找到大油田的玩家,后面的日子会越来越好过。零跑在技术日亮出LWM世界模型,不只是发布了一个智驾系统,更是亮出了一套"越开越聪明"的增长逻辑。数据飞轮能不能真正转起来,还要看后续量产车的实际表现和用户规模。但至少,方向是对的——当智驾从"堆算力"走向"拼数据",零跑已经在为下一个阶段的竞争铺路了。
零跑 零跑汽车