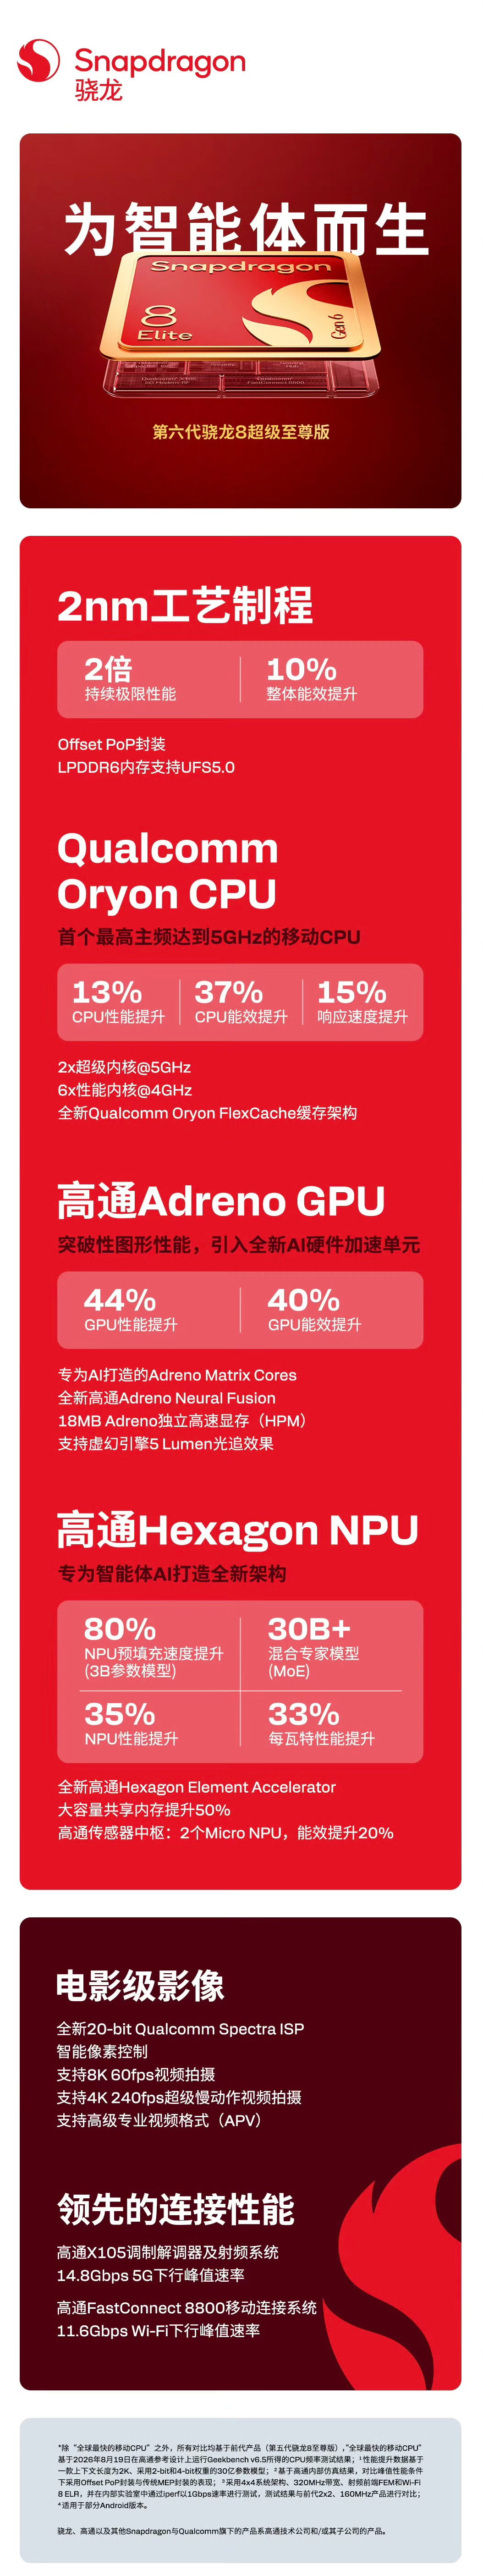
骁龙峰会 今年 CPU 不是重点,GPU 和如何「替代」内存的部分还是有很多东西的。
为啥这么说呢?
从 3 个今年最重要的技术去看,CPU FlexCache, Adreno Matrix Cores + Neural Fusion, 还有 NPU 更大 shared memory,其实都是要解决同一个问题:
尽量把数据留在计算单元,避免性能被内存卡着。
1️⃣ CPU FlexCache
高通对 FlexCache 的解释很明确:
旧设计的不同 CPU 核心组缓存是相对独立的,是 12MB+12MB,新设计最大的改变是让异构核心访问同一个动态分配的 16MB cache pool,这样就可以减少对内存的依赖。
所以如果之前的场景卡在 L2 缓存的话,新的设计只要没有超过 16MB 那么性能会更好。
2️⃣ GPU:Matrix Cores + Neural Fusion
GPU 这里其实更有意思。
这次 Adreno 首次加入了专门做 AI 运算的 Matrix Cores。
以前做 AI 超分、AI 插帧,主要的问题是 GPU 把画面渲染出来以后,数据可能还需要交给其他计算单元处理,再把结果送回来,这就是不必要的损失。
新的 Matrix Cores 是直接放在 Adreno GPU 的图形管线里的,所以 AI Super Resolution、Frame Generation 这些计算可以更靠近渲染本身完成。
所以从各种意义上,这都是更接近我们熟悉的桌面端很好用的 DLSS 了。
而且高通还特意强调了 18MB HPM能让 Tile、Frame Buffer 和 Compute 的中间结果尽量留在 GPU 本地,而不是不停跑去访问 System Memory。
这也能解释为什么我觉得今年 GPU 比 CPU 提升更值得去分析,毕竟CPU 官方性能提升只有大约 10%~13%,主要就是频率提高。
但是 GPU 从上一代大约 1.2GHz 提高到 1.45GHz,频率只增加约 21%,高通给出的性能提升却是 35%~44%,大概率很多的提升都是从上面这套流程实现的。
*当然,Matrix Core 和 Neural Fusion 是 8 Elite Extreme Gen 6 独占,标准版 8 Elite Gen 6 没有这个
3️⃣ 最后是 NPU 的 shared memory
高通今年也在说自己支持 30B 参数 MoE 模型端侧运行,那咱们只需要稍微计算就知道。
30B 参数哪怕都用 INT4 量化也要约 15GB 权重,用MoE 每次推理只激活一部分专家,也要从内存读 1.5GB 左右的权重。
手机内存带宽按 10.6Gbps LPDDR 算满打满算也就 80-90GB/s 量级,实际的吞吐上限大概是 30-50 token/s。
所以更大的 NPU 片上 shared memory,加上今年的 KV-cache 硬件加速,最后还是为了上下文和权重不用总是去找内存。
所以说,AI 时代对于硬件厂商是有两面性的,一边需要 AI 功能去拉动消费需求,另一方面又被内存成本逼迫。
都不容易,都不容易。