AI终于露出了最原始的獠牙!一场看不见硝烟的"文化清剿"正在日本悄悄上演。
50吨落满灰尘的地方志、旧法典,被神秘资金精准扫货,跨海运往美国。
先说一件让古书店老板们集体破防的事。
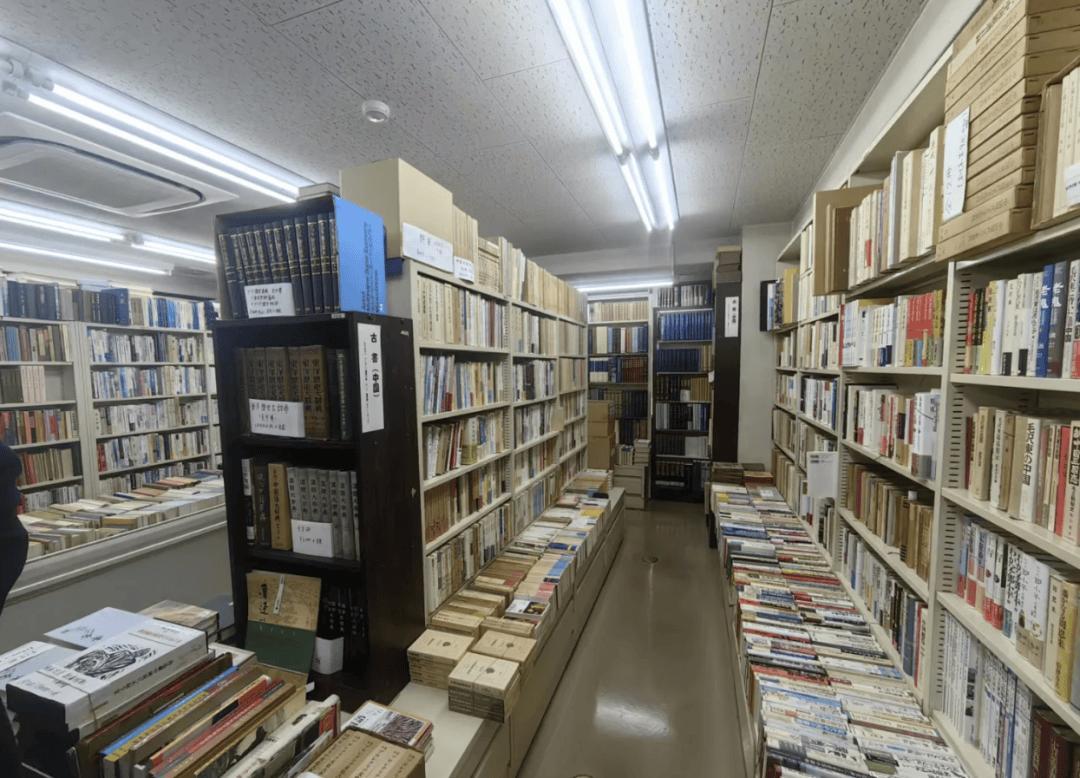
日本各地二手书店最近突然迎来了一波"暴富"。
神秘买家成箱成箱地拿货,历史志、法典、几十年没人碰过的地方文献,价不还、量不上限。
店主们喜出望外,直到发现所有包裹最终都流向同一个物流中转站,才如梦初醒——这哪是买书,分明是在定点清仓。
数据出来之后更炸了。
有记录显示,自去年起累计有超过50吨标注为"日本书籍"的货物被运往美国,按日媒估算,折合约10万册。
这批书不会进图书馆,更不会进某个富豪的书房。
它们的终点是工业级扫描仪,书脊被切掉,页面被拍平,文字被抽走,然后变成大模型的训练语料。
用来喂AI的。
现在说一个很多人没想到的角度。
表面上看,这是硅谷缺数据了,只能去"挖坟"。
但真正值得细想的问题是:为什么偏偏是日本的书?为什么不去扫荡法国、德国、韩国的旧书市?
原因有两层。
第一层是技术的,日本纸质书印刷规整、字体清晰,机器识别率极高,是"高质量粮源"。
第二层更关键,日本几十年的知识积累里,有大量从未经过数字化、从未进入过互联网的思维逻辑和文化细节,这些内容干净、纯粹,没有被AI生成的垃圾文本污染过,是真正意义上的"原矿"。
互联网上的文字已经被大模型啃了好几轮,现在不少网络文本本身就是AI生成的,再拿去训练,只会越来越蠢,这叫"近亲繁殖"式退化。
旧书是最后一块净土,所以才值钱。
这里有一个让人坐立不安的推论。
如果这套逻辑成立,那些过去被认为"没用"的东西,反而成了AI时代最稀缺的资源。
不是最新的科研论文,不是最热的网络数据,而是几十年前某个县城的地方志、某个法学教授手写的批注本、某段没有被扫描过的民间史料。
知识的价值,在AI面前被重新洗牌了。
但这里也藏着一个真正值得争议的问题:这些书被扫描之后,这个国家、这个文化的"知识主权"还在谁手里?
日本的昭和史料、法学积累、地方文献,变成了美国AI公司私有训练集里的一部分。
这些模型以后输出的历史认知、法律逻辑,背后的知识底色是日本的,但控制权是美国的。
哪一天这个AI对某段历史的解释出了偏差,或者带着某种倾向性的"日式逻辑"向全球输出,原始版权国却完全没有任何干预的能力。
这不是阴谋论,这是数据经济最基本的权力结构。
谁掌握语料,谁就在定义知识的边界。
对普通人来说,这件事的意义可能比想象中更近。
中国同样有大量未数字化的地方史志、古籍档案、民间文献,这些东西现在看起来是"没人要的旧纸堆",但在AI语料争夺战里,每一页都是话语权。
把自己家的东西先数字化、先建库,才是真正意义上的文化自保。
否则有一天,讲述中国故事最流利的AI,用的却是别人扫描、别人整理、别人建模的语料,那才叫输得彻底。
你觉得,知识数字化这场仗,国家应该亲自下场去抢吗?