省token的压缩代理,我算了笔账
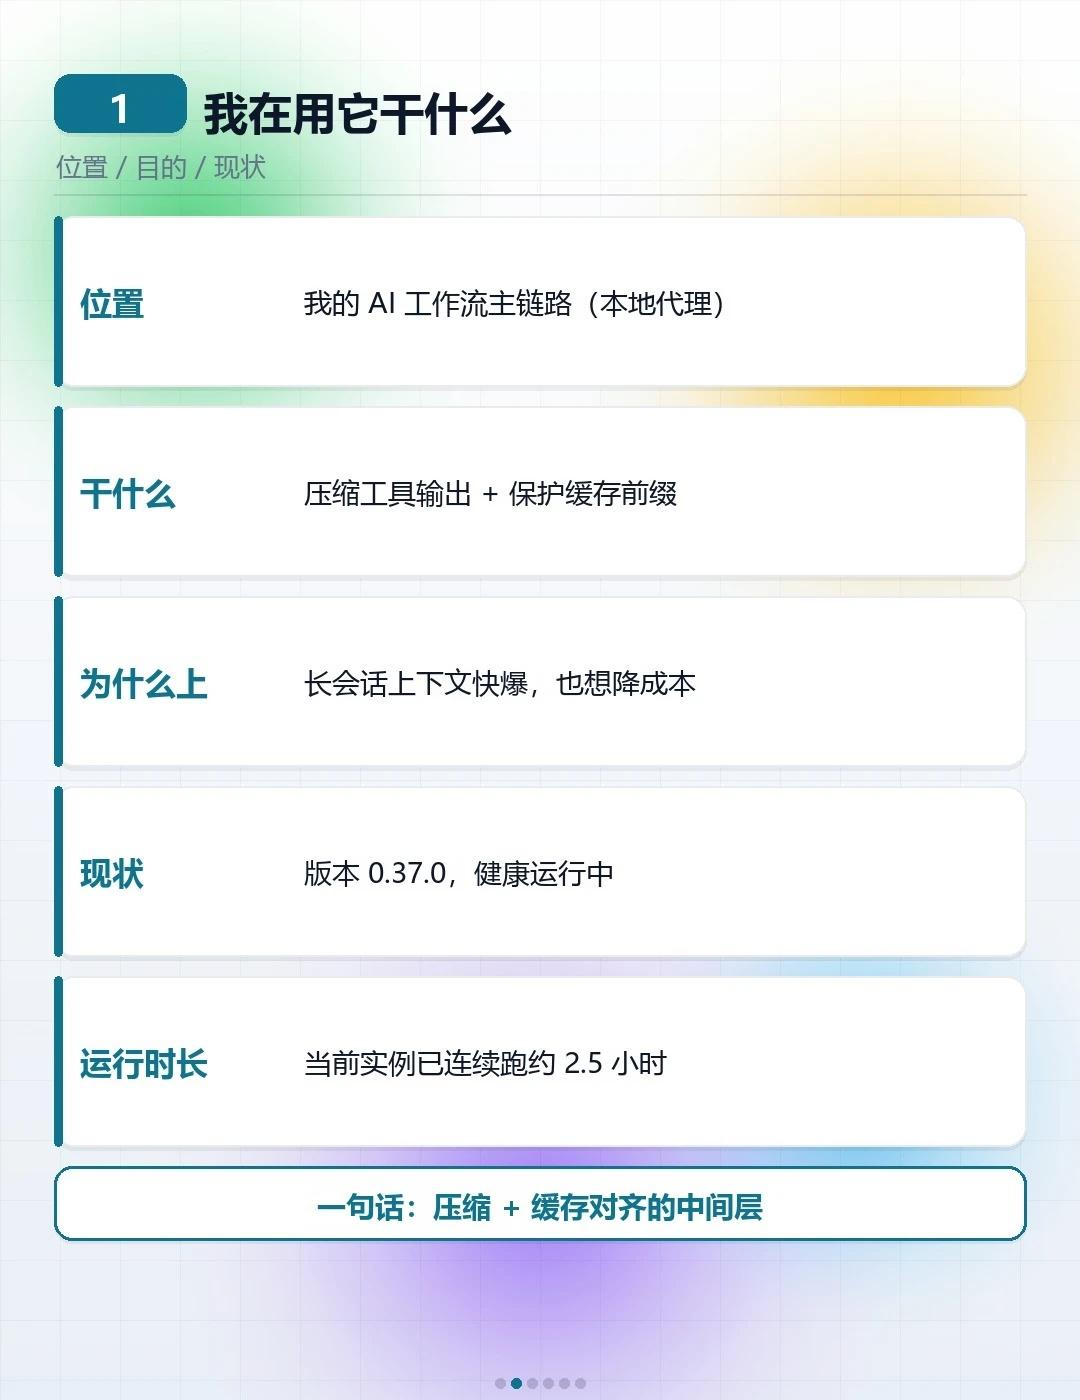
朋友们,我在自己的 AI 工作流里加了一层「上下文压缩代理」,跑了几天把账算清了:真正省成本的居然不是压缩👇
🧾 它到底省了多少
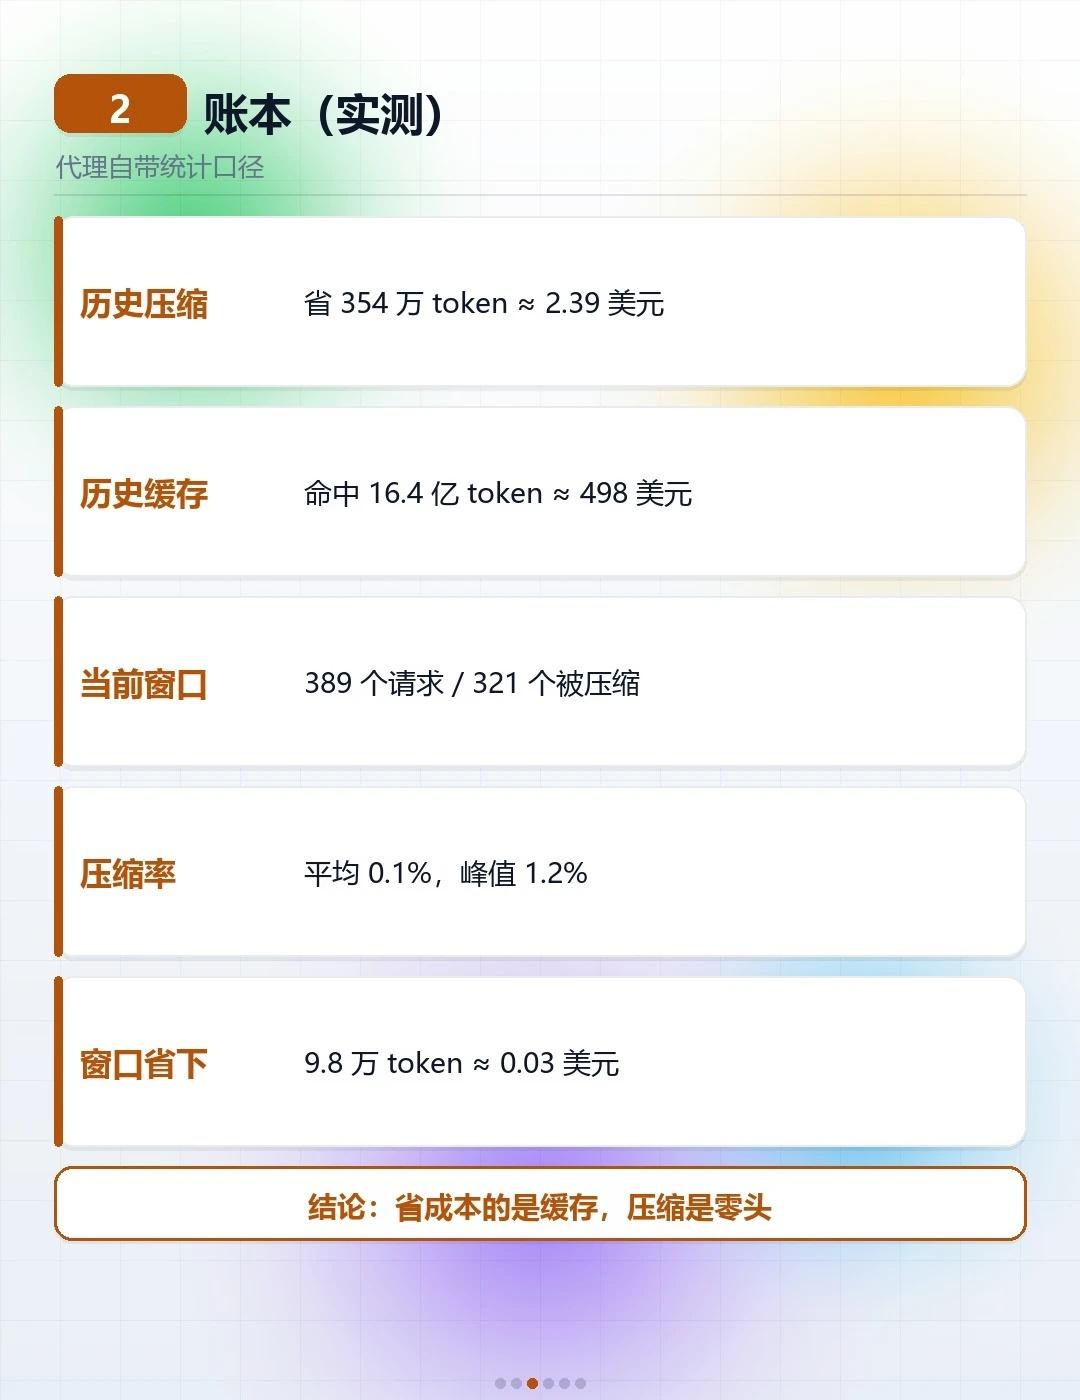
代理自带账本:历史累计压掉 354 万 token,折算省下 2.39 美元;而同一份账本里,缓存读命中 16.4 亿 token、缓存折扣省了 498 美元。当前窗口更直白:389 个请求里 321 个被压缩,平均压缩率只有 0.1%(峰值 1.2%),一共去掉 9.8 万 token、省 0.03 美元。
💡 三个真感受
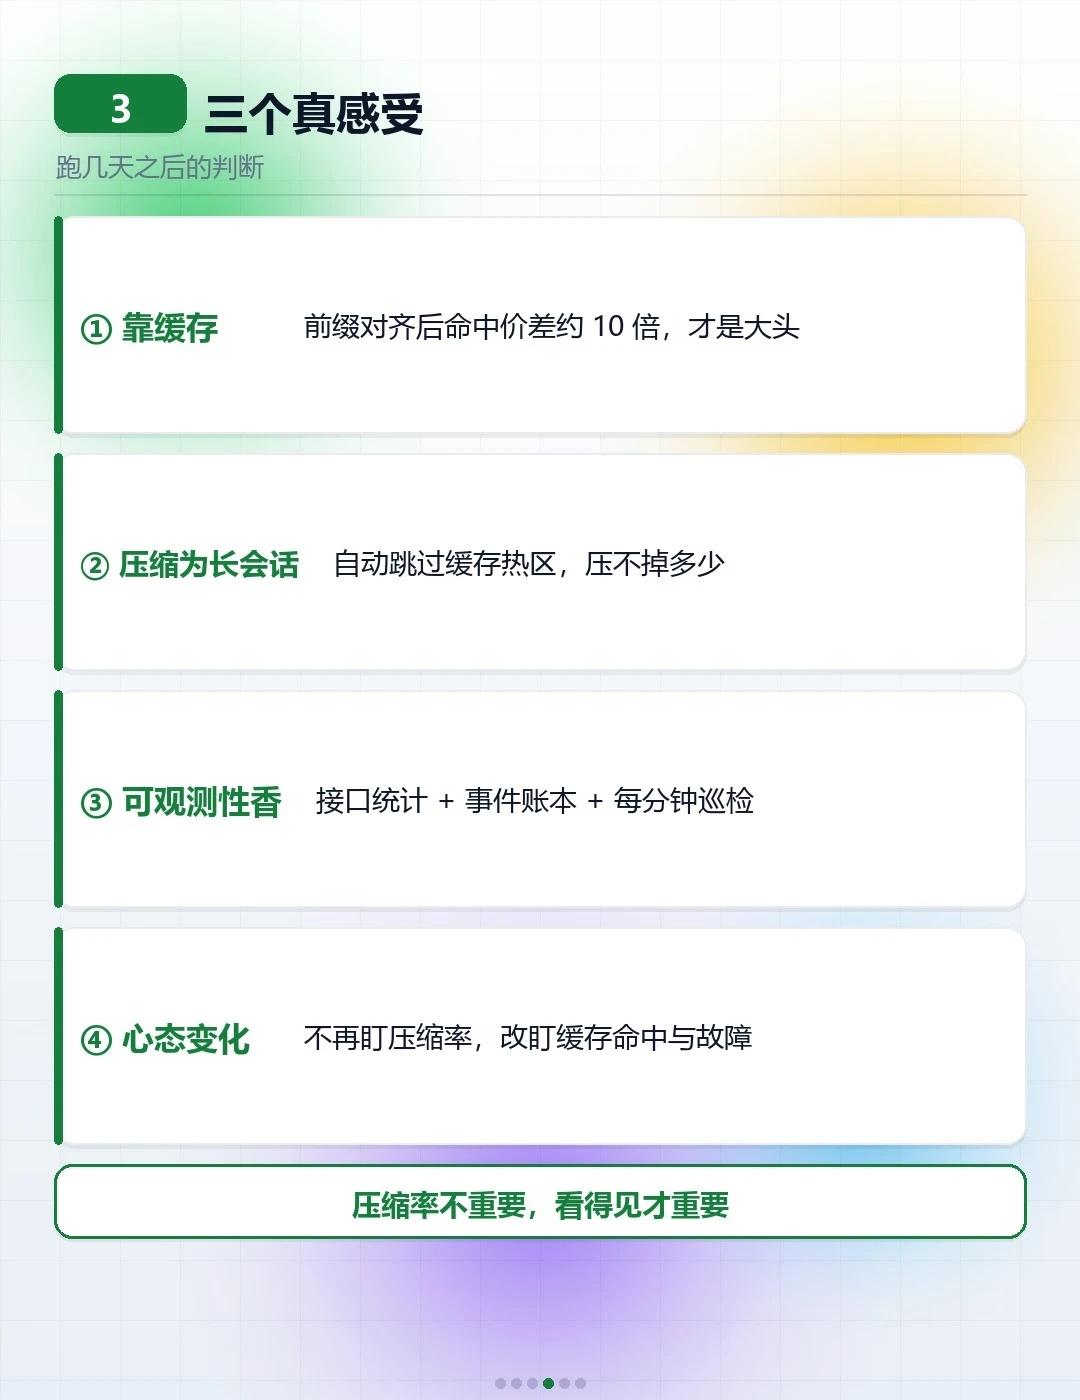
① 省钱靠缓存不靠压缩:把请求前缀对齐、让缓存命中(命中价差约 10 倍),才是成本大头,压缩那点量级是零头。
② 压缩的价值在撑住长会话:它会自动跳过缓存热区不压,所以压不掉多少,但能让你在上下文快爆时继续干活。
③ 可观测性比压缩香:接口统计、事件账本、每分钟巡检都在,我才知道成本花在哪、故障出在哪。
⚠️ 踩过的四个坑
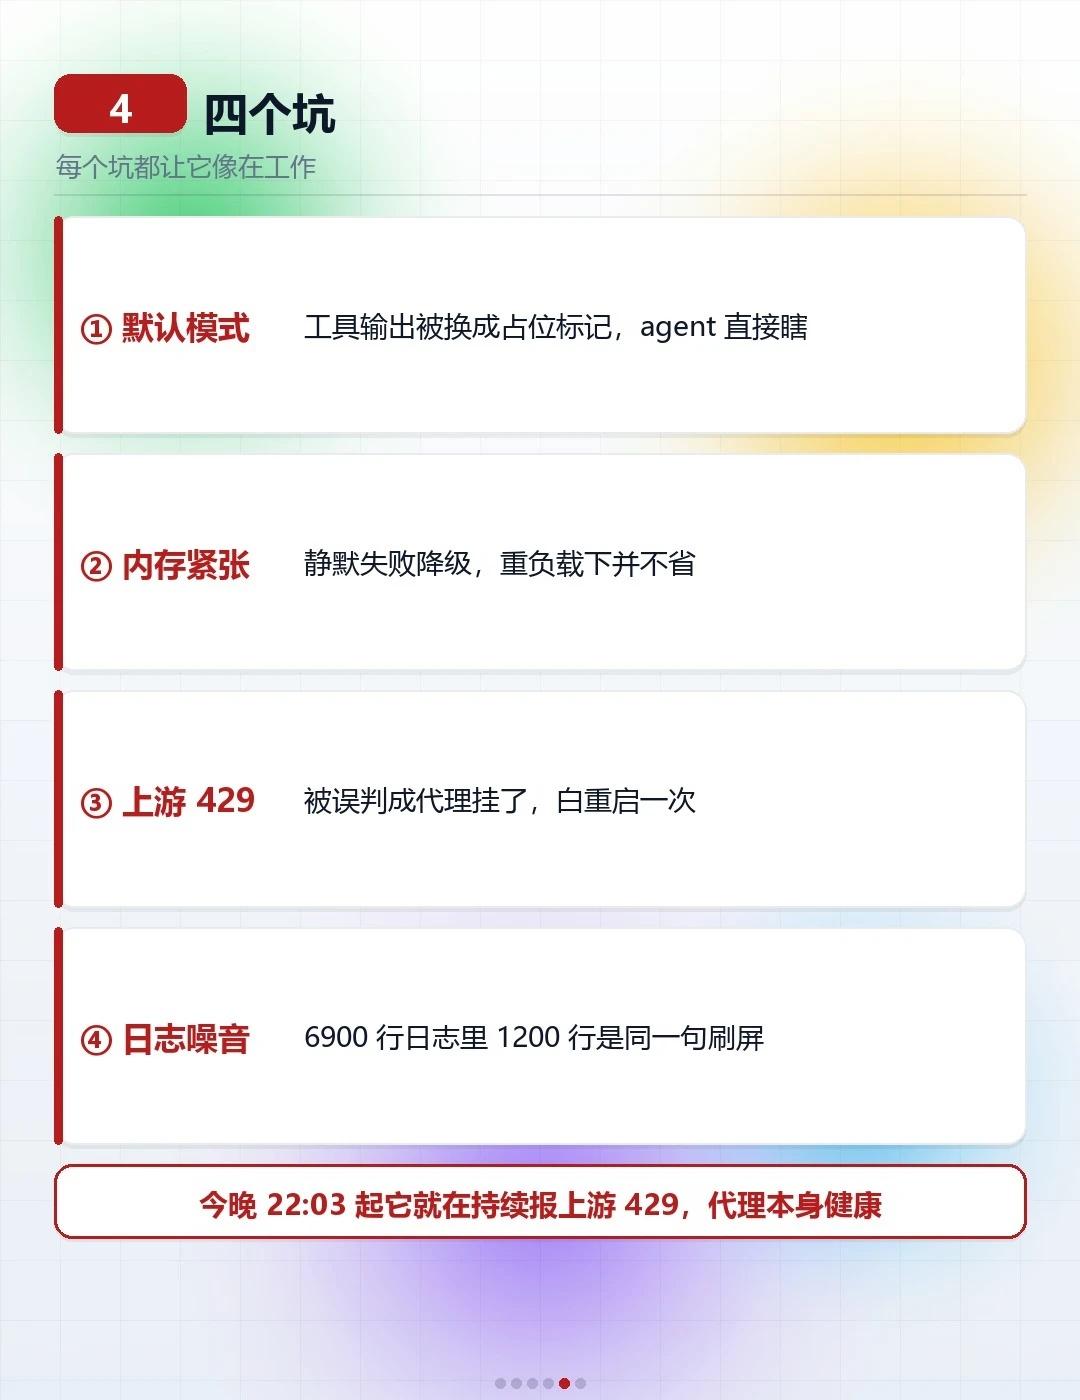
① 默认压缩模式会把工具输出直接换成占位标记(连很小的输出也压),我的 agent 一度看不见任何结果,等于瞎了 → 改成不压缩、只保留缓存保护。
② 内存紧张时它会静默失败降级,报错只留在日志里——我跑本地大模型那天基本没享受到它。
③ 上游限流 429 会被误判成"代理挂了"而无谓重启 → 加了故障分类:连不上才重启,上游错只告警。今晚 22:03 起它就一直在报上游 429,代理本身是健康的。
④ 日志被依赖库刷屏:一份 6900 行的日志里 1200 行是同一句重复输出,排查时很难受。
🛠 我现在怎么用
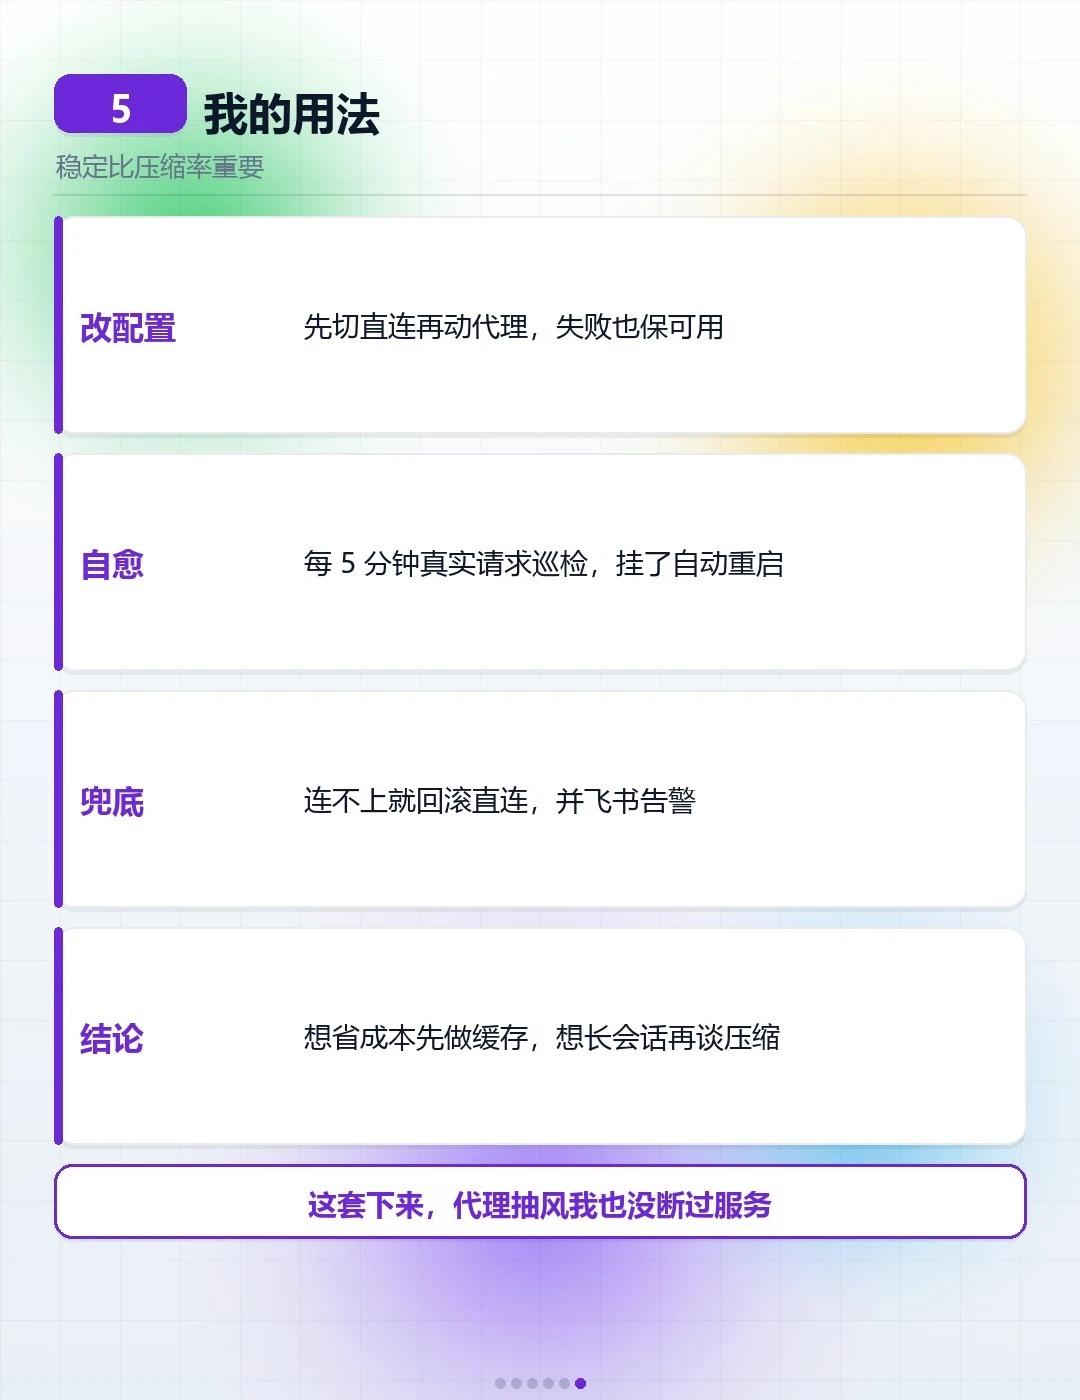
改配置一律走"先把主链路切直连、再动代理"的脚本,任何一步失败都停在"我还能正常用"的状态;再加每 5 分钟一次真实请求的巡检,挂了自动重启、连不上就回滚直连。这套下来,代理抽风我也没断过服务。
👌 一句话建议
上这类代理前先想清楚目的:要省成本,先把缓存命中做上去;要长会话,压缩才有用;要稳定,自愈和告警比压缩率重要得多。
人工智能 大模型 程序员 效率工具 开源项目 AI工具