从“交换芯片”到“AI协处理器”
统网络架构中,交换芯片的定位十分纯粹,本质只是承担数据包转发的 “纯管道” 角色。其核心任务聚焦两项基础能力: 数据转发与队列调度 。全程只负责机械完成数据搬运工作,将数据包从一个端口精准传输至另一个端口,不参与任何数据运算、业务处理,也不干预上层算力任务,所有和算力通信相关的计算压力,全部由GPU承担。
但随着AI大模型训练进入 超大规模算力集群时代 ,网络与算力的协作逻辑彻底重构,交换芯片也迎来了颠覆性的底层定位升级,彻底跳出了“纯转发”的传统局限。
简单来说,交换芯片的核心身份已经完成迭代: 从单纯的网络转发芯片,正式升级为AI训练专属协处理器 。
在大模型训练场景中,多GPU之间的集合通信是核心性能瓶颈之一。AllReduce、AllGather等高频集合通信操作,以往完全依赖GPU算力承载,大量宝贵的GPU算力被通信运算占用,真正用于模型训练、参数计算的资源被严重挤占,极大限制了整体训练效率。
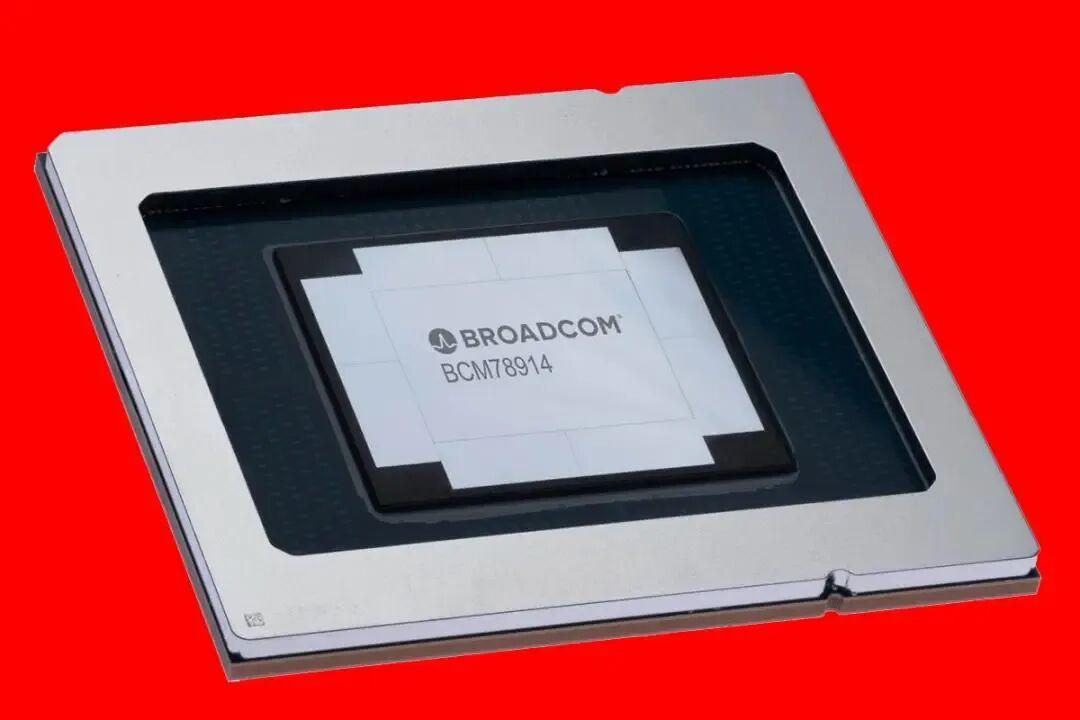
以 博通TH Ultra、TH7 为代表的新一代高端交换芯片,彻底解决了这一行业痛点,重塑了算力集群的分工模式。
相较于传统芯片,新一代芯片的核心突破在于 硬件级集合通信卸载能力 。芯片可直接在交换机内部完成Collective Communication(集合通信)运算,将原本由GPU承担的AllReduce等核心通信操作,从GPU端卸载至网络芯片端处理。
这一变革让GPU得以彻底摆脱繁杂的通信运算工作,专注于核心的AI模型训练计算,大幅释放高端GPU的闲置算力,有效降低多卡集群的通信延迟,提升大规模算力集群的训练稳定性与扩展性。
同时,博通TH7芯片将交换芯片的整机交换容量推向了 200T级别 ,超高带宽、超大吞吐能力,完美适配数千卡超大规模AI算力集群的高速互联需求,为大模型超长时间、高强度训练提供了稳定的网络底座支撑。
核心总结
1. 传统交换芯片:只做“搬运工”
纯数据传输管道,仅负责转发调度,无运算能力,所有集合通信计算均依赖GPU,是被动的网络传输工具。
2. 新一代AI交换芯片:变身“协处理器”
兼具高速数据转发与硬件通信运算能力,主动分担GPU通信压力,释放核心算力,成为AI算力集群中不可或缺的算力辅助单元。