vLLM 到底快在哪?我把源码翻了一遍
同样是跑大模型,为什么 vLLM 能把吞吐拉起来?
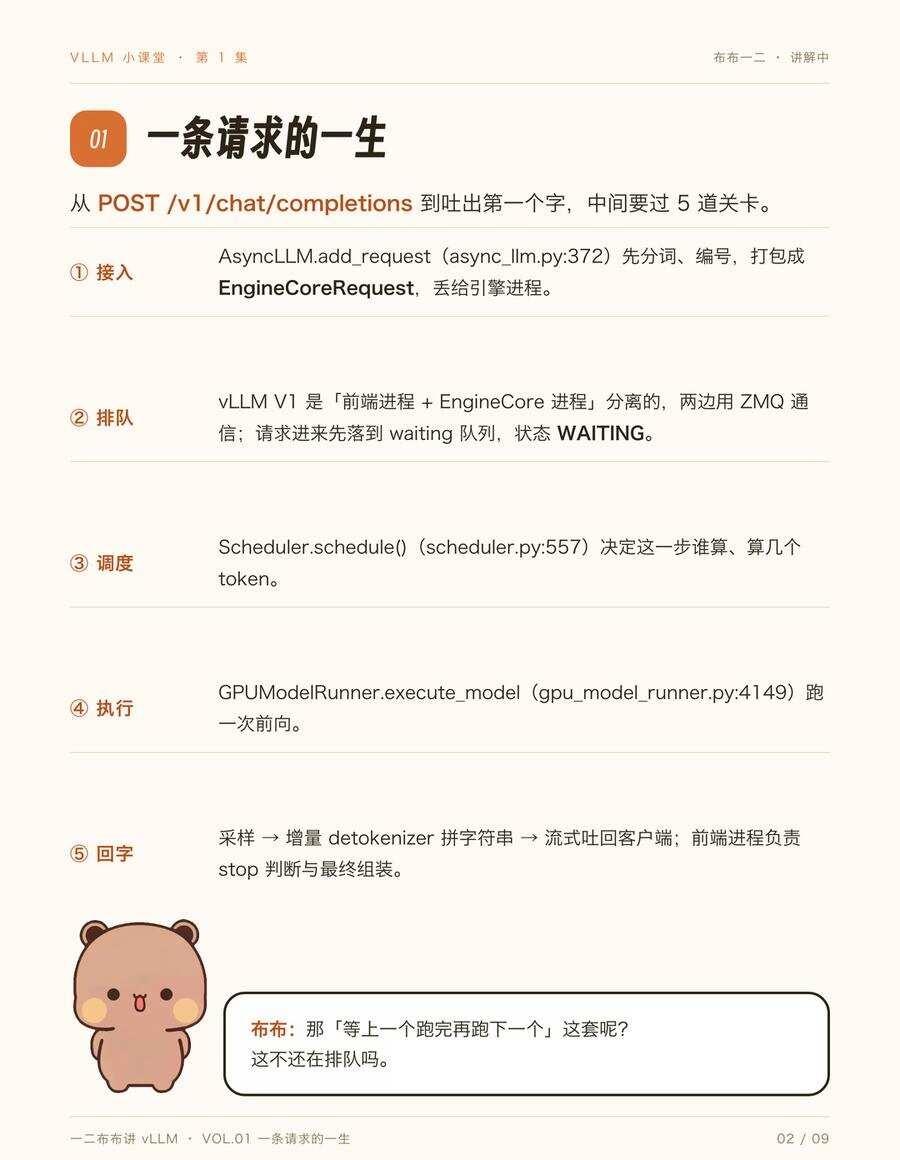
一二和布布把源码翻了一遍(commit a811738),拆成 9 张图逐章讲。
先说结论:它快的不是「算得更快」,而是「不浪费」——
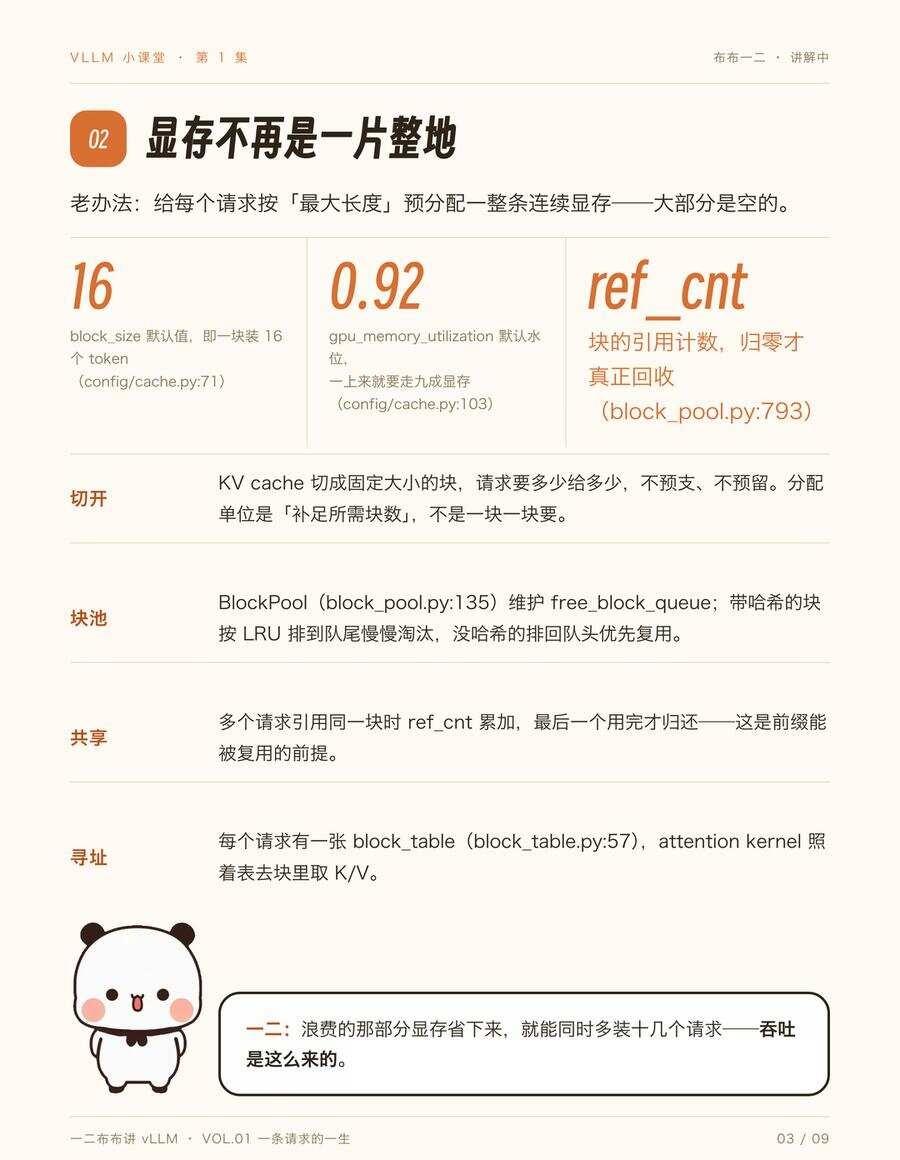
· 显存不再按最大长度预分配,切成 16 个 token 一块,用完的块还能被别人共享
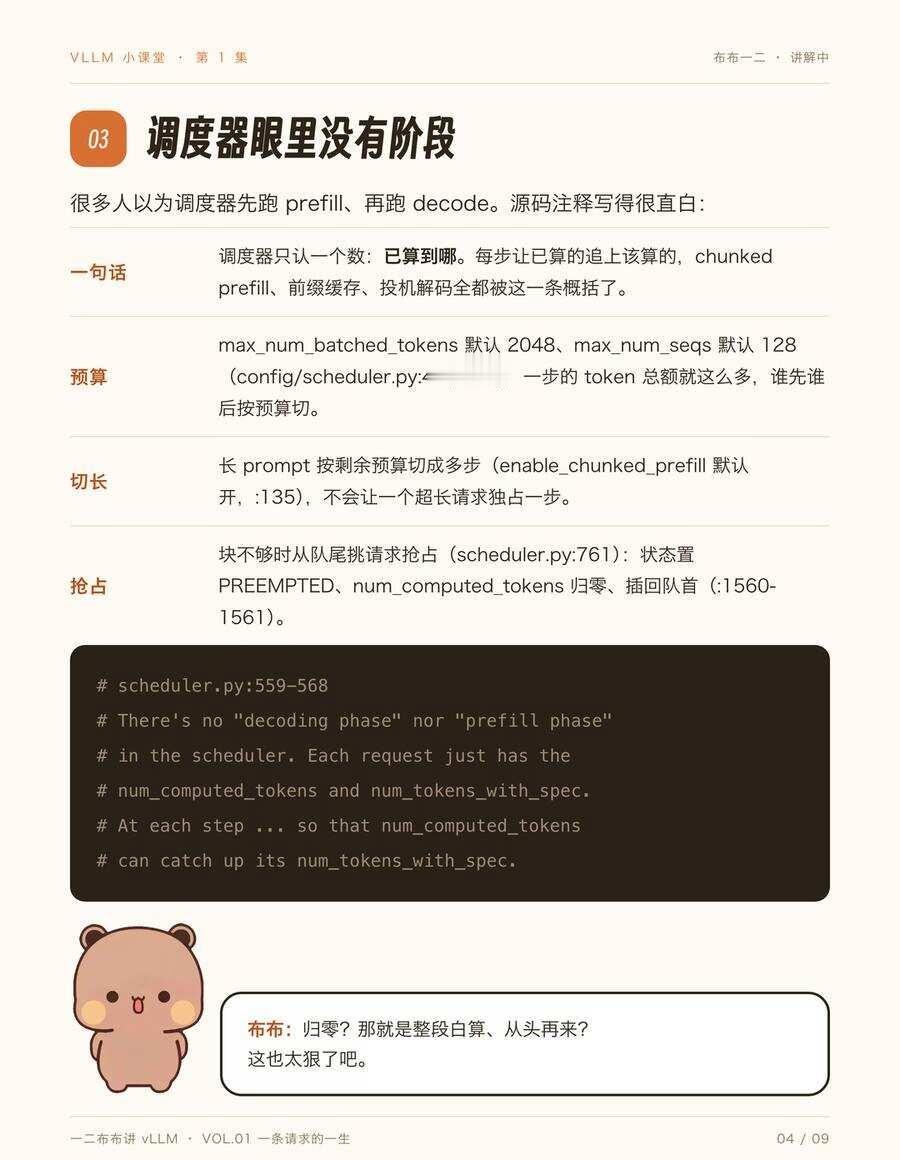
· 调度器眼里根本没有「prefill 阶段 / decode 阶段」之分,谁有缺口就补谁
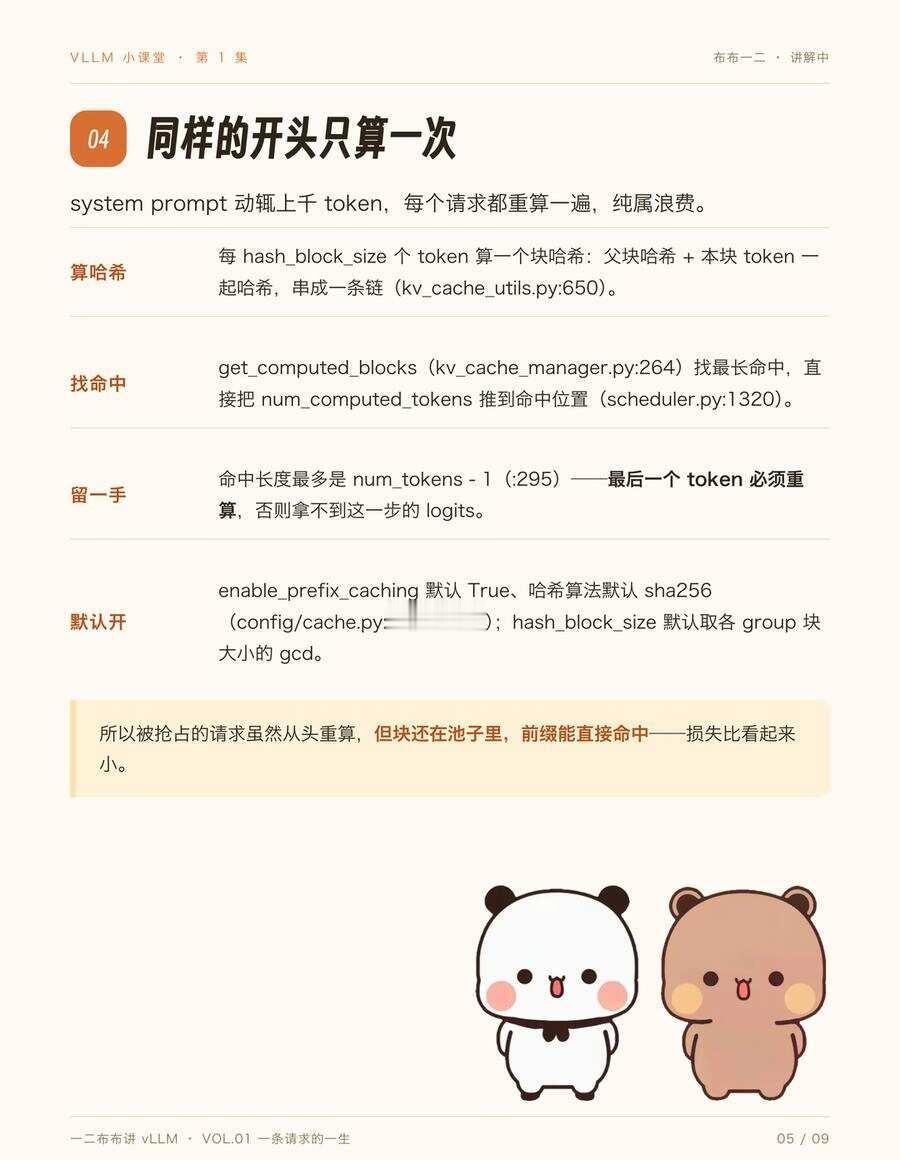
· 同样的 system prompt 只算一次,靠的是给每个 KV 块算哈希
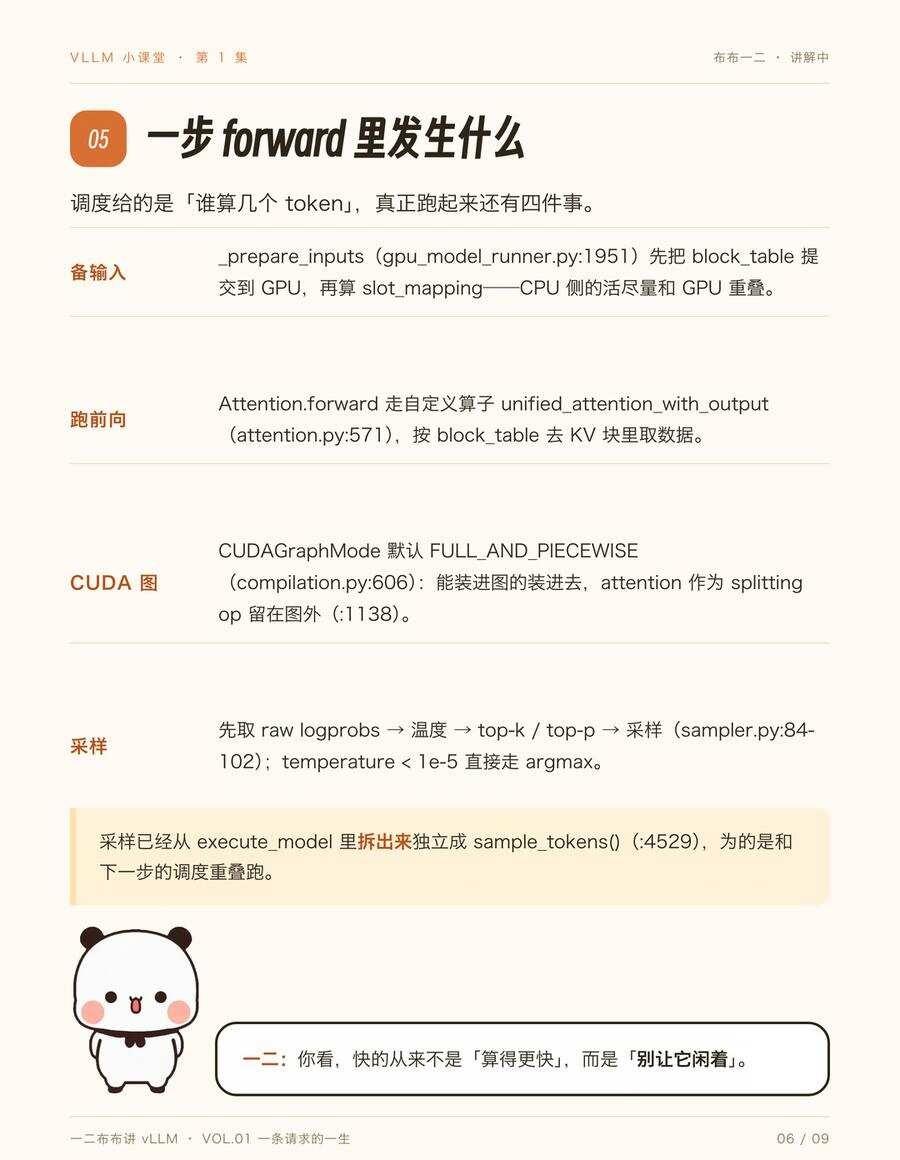
· 采样已经从 execute_model 里拆出来,跟下一步调度重叠着跑
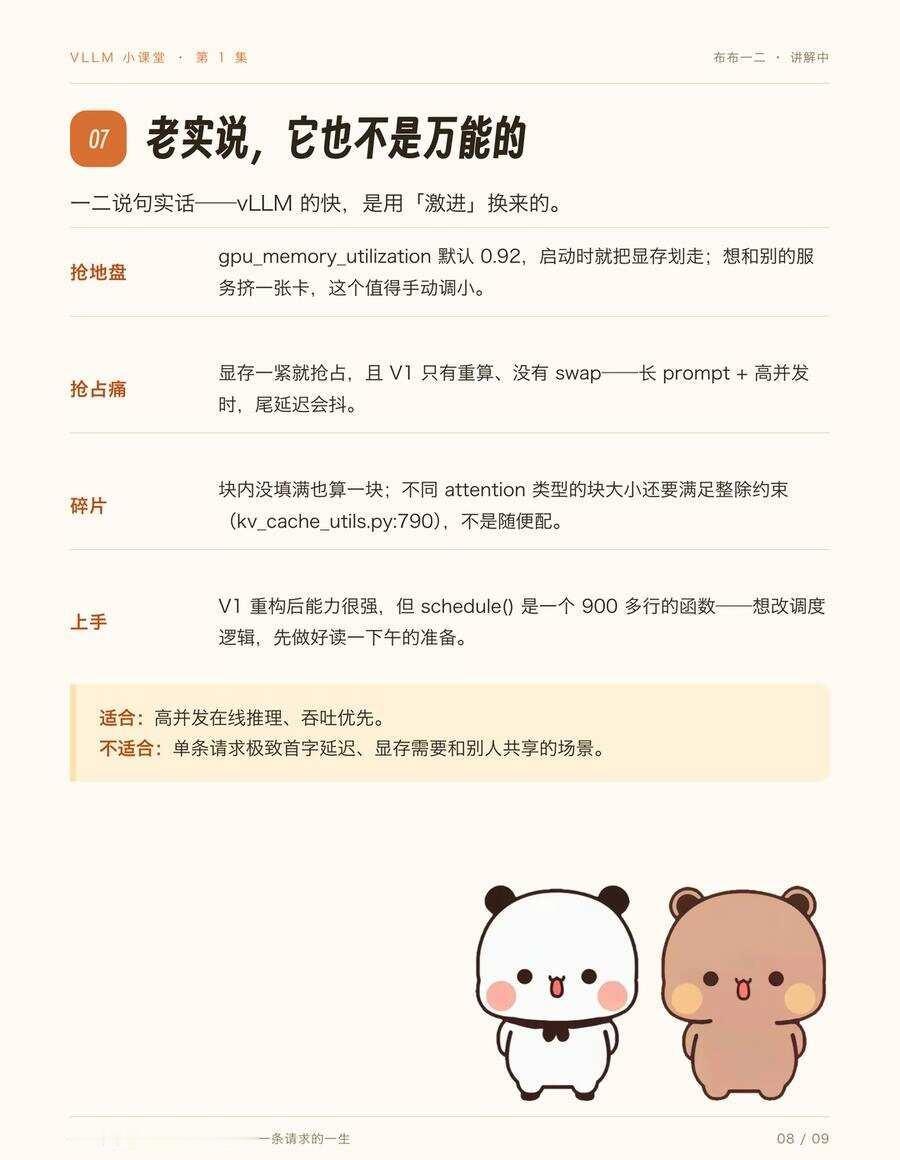
也别神化它:显存一紧就抢占,被抢占的请求是整段重算的;
gpu_memory_utilization 默认 0.92,跟别的服务挤一张卡要手动调小。
逐章导览:
01 封面
02 一条请求的一生
03 显存怎么分页
04 调度器在算什么
05 前缀缓存
06 一步 forward 里发生什么
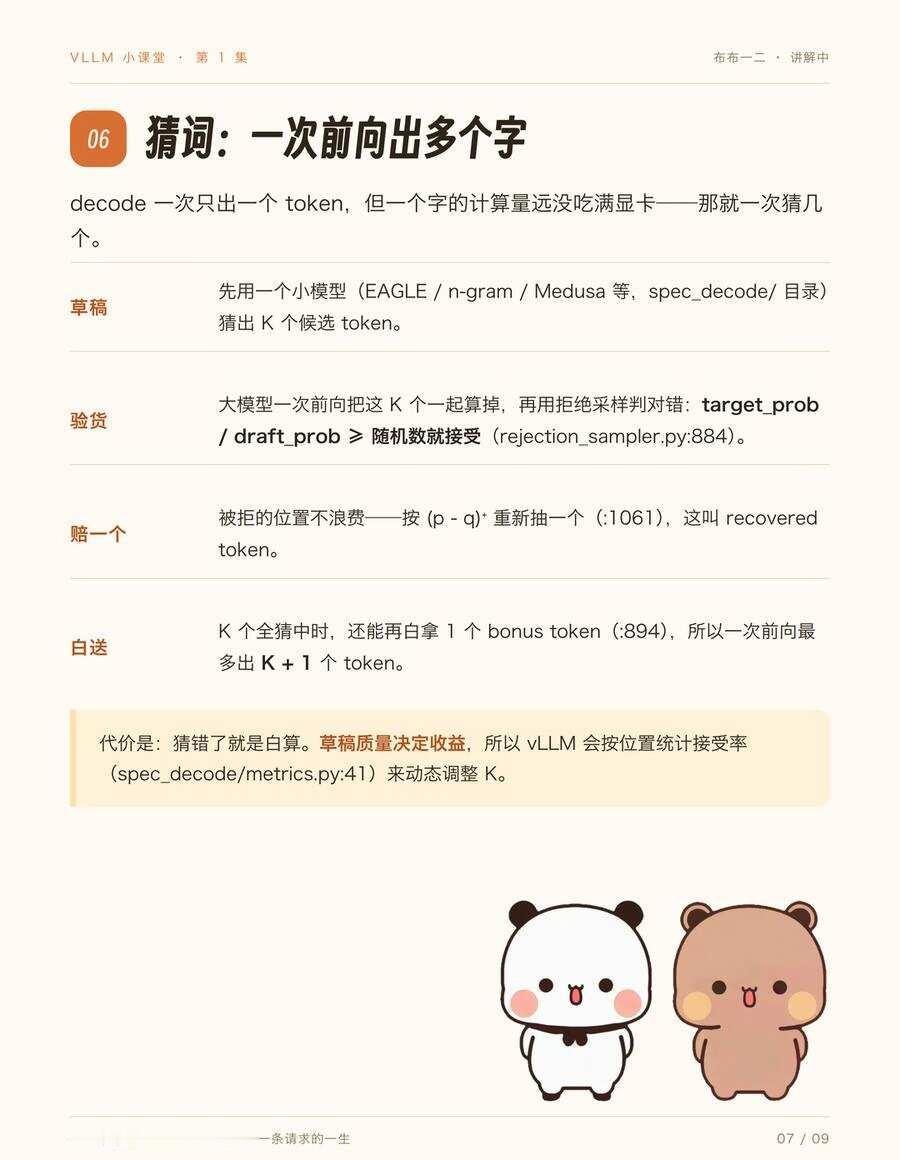
07 投机解码
08 代价与边界
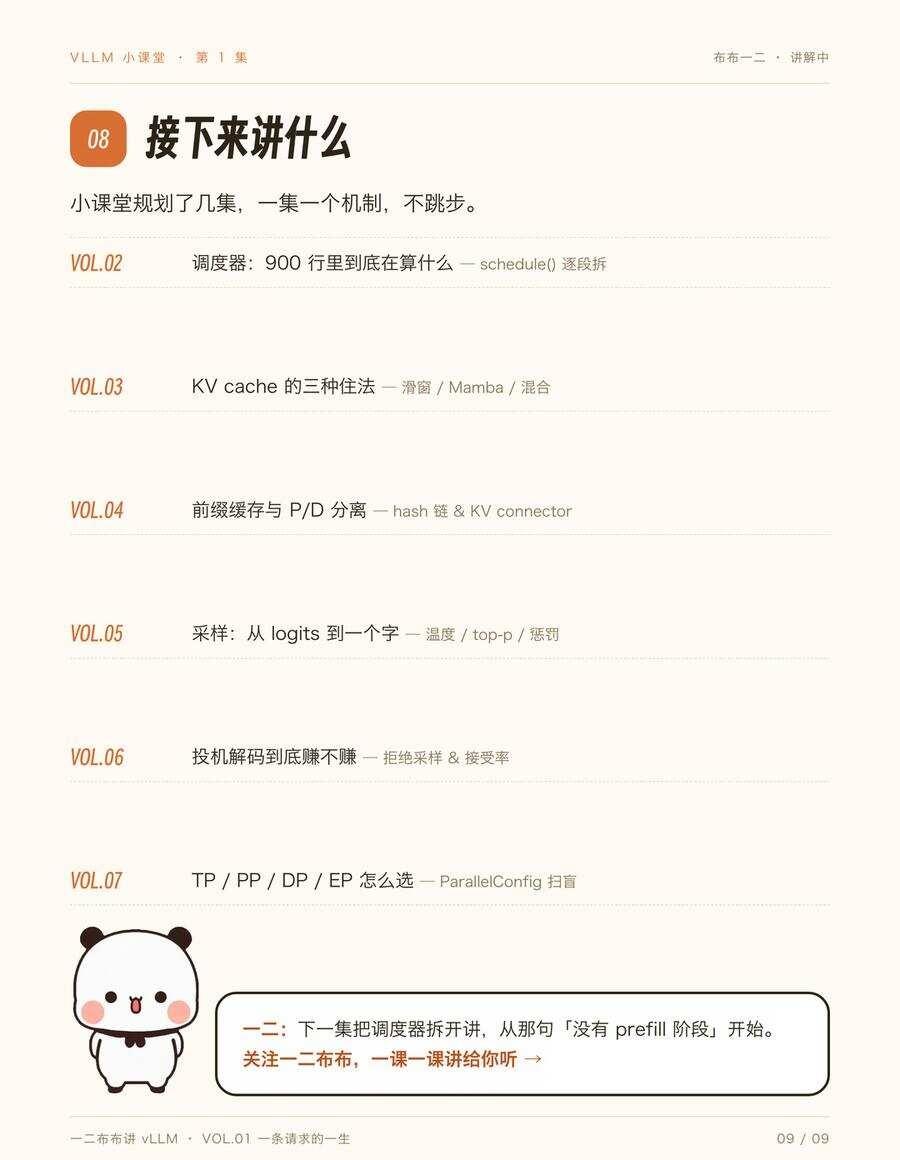
09 下集课表
下一集打算讲:调度器那 900 多行的 schedule() 到底在算什么。
想看的宝子点个关注,别走丢~
(9 张图,3 分钟能看完)
vLLM 大模型推理 AIInfra 后端开发 程序员 一二布布 布布一二 一二布布日常 深度学习