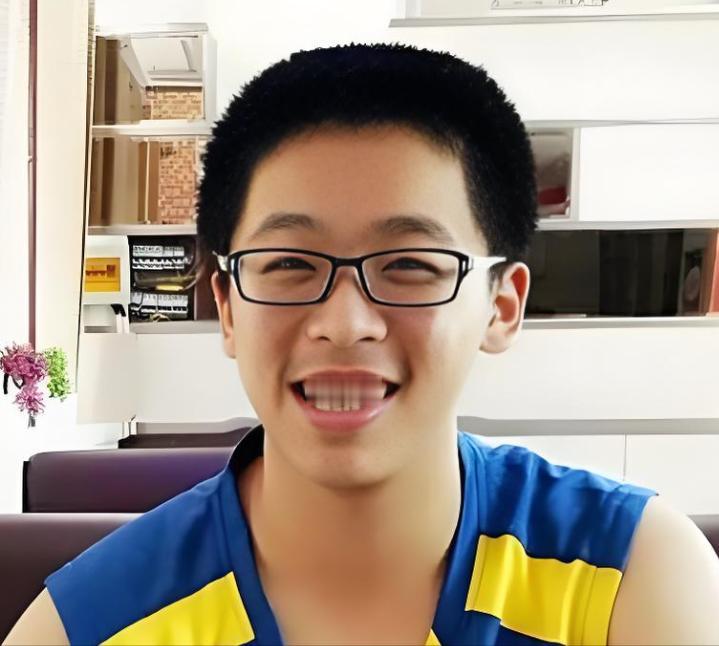
王炳宣,山东烟台高考理科状元,数学满分 150 分,从小由姥姥帮忙带大,北京大学超级学霸,2026年初从DeepSeek离职。
2017 年高考,他总分 703 分。数学 150,满分。理综 277,英语 144,语文 132。烟台市理科第一名,山东省前十。
这个分数在当年的山东意味着什么,经历过高考的人都懂。但比分数更值得说的,是他怎么走到那一步的。
王炳宣的妈妈杨海燕是小学老师,姥姥也是老师。他从小是姥姥帮忙带大的,上学前就认了很多字。姥姥带孩子的办法很简单,不逼着做题,先把读书的习惯养起来。
杨海燕说过一句话,炳宣从小就爱读书,但不会死读书,很注重实践。这句话后来在他身上应验了 —— 他没有变成一个只会考试的人。
他的学习习惯很特别。高中班主任张启评价他,连用了七个 “好”:学习好,人品好,为人处世好,对同学好,对老师好,对学校好。
这个评价放在一个高考状元身上,其实比分数更有说服力。
王炳宣自己的学习心得就一条:向课堂 45 分钟要效率。他从不上补习班,不搞题海战术。唯一坚持的习惯是错题本 —— 把每一道做错的题记下来,反复吃透,绝不放过任何一个不懂的知识点。
2017 年,他考入北京大学元培学院,方向是数据科学与人工智能。元培学院是北大最特殊的一个院,学生入学不分专业,先接受通识教育,再自己选择方向。能进这里的,都是各省拔尖的那一批。
他在北大从本科读到硕士,硕士论文题目叫《多模态大模型中视觉编码器的融合与优化研究》。2024 年 5 月通过答辩。
这个论文方向,恰好踩在了 AI 最核心的赛道上。
毕业后,他加入了 DeepSeek。这家公司 2023 年 7 月才成立,创始人梁文锋是做量化私募出身的。2025 年 1 月,DeepSeek 发布推理大模型 R1,一夜之间震动全球科技圈。英伟达、亚马逊、微软在同一天宣布接入。
王炳宣是 DeepSeek 第一代大语言模型的核心作者,参与了从 LLM v1 开始的一系列重要工作。
他在 DeepSeek 的那段时间,恰好赶上这家公司从默默无闻到全球焦点的全过程。然后,2026 年初,他走了。去了腾讯混元团队。这件事放在普通人身上,不过是一次正常的跳槽。但放在王炳宣身上,放在 DeepSeek 这家公司身上,味道完全不一样。
他不是第一个走的。
2026 年 4 月,DeepSeek 发布 V4 技术报告,近 300 人的作者名单里,10 个人被标注 “已离职”。王炳宣是其中之一。
同期离开的还有谁。V2 核心贡献者罗福莉,被雷军以千万年薪挖到小米。R1 核心研究员郭达雅,传闻以近亿元总包入职字节跳动 Seed 团队,职级 L8。多模态技术核心研究员阮翀,去了自动驾驶公司元戎启行。OCR 系列核心作者魏浩然,后续确认入职百度。
这五个人,覆盖了基座模型、推理、多模态、OCR 四条核心技术线,四条线,走了四个人。
DeepSeek V4 技术报告近 300 人全员平等署名,延续学术传统,彰显团队坚守,但 10 名核心人员的离职标注,暴露了这家硬核 AI 初创公司的人才流失问题。
当前 AI 人才市场竞争白热化,DeepSeek、月之暗面等头部初创团队的技术人员,是腾讯等大厂争抢的优质人才。
2026 年顶尖 AI 人才薪资水涨船高,名校计算机博士应届生优质岗位年薪可达 300 万至 500 万,顶尖人才超 700 万,大厂核心博士实习生日薪高达五六千元,高薪优势远超初创企业。
DeepSeek 由幻方量化孵化,早期无外部融资,员工期权无市场估值、兑现难度极大,相较于大厂可落地的现金、股票薪资体系,吸引力悬殊。尽管其 V4 研发期间团队留存率超 96%,整体人员稳定性尚可,但离职人员均是各技术线核心骨干。
初代大语言模型核心作者王炳宣便是典型代表,他参与打造的初代模型,是 DeepSeek 后续全系模型迭代的技术根基。
如今他跳槽至腾讯混元团队,而腾讯近年持续大举吸纳海内外顶尖 AI 人才,深耕基座模型研发。大厂看重的不仅是个人技术能力,更是核心研发人员积累的专业技术判断力。
出身烟台、考入北大的王炳宣的职业变动,是顶尖 AI 人才双向选择的缩影。DeepSeek 自研能力突出,打造出世界级 AI 产品,但企业体量有限,难以依靠薪资与股权激励留住所有核心人才。
国内 AI 行业人才缺口庞大,核心岗位缺口超 80 万。人才竞争下,仅靠情怀难留顶尖人才,核心员工离职是行业红利下追求更高回报与发展空间的理性选择。
参考信息:李京兰. (2025, 2 月 8). DeepSeek 核心研究员之一,有个烟台小伙!烟海 e 家(烟台市融媒体中心).