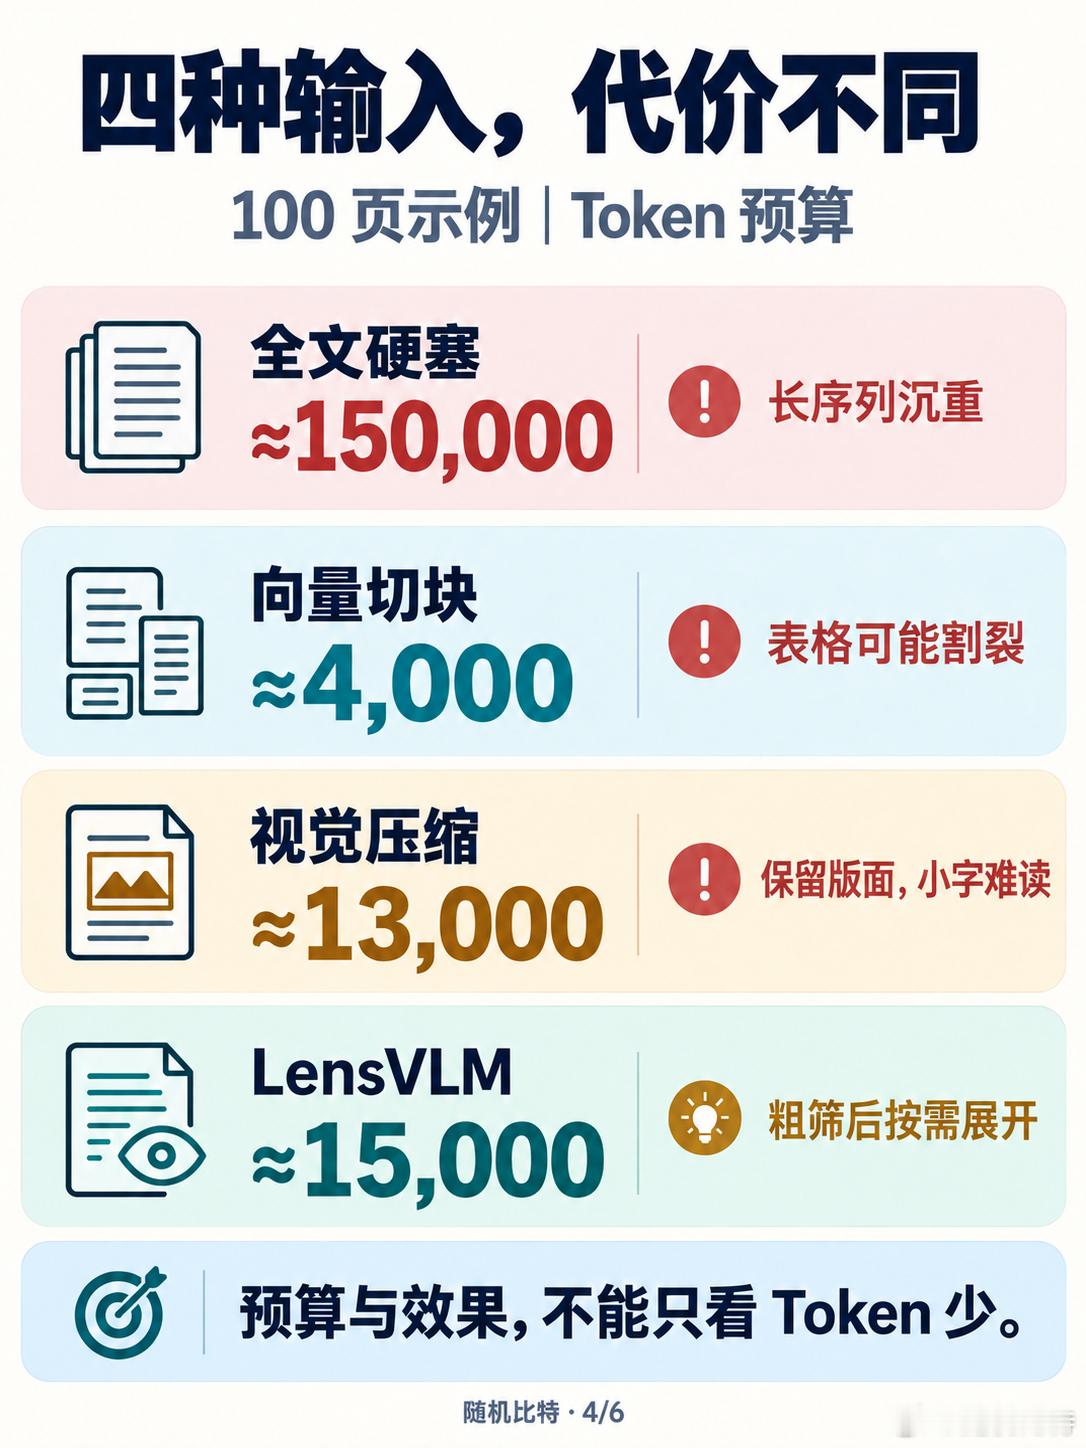
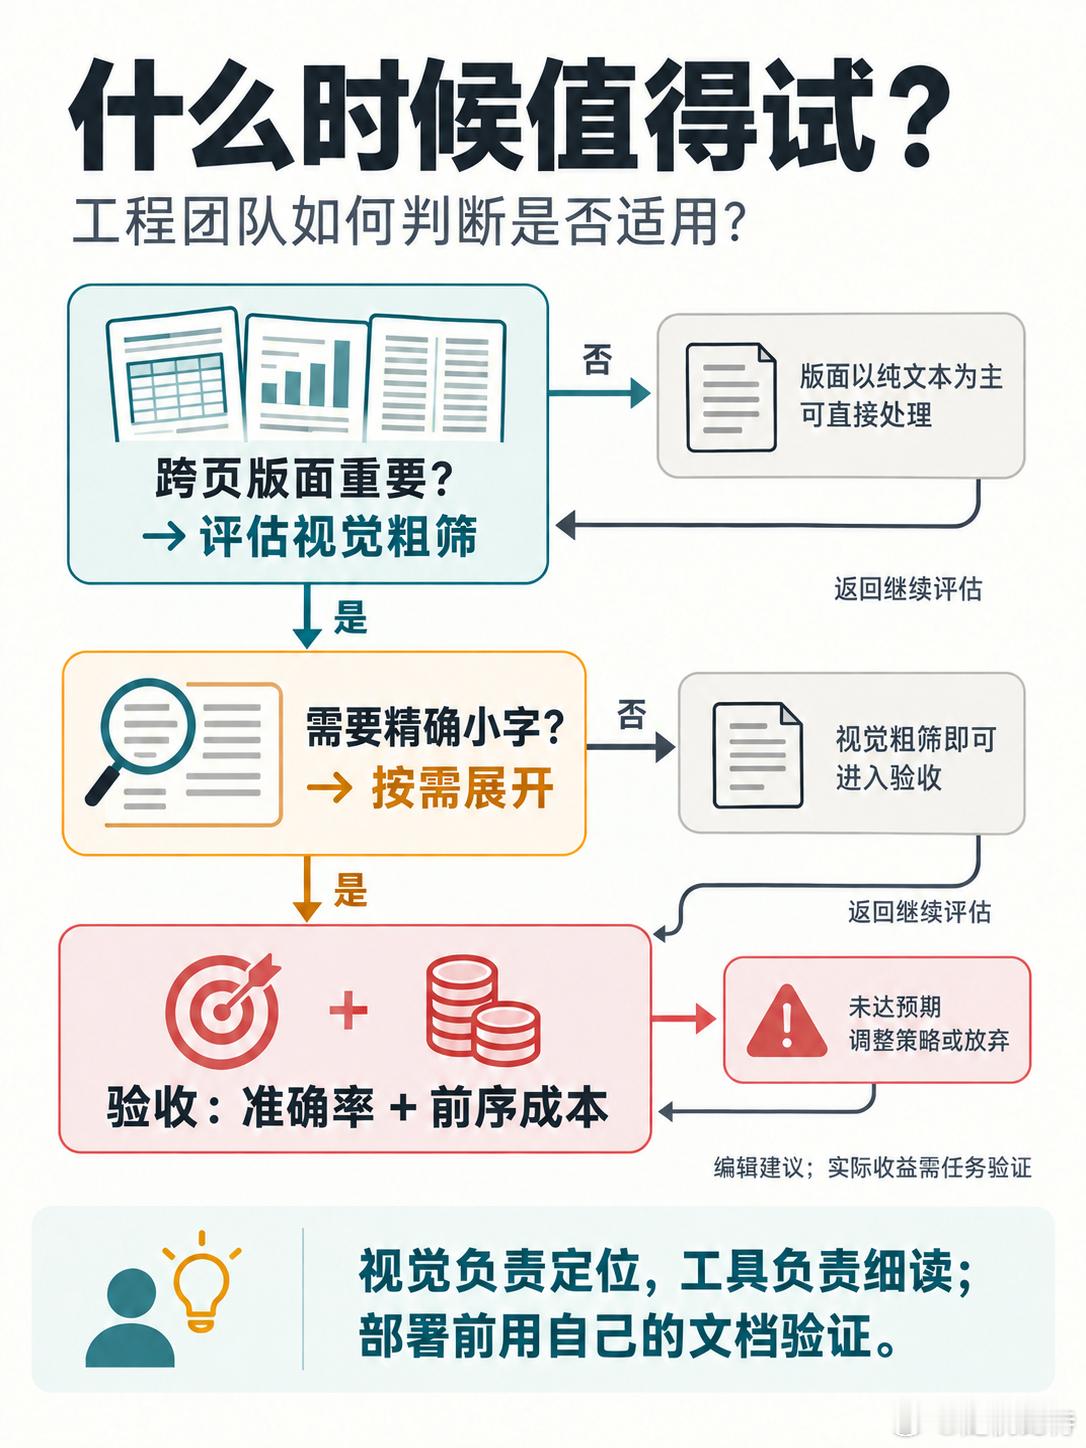
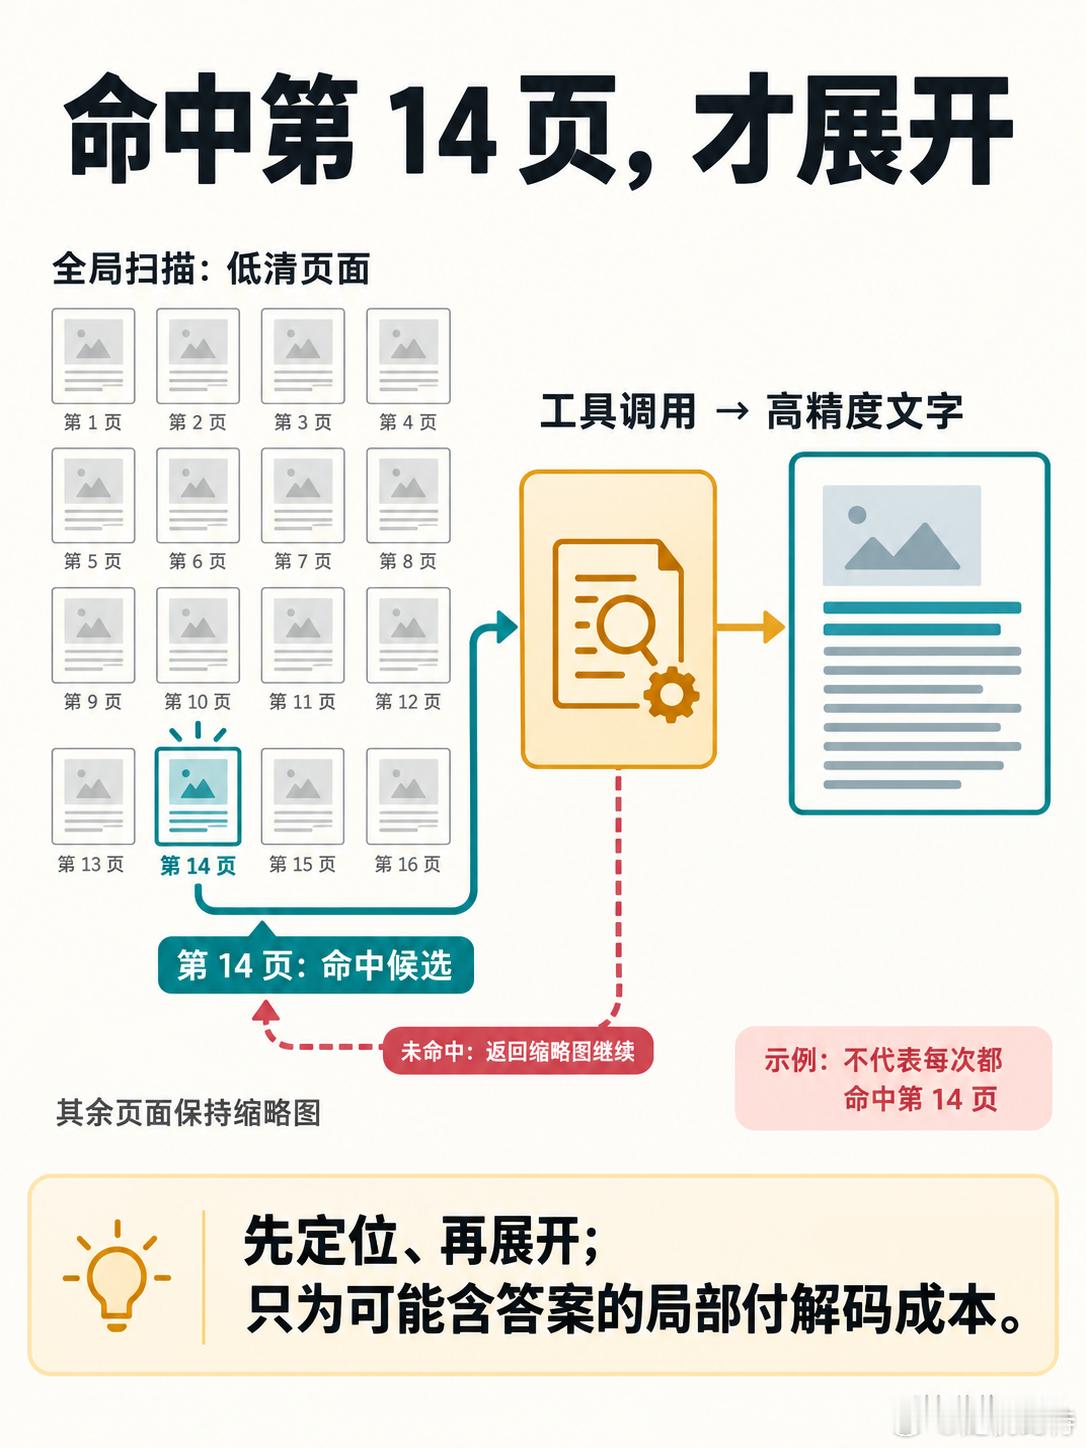
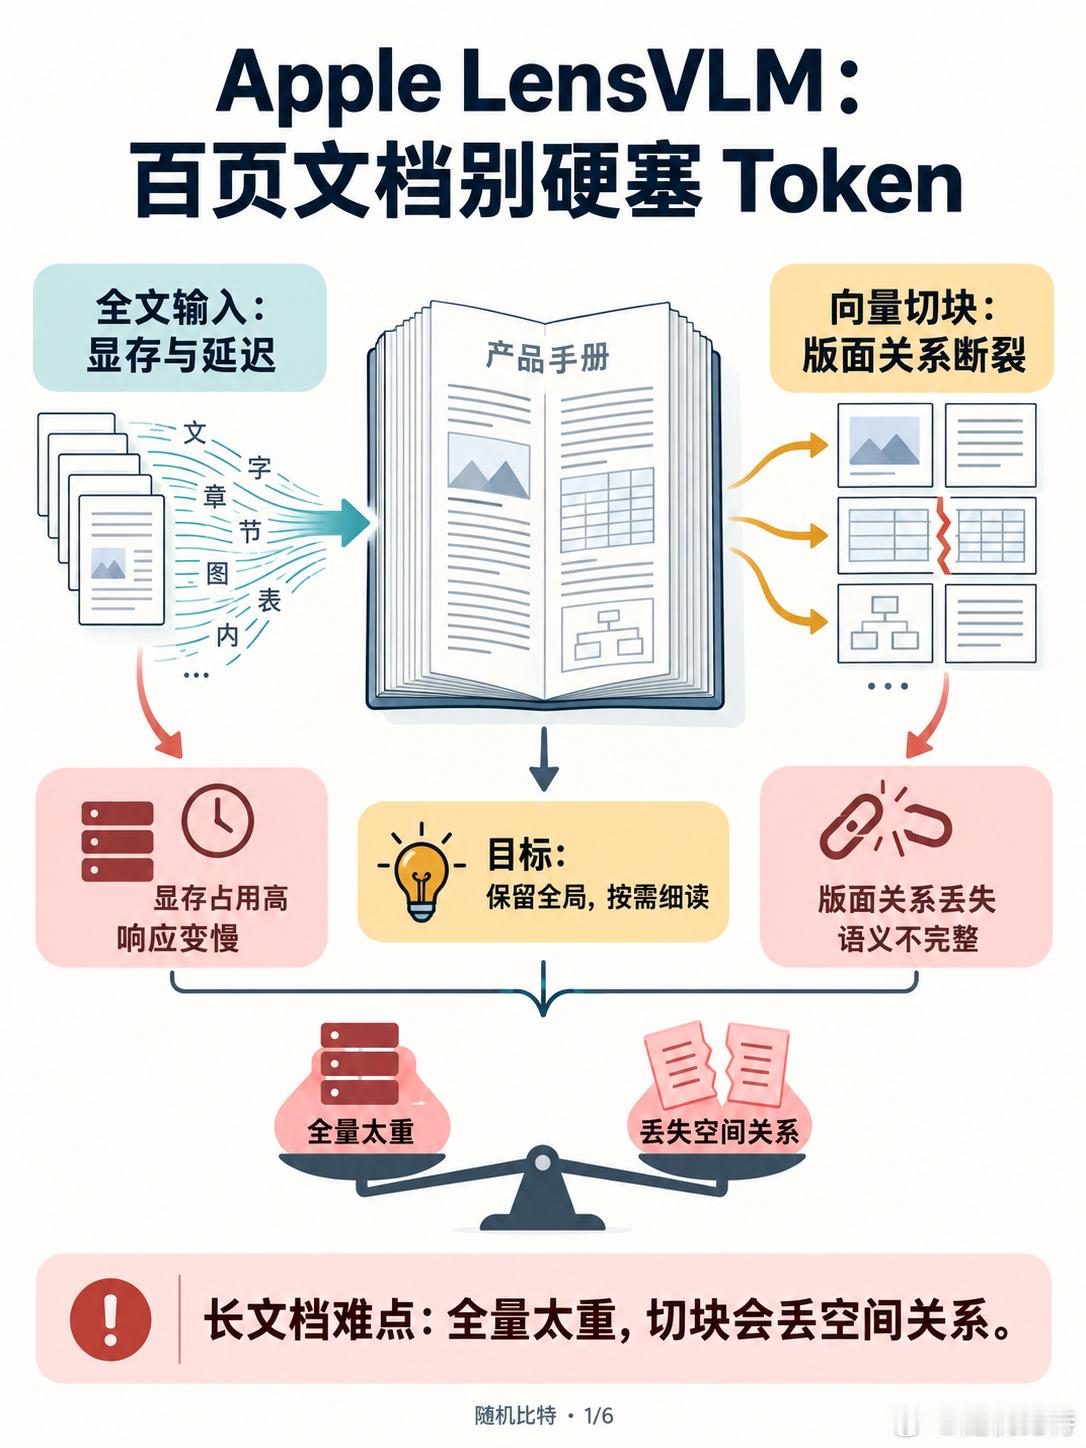
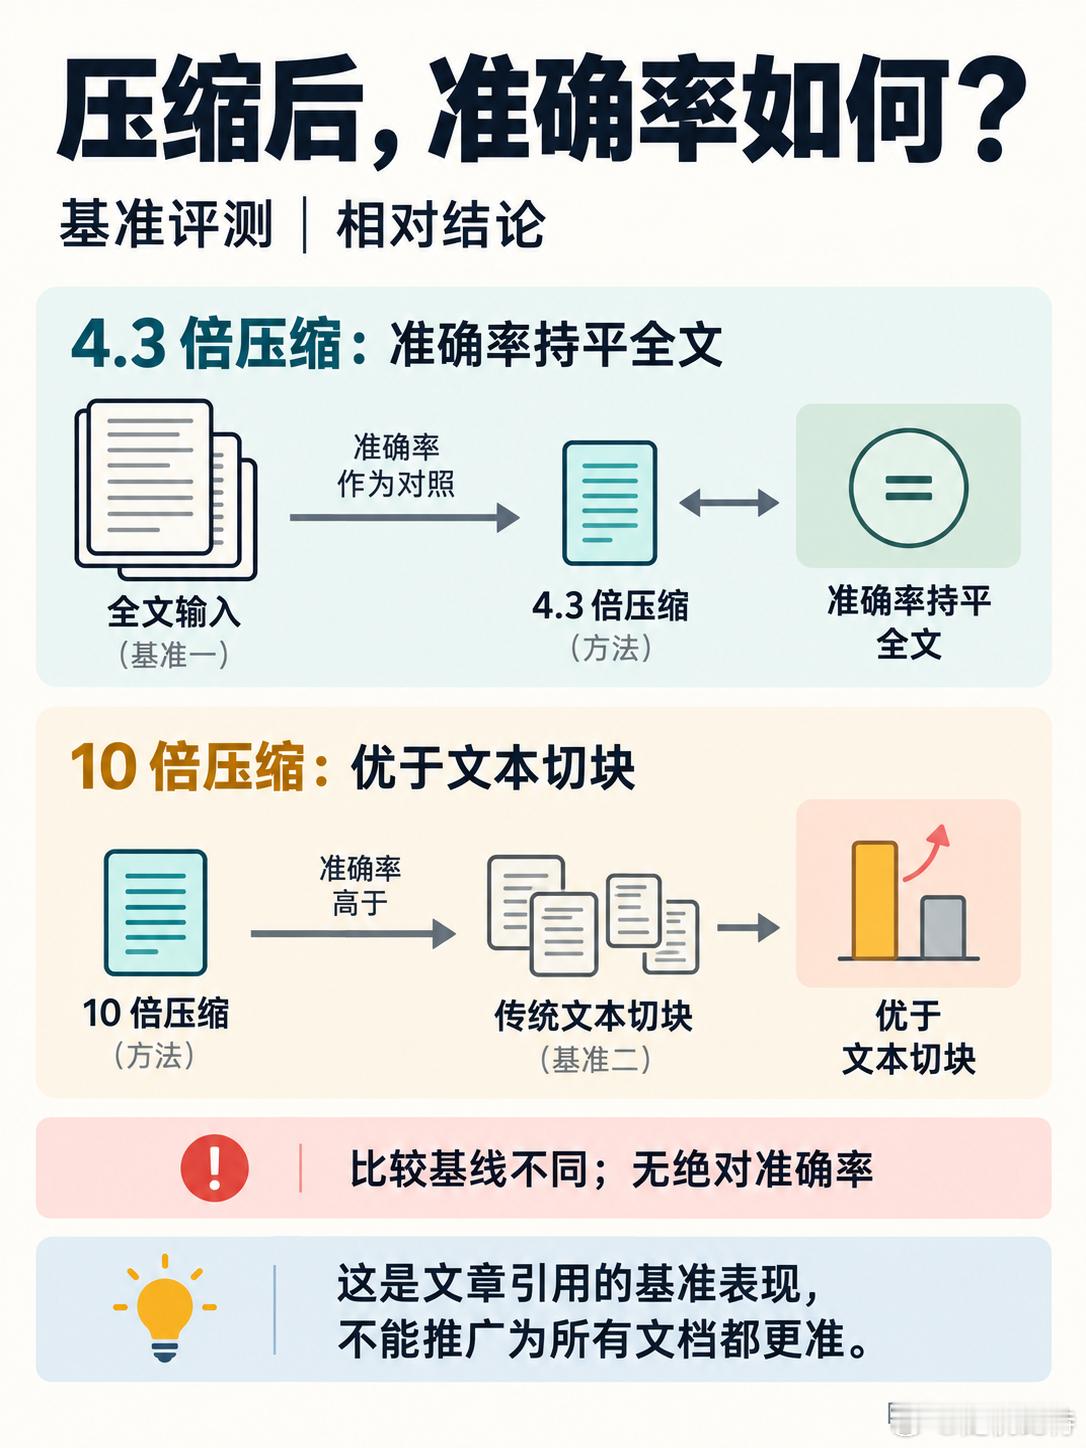
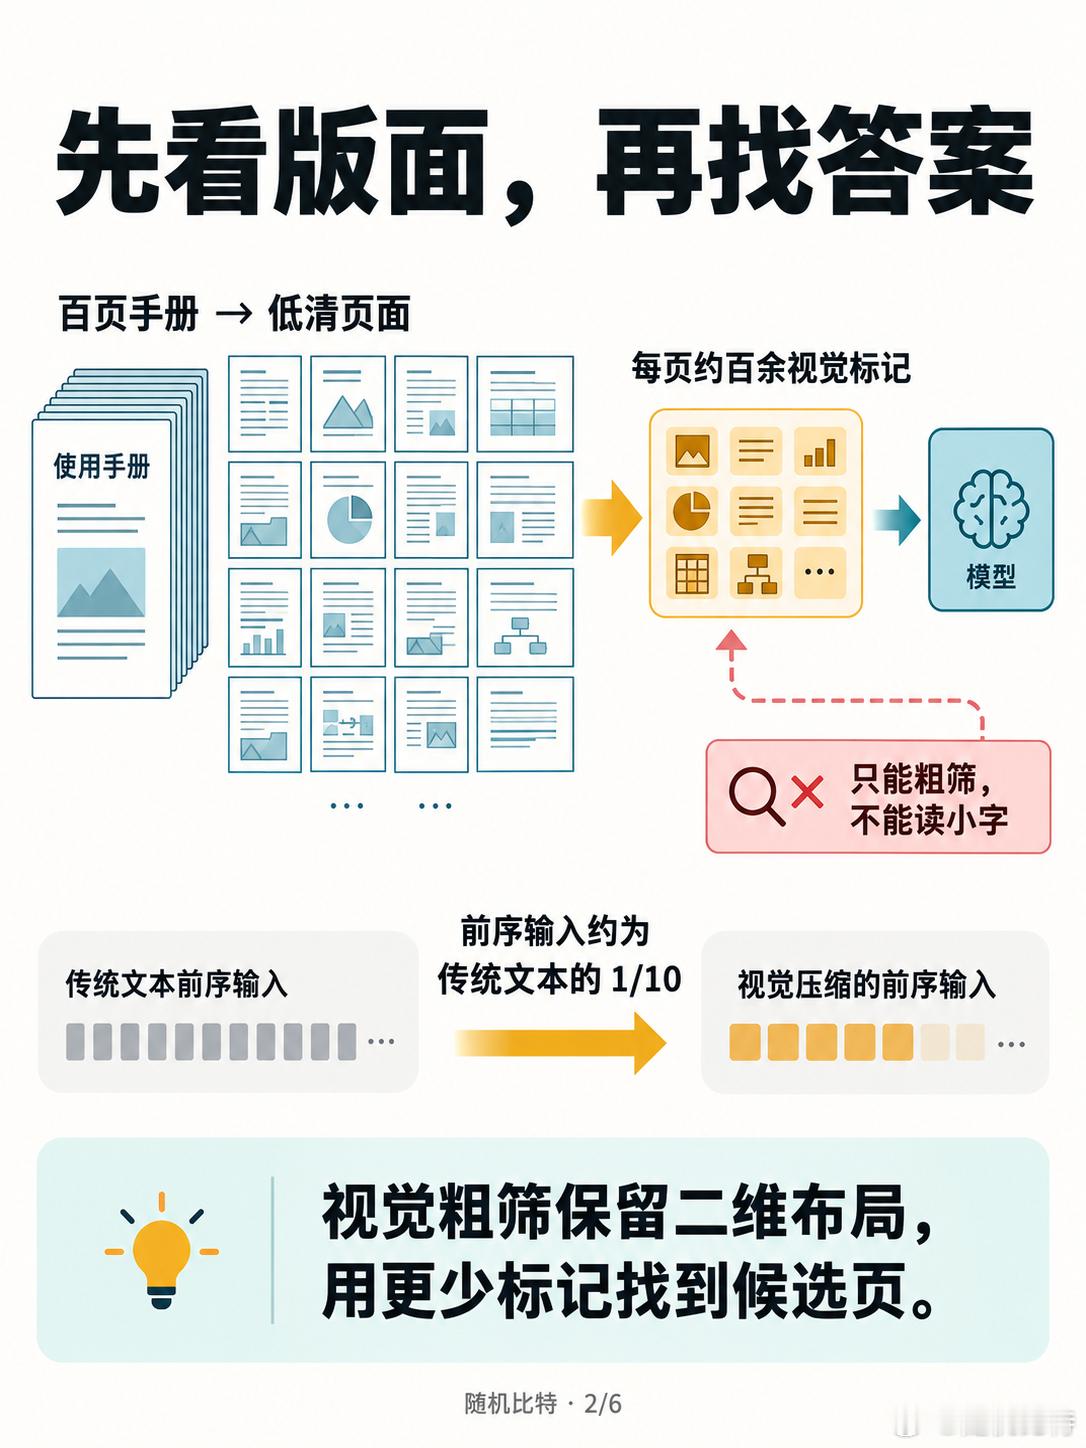
一份百页技术手册,全文硬塞模型会拉高长序列计算和显存负担;向量切块虽然省输入,却可能把跨页表格、架构图的空间关系切断。Apple LensVLM 的思路是先把页面渲染成低清图像,让模型看版面、找候选页,再用工具只展开需要精读的高精度文字。文章给出的百页示例中,视觉压缩与粗筛加展开的 Token 预算约为 1.3 万和 1.5 万;这不能只当作“数字越小越好”,因为缩略图读不了小字。引用的基准评测也要分清对象:4.3 倍有效压缩时准确率持平全文输入;10 倍压缩工况下优于传统文本切块基线。真正值得工程团队检验的是:自己的文档是否依赖表格和排版、是否必须精读局部小字,以及准确率与前序成本能否同时达标。六张图依次讲清问题、机制、预算、评测与适用边界。