Sonnet 5.5 省钱,但别开满档。
Anthropic 9 月 28 日发布的这款中档模型,官方主打两句话,每个任务最多便宜 30%,终端编程榜反超自家旗舰 Opus 5.5。两句都是真的,只是出自两个不同的档位,一次调用拿不到两样。
用 Claude 应用的,放心用。 默认开在 Medium 档,官方的终端编程测试里,这一档花不到上一代十分之一的钱,成绩远超上一代的最好水平。
想要“反超 Opus”的成绩,得开到最高档。 第三方实测,这一档每个任务比上一代贵一半左右。
用 API 的团队,先挑档位再换模型。 Low、Medium 够用的活,别往上开。
档位决定账单
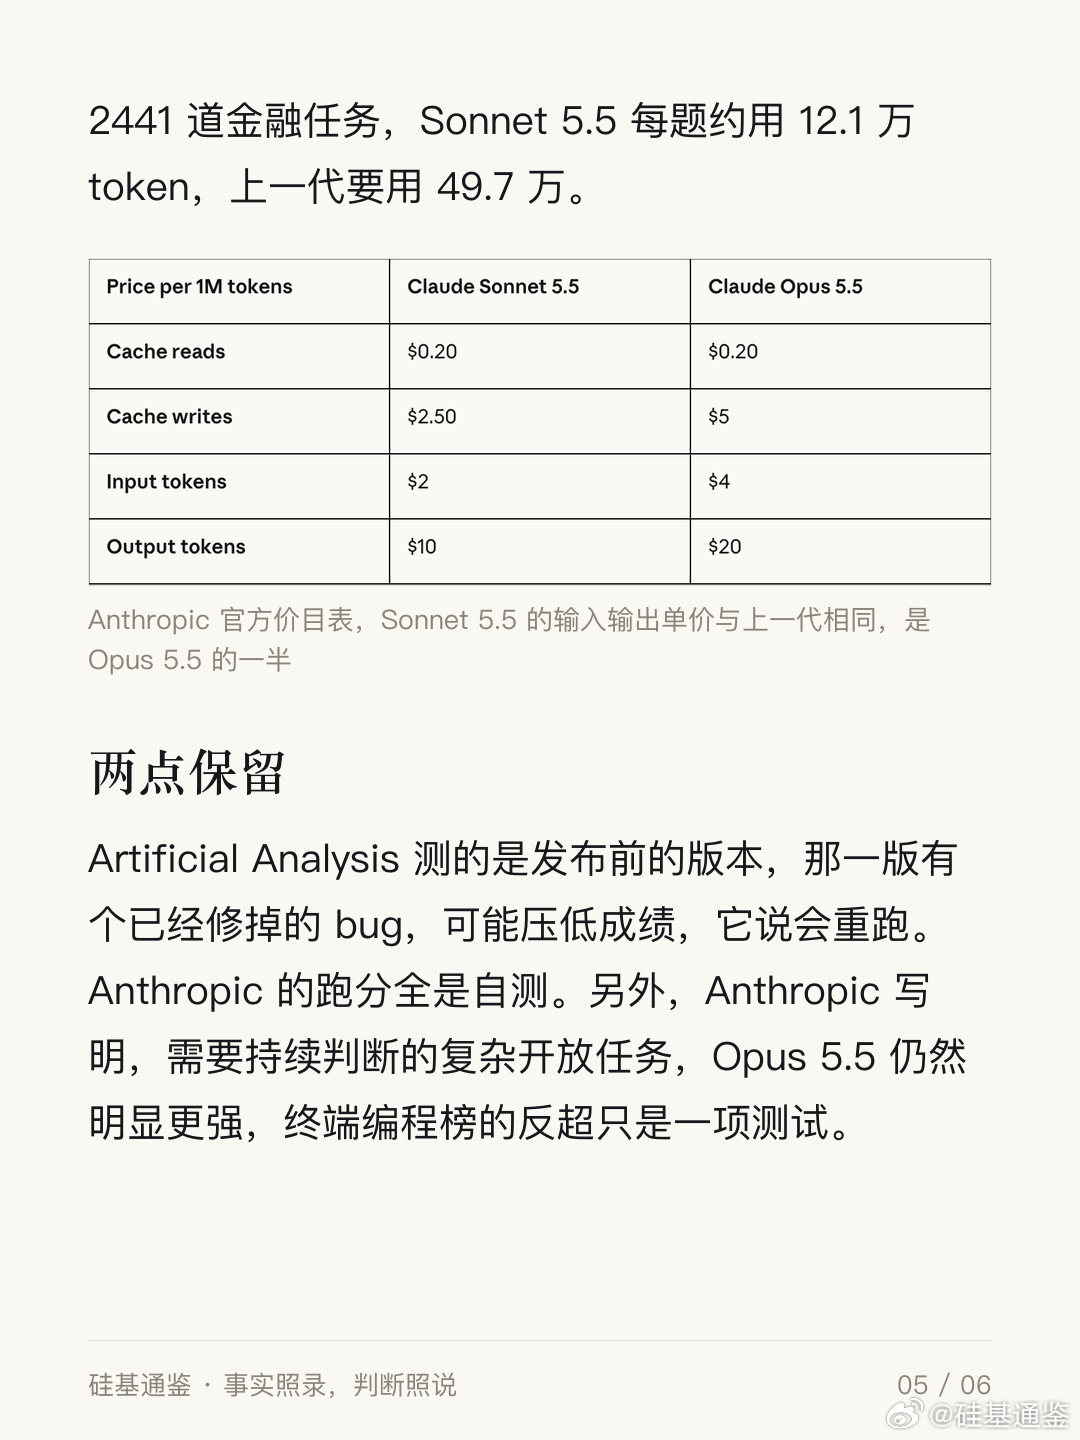
Claude 5.5 这一代,每次调用都能选档位,从 Low 到 Max 一共五档。档位越高,模型想得越久,回头检查得越多,吐出来的 token 越多。单价是固定的,输入每百万 token 2 美元,输出 10 美元,跟上一代一样,花多少钱全看它吐了多少 token。
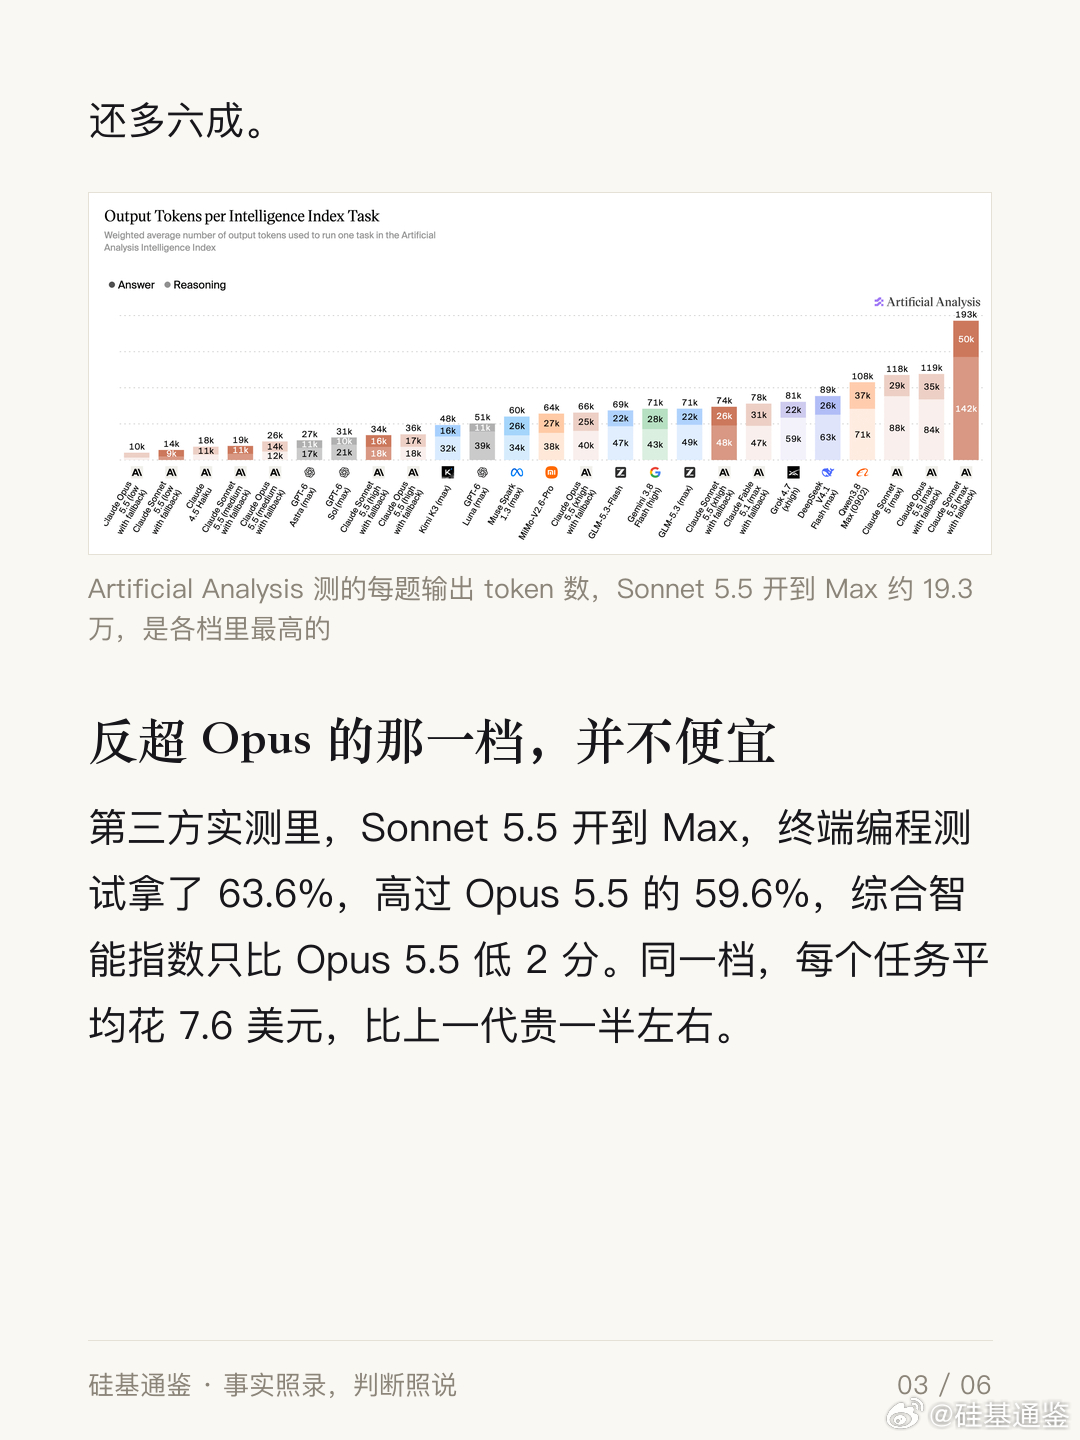
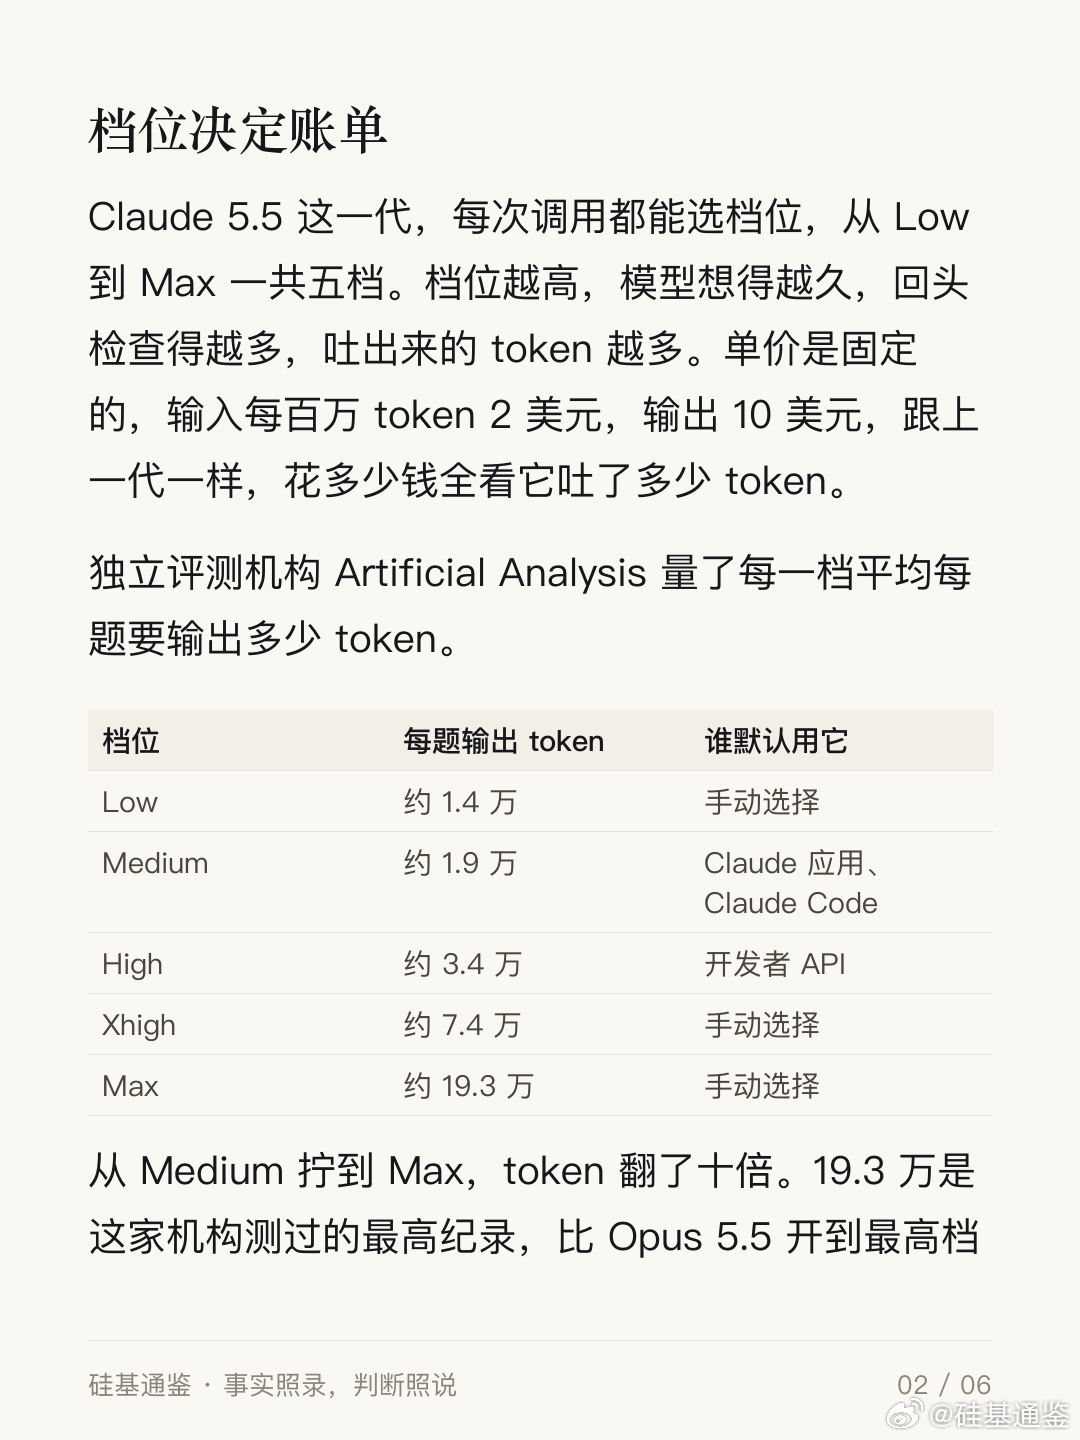
独立评测机构 Artificial Analysis 量了每一档平均每题要输出多少 token。
档位 每题输出 token 谁默认用它Low 约 1.4 万 手动选择Medium 约 1.9 万 Claude 应用、Claude CodeHigh 约 3.4 万 开发者 APIXhigh 约 7.4 万 手动选择Max 约 19.3 万 手动选择
从 Medium 拧到 Max,token 翻了十倍。19.3 万是这家机构测过的最高纪录,比 Opus 5.5 开到最高档还多六成。
反超 Opus 的那一档,并不便宜
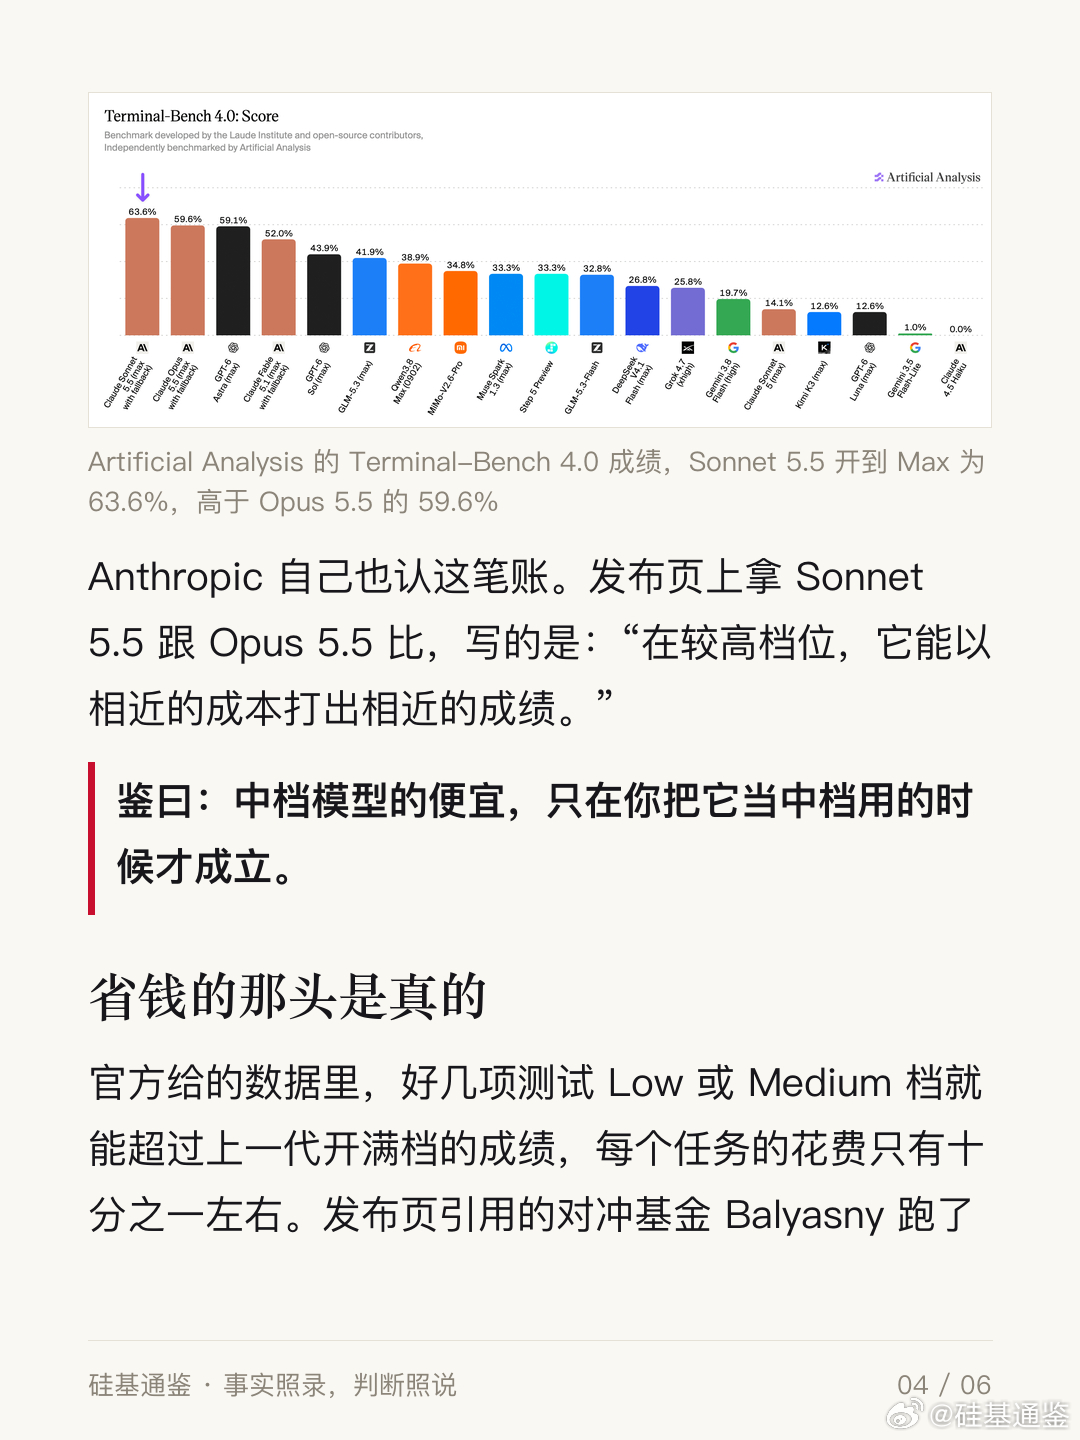
第三方实测里,Sonnet 5.5 开到 Max,终端编程测试拿了 63.6%,高过 Opus 5.5 的 59.6%,综合智能指数只比 Opus 5.5 低 2 分。同一档,每个任务平均花 7.6 美元,比上一代贵一半左右。
Anthropic 自己也认这笔账。发布页上拿 Sonnet 5.5 跟 Opus 5.5 比,写的是:“在较高档位,它能以相近的成本打出相近的成绩。”
鉴曰:中档模型的便宜,只在你把它当中档用的时候才成立。
省钱的那头是真的
官方给的数据里,好几项测试 Low 或 Medium 档就能超过上一代开满档的成绩,每个任务的花费只有十分之一左右。发布页引用的对冲基金 Balyasny 跑了 2441 道金融任务,Sonnet 5.5 每题约用 12.1 万 token,上一代要用 49.7 万。
两点保留
Artificial Analysis 测的是发布前的版本,那一版有个已经修掉的 bug,可能压低成绩,它说会重跑。Anthropic 的跑分全是自测。另外,Anthropic 写明,需要持续判断的复杂开放任务,Opus 5.5 仍然明显更强,终端编程榜的反超只是一项测试。
API 团队怎么挑
拿自己的真实任务,在 Low、Medium、High 各跑一轮,记下每档做成几件、花多少钱,挑最低的那个够用的档。非得开到最高档才过关的活,拿去跟 Opus 5.5 比一比账单,未必更贵。
鉴曰:以后看模型发布,先问一句,这个分数开的是哪一档。