一套通吃!曙光8000把算力利用率拉满
二刷央视《超级工程》曙光8000,从我这个算法工程师的角度看,解西国那段真的太有共鸣了。外行堆芯片数量,内行看架构能不能把算力拧成一股绳。
一个项目里,高精度数值仿真、模型训练、推理验证经常要接着做。如果分别放在不同集群,搬数据、配环境、等资源,每一步都可能打断节奏。单项计算再快,也架不住整个流程来回折腾。
曙光8000最牛的就是这套异构加算架构,从FP64双精度科学计算,到FP8/INT8低精度AI训练,全精度全覆盖,标量、向量、张量通吃。是真正做到层次化异构并行设计,一套系统同时搞定。
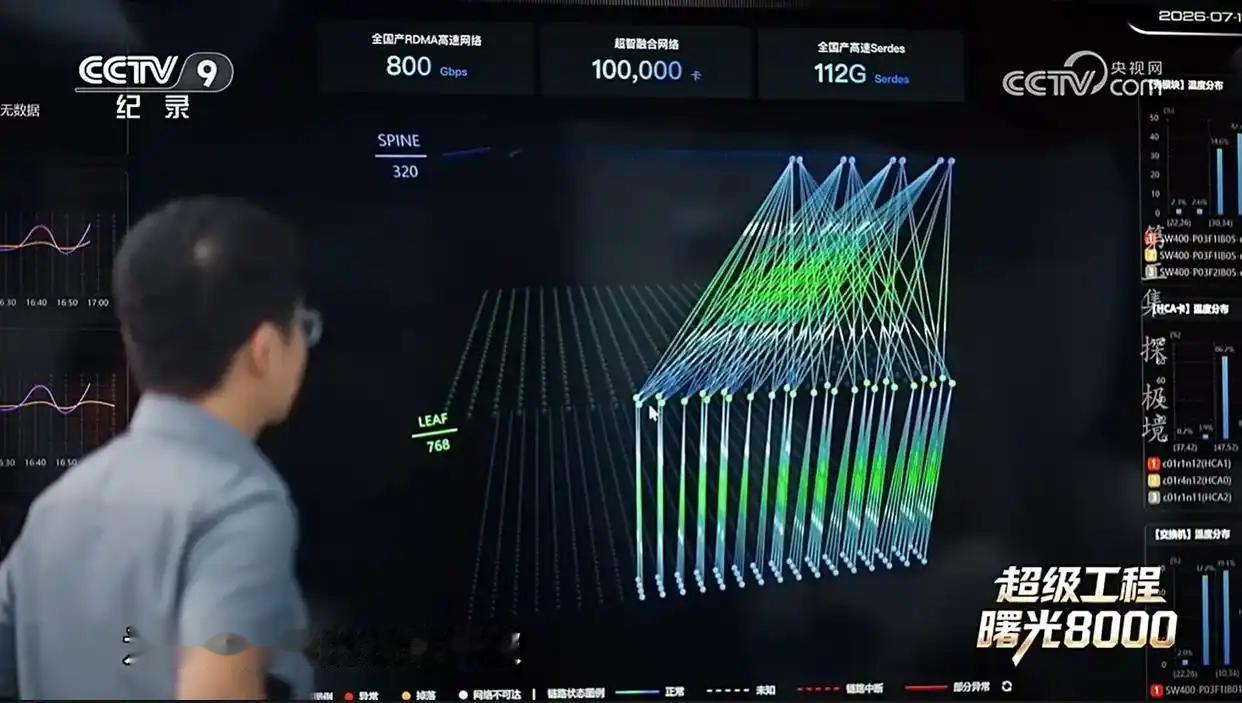
再加上存算网协同优化,GPU直接跨网络读取后端存储,少了中间层层绕路;还有借鉴斗拱工艺的高密度节点,不到9厘米塞下9层板卡,物理距离短了,通信延迟自然降下来。
现在人家都当“Token工厂”了,大语言模型、世界模型、物理AI全在上面跑。说白了,算力竞赛早就不是单比芯片数了,能把异构算力真正打造成合力,才是十万卡级集群的核心实力。