Argon的低价是促销价,正式价翻倍。
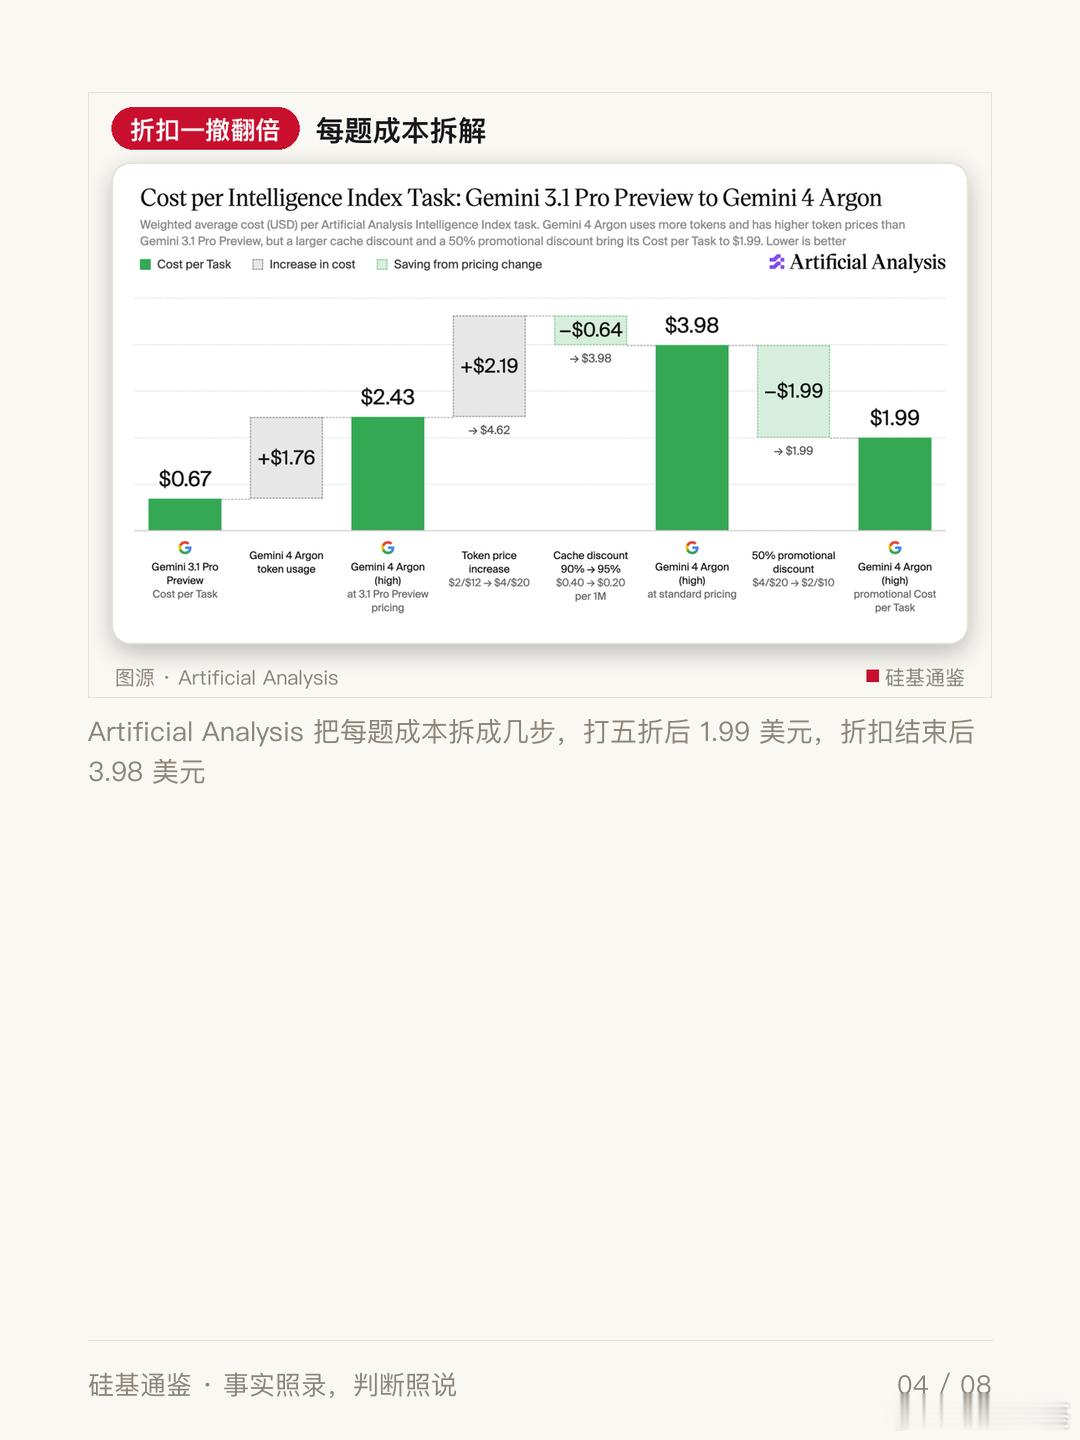
谷歌 9 月 30 日发布 Gemini 4 Argon,介绍价是每百万 token 输入 2 美元、输出 10 美元,介绍期结束后是 4 美元和 20 美元。第三方评测机构 Artificial Analysis 用同一套题测下来,Argon 每题 1.99 美元,正式价是 3.98 美元,约为 GPT-6 Astra 的 1.2 倍。
现在买不到,预算也别按 2 美元排。 Argon 目前只发给一批可信的网络防御者,付费 API 客户排在后面,谷歌没给日期,介绍期何时结束也没说。
便宜靠单价打折,没靠省 token。 Argon 每题平均输出 6.2 万个 token,Astra 是 2.7 万。
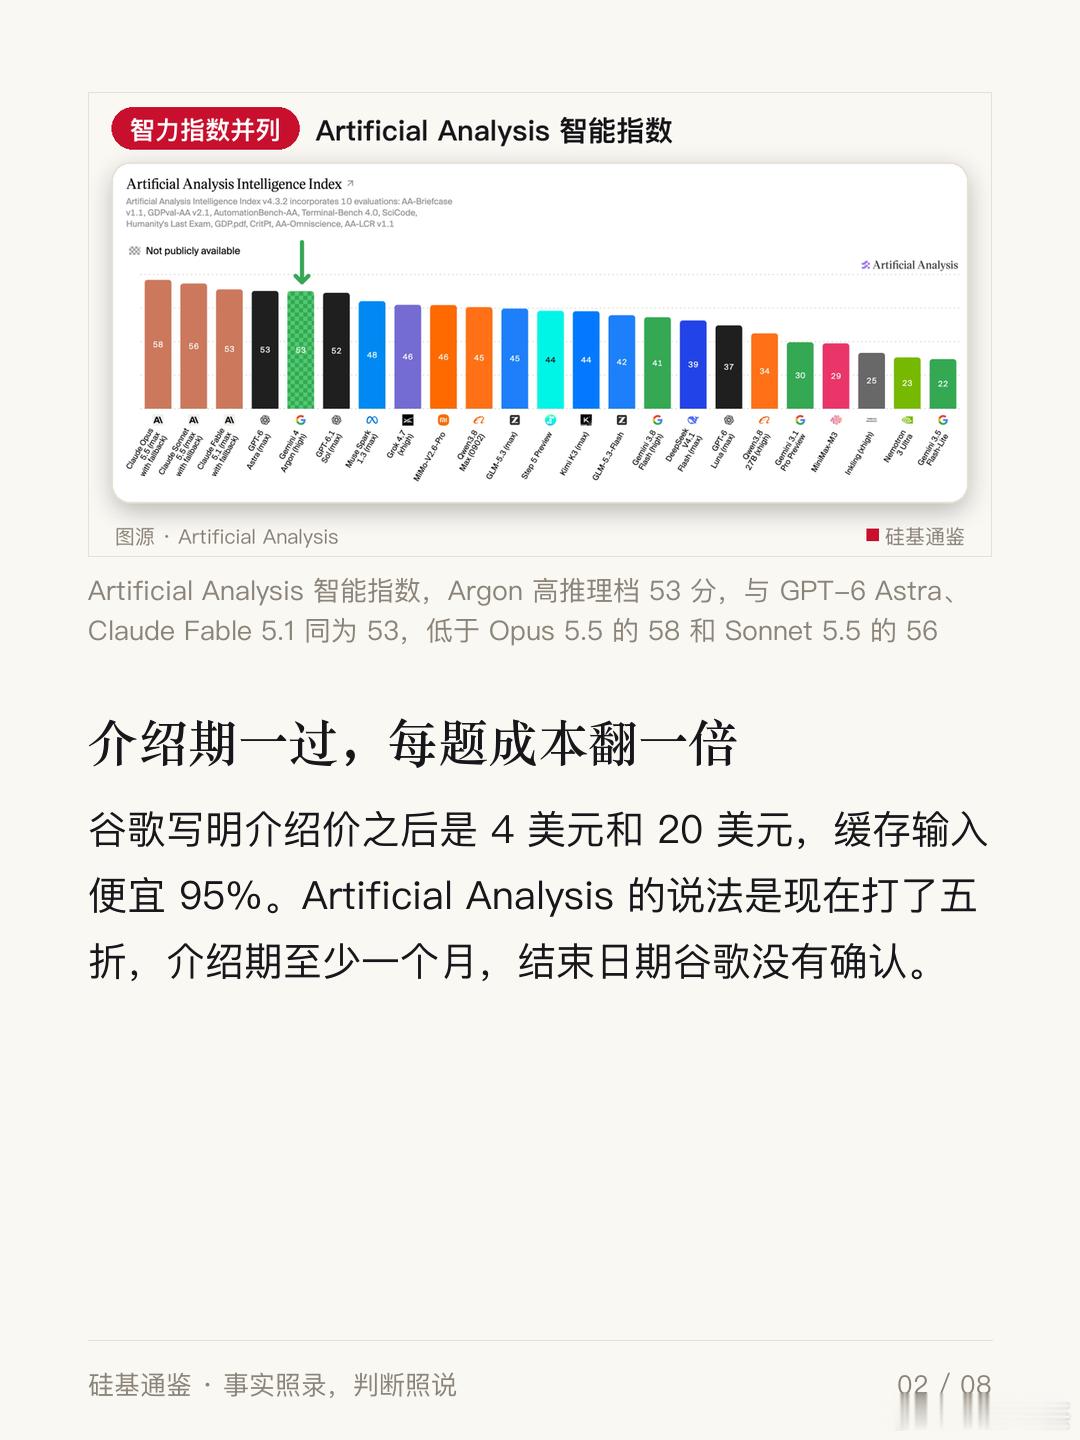
智力指数并列第一,终端任务只排第四。 开发者要按自己的任务测,别只看总榜。
介绍期一过,每题成本翻一倍
谷歌写明介绍价之后是 4 美元和 20 美元,缓存输入便宜 95%。Artificial Analysis 的说法是现在打了五折,介绍期至少一个月,结束日期谷歌没有确认。
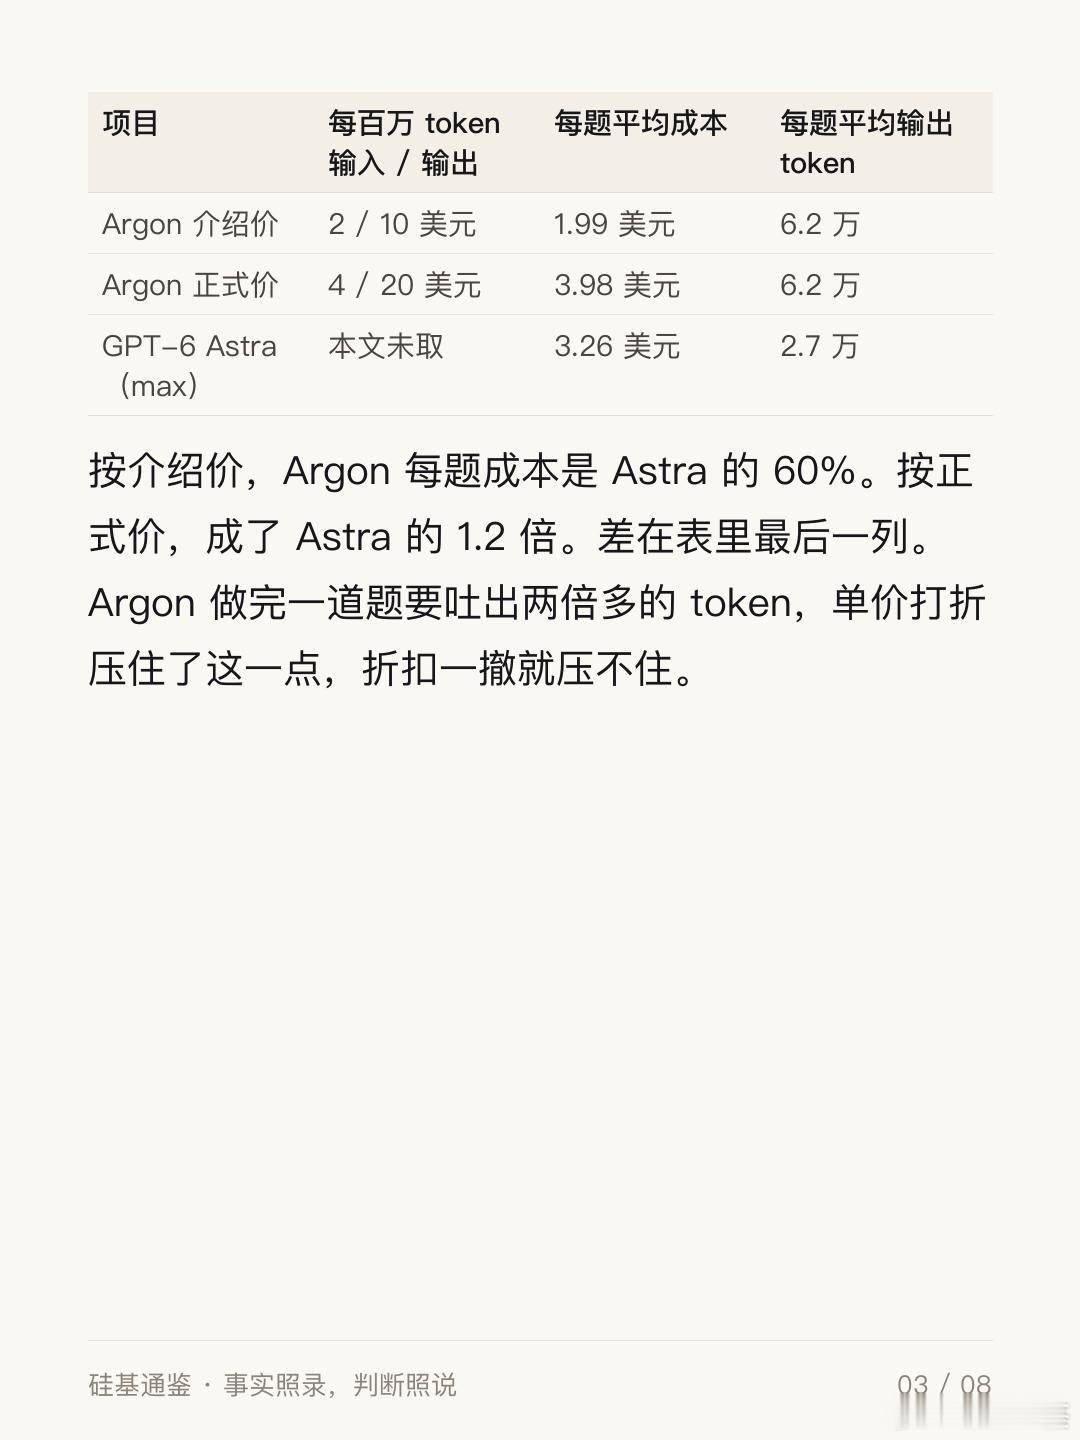
项目|每百万 token 输入 / 输出|每题平均成本|每题平均输出 tokenArgon 介绍价|2 / 10 美元|1.99 美元|6.2 万Argon 正式价|4 / 20 美元|3.98 美元|6.2 万GPT-6 Astra(max)|本文未取|3.26 美元|2.7 万
按介绍价,Argon 每题成本是 Astra 的 60%。按正式价,成了 Astra 的 1.2 倍。差在表里最后一列。Argon 做完一道题要吐出两倍多的 token,单价打折压住了这一点,折扣一撤就压不住。
强项是幻觉少,弱项在终端任务
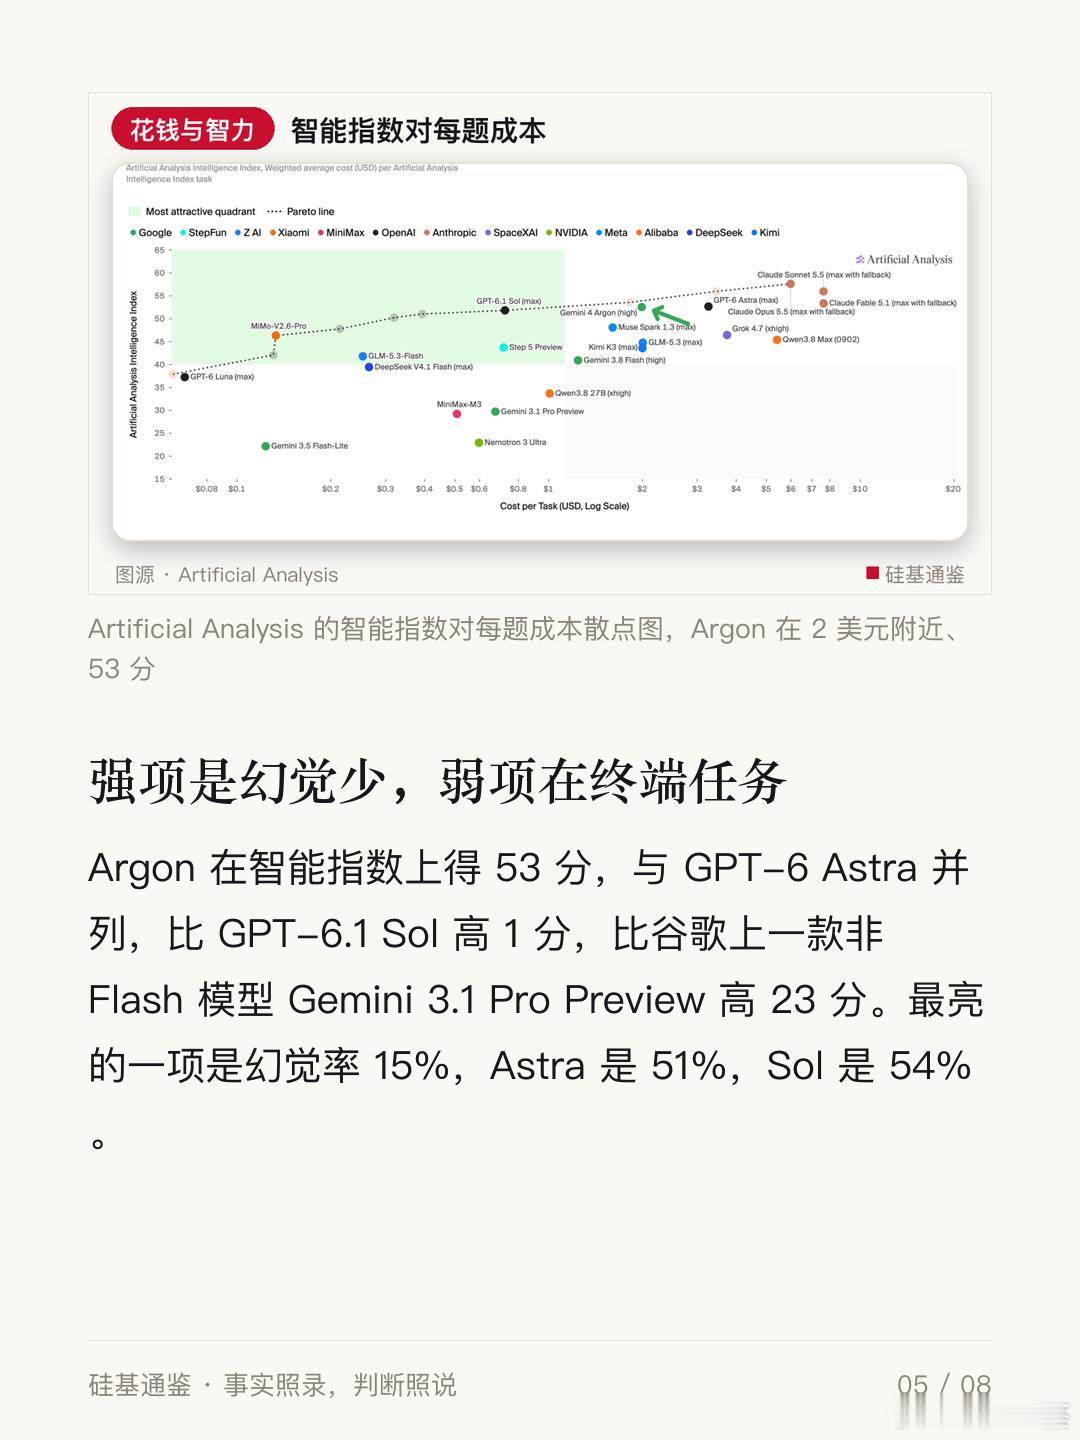
Argon 在智能指数上得 53 分,与 GPT-6 Astra 并列,比 GPT-6.1 Sol 高 1 分,比谷歌上一款非 Flash 模型 Gemini 3.1 Pro Preview 高 23 分。最亮的一项是幻觉率 15%,Astra 是 51%,Sol 是 54%。
这项要带一个条件看。Argon 的准确率是 50%,比 Astra 的 63% 低 13 个百分点。幻觉率低,是因为它更常承认不知道,不是答对的更多。
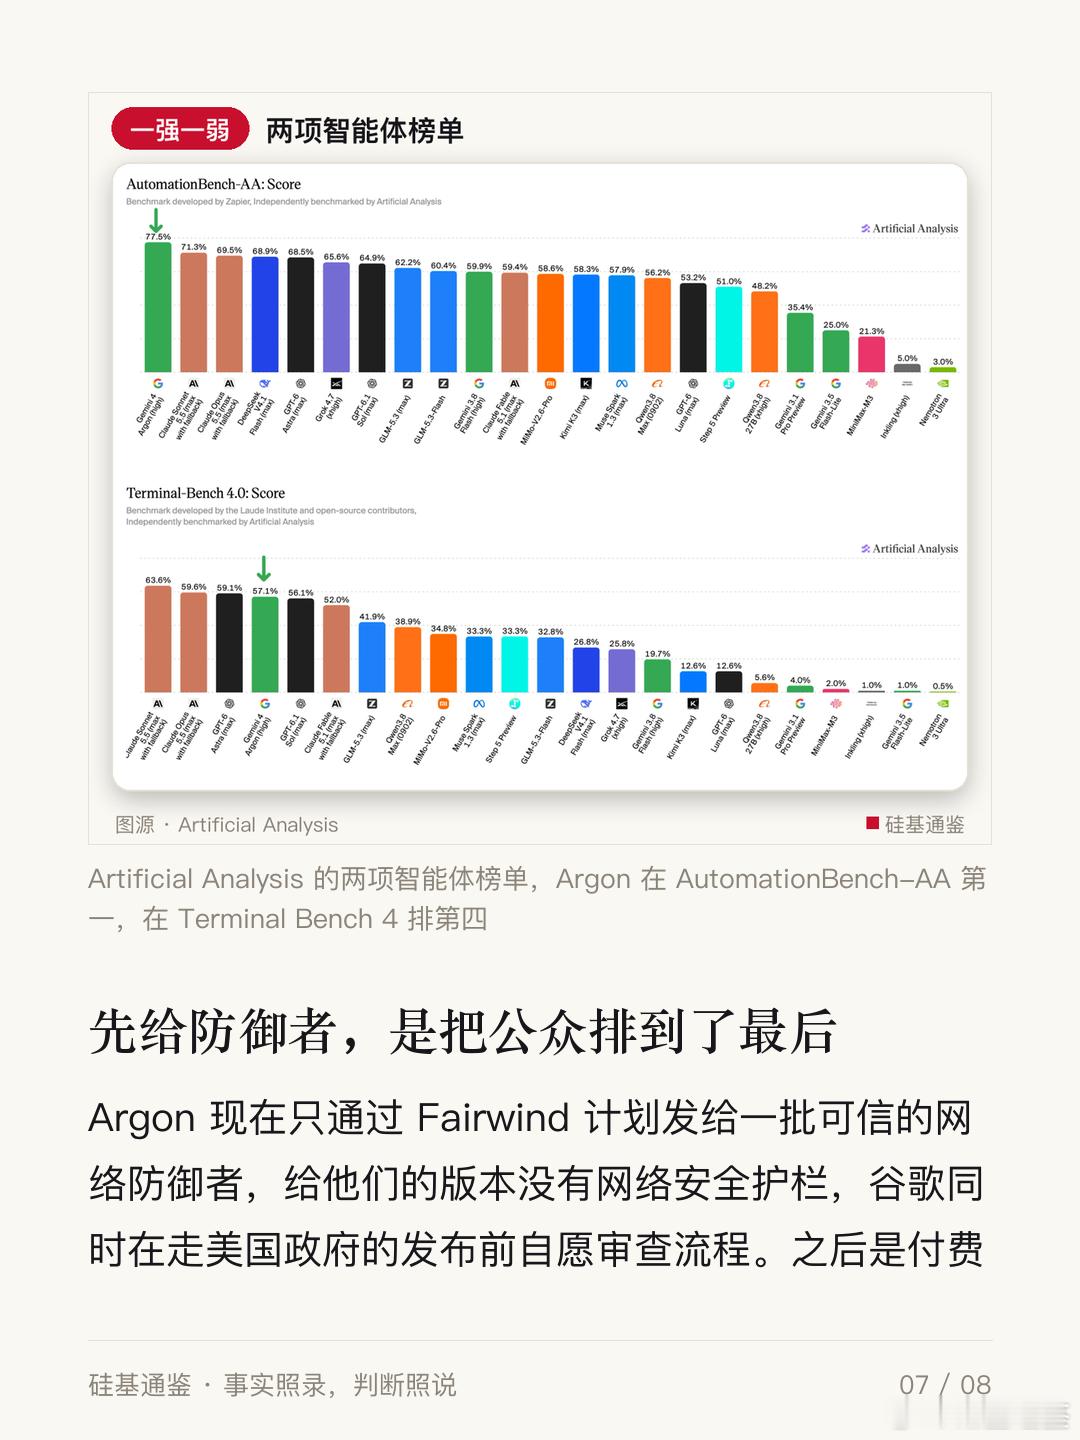
智能体榜单上它一强一弱。AutomationBench-AA 它得 78%,排第一,领先 Sonnet 5.5 约 7 个百分点。Terminal Bench 4 它得 57%,排在 Sonnet 5.5 的 64%、Opus 5.5 的 60% 和 Astra 的 59% 后面,第四。谷歌自己报的 DeepSWE v1.1 是 77.9%,它称这是新的最好成绩,这类数字是谷歌自测,要等独立复测。
先给防御者,是把公众排到了最后
Argon 现在只通过 Fairwind 计划发给一批可信的网络防御者,给他们的版本没有网络安全护栏,谷歌同时在走美国政府的发布前自愿审查流程。之后是付费 API 客户和 Google AI Ultra 订阅者,再往后才是开发者、企业和普通用户。Anthropic 的 Claude Mythos Preview 此前也只发给审核过的防守方。
反方的解释同样成立。模型能自己找漏洞、验证、打补丁,先发给防御者也许只是安全审查的正常节奏。谷歌说 Wiz 用它在医院使用的软件里找到一个严重漏洞,这是谷歌的说法,没写是哪家软件。
鉴曰:看到「最强模型发布」,先问谁现在能用、什么时候能用、多少钱,再问有多强。