韩国这次是真杀进来了!
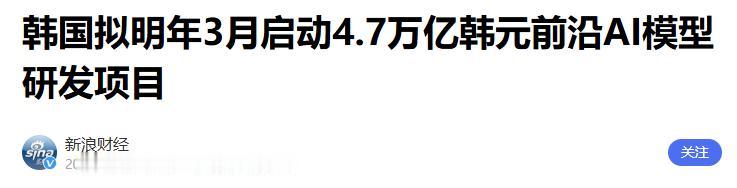
4.7万亿韩元,折合大约35亿美元,全部投给一个叫“Frontier AI”的国家级项目。
这笔钱怎么花,韩国科学技术信息通信部已经把账算得很细:3.9万亿韩元用来买1万张英伟达下一代Vera Rubin架构GPU,8000亿韩元用来采购AI训练数据,另外250亿韩元专门从海外挖20名顶尖研究者。
这不是撒胡椒面式的补贴,是政府出资,以股权投资的方式直接下场,参与的企业还要按比例配资跟进。
最耐人寻味的不是钱,是韩国官方自己说的话。
韩国副总理兼科技部长官裴庆勋在记者座谈会上被问到中国AI模型的进展时,原话是“坦率地说,令人羡慕”。
他指的是中国初创公司月之暗面发布的Kimi K3,一个2.8万亿参数的开源模型,外部评测认为它的性能已经逼近美国Anthropic的顶级模型。
裴庆勋没有遮掩韩国的处境,他直接说,目前韩国模型和中国开放模型之间还有差距,下半年的目标是追上去。
这个表态放在几年前几乎不可想象。韩国一直是“AI三强”叙事的积极推销者,目标是和美国、中国站在一起。
但现实数据摆在面前:2025年底的全球模型排行榜上,韩国最强的LG Exaone 4.0排在第23位,前二十名里找不到韩国模型的身影。
与此同时,中国的Qwen3系列在Hugging Face开源社区登顶,Kimi K3在编程评测中甚至超过了OpenAI的旗舰模型。差距不是感觉,是排行榜上的数字。
所以韩国这次换了打法。原来的“独立AI基础模型”项目还在跑,LG、SK电信、Upstage等团队继续竞争,目标是达到全球最新模型95%的性能。
但政府显然觉得这个节奏太慢,于是另起炉灶搞了Frontier AI,目标只有一个:做出能和中国开放模型正面掰手腕的东西。
韩国科技部的判断是,仅靠单次支持1000块GPU的规模,根本不可能追上全球顶尖水平,必须把资源集中起来,投入约5万亿韩元级别,配合民间资本,才能进入完全不同的量级。
还有一个数字值得注意。韩国政府计划在明年可调配的GPU资源,按英伟达B200标准折算,大约2.9万张。
也就是说,除了专门给Frontier AI项目的1万张Vera Rubin,还有近两万张等效算力分布在其他AI基础设施里。这不是单点突破,是在铺一张算力网络。
但钱和芯片能解决的问题,和钱解决不了的问题,是两回事。
韩国AI产业有一个不太愿意被提起的细节。2026年初,华尔街日报报道,韩国“主权AI”竞赛的五家入围企业中,至少有三家被发现使用了外国模型的开源代码,其中就包括中国模型的代码。
也就是说,韩国企业在实际开发中,已经在用中国开放权重模型做底子。这不是个别现象,韩国AI行业内部人士承认,中国开源模型成本低、易获取,在企业系统中普及速度很快。
这就形成了一个很有意思的局面:韩国政府花大钱要追的目标,恰恰是韩国企业已经在悄悄使用的工具。追赶的动力和依赖的现实同时存在,中间的张力不是砸钱就能消解的。
更深层的问题在于,中国开放模型的迭代速度并没有放慢。Kimi K3之后还有K3的后续版本,Qwen系列也在持续更新。
韩国把目标定在“追上中国顶尖开放模型这一档”,意味着它追的是一个移动的靶子。
裴庆勋自己也承认,中国企业目前开放权重是为了扩大生态,但最终可能转向闭源,到那时候,韩国如果还没有自己的底子,处境会比现在更被动。
李在明政府上台后,把AI提到了“国家战略资产”的高度,甚至用“像核武器一样”来形容前沿AI模型的地缘政治分量。
这个比喻是否夸张另说,但它反映了韩国决策层的一种紧迫感:在中美AI博弈的大棋盘上,韩国不想只当观众。
4.7万亿韩元的投资,1万张Vera Rubin的采购单,2.9万张B200等效算力的调配计划,都是这种紧迫感的具象化。
但紧迫感不等于胜算。韩国面前有一道很实在的门槛:算力可以买,数据可以买,人才可以挖,但从零到一做出一个真正有竞争力的前沿模型,需要的是一整套研发体系和持续迭代的组织能力。
韩国在半导体制造上有深厚积累,在AI应用层面也有不少拿得出手的产品,但前沿基础模型的研发,和造芯片、做应用是两套完全不同的能力。
韩国这次“杀进来”,姿态很猛,钱到位了,目标也说得足够坦诚。但追上中国开放模型这件事,不是一张采购清单就能完成的。
裴庆勋说“令人羡慕”的时候,大概比谁都清楚这一点。