大模型推理负载分化,海光选择“组队打”
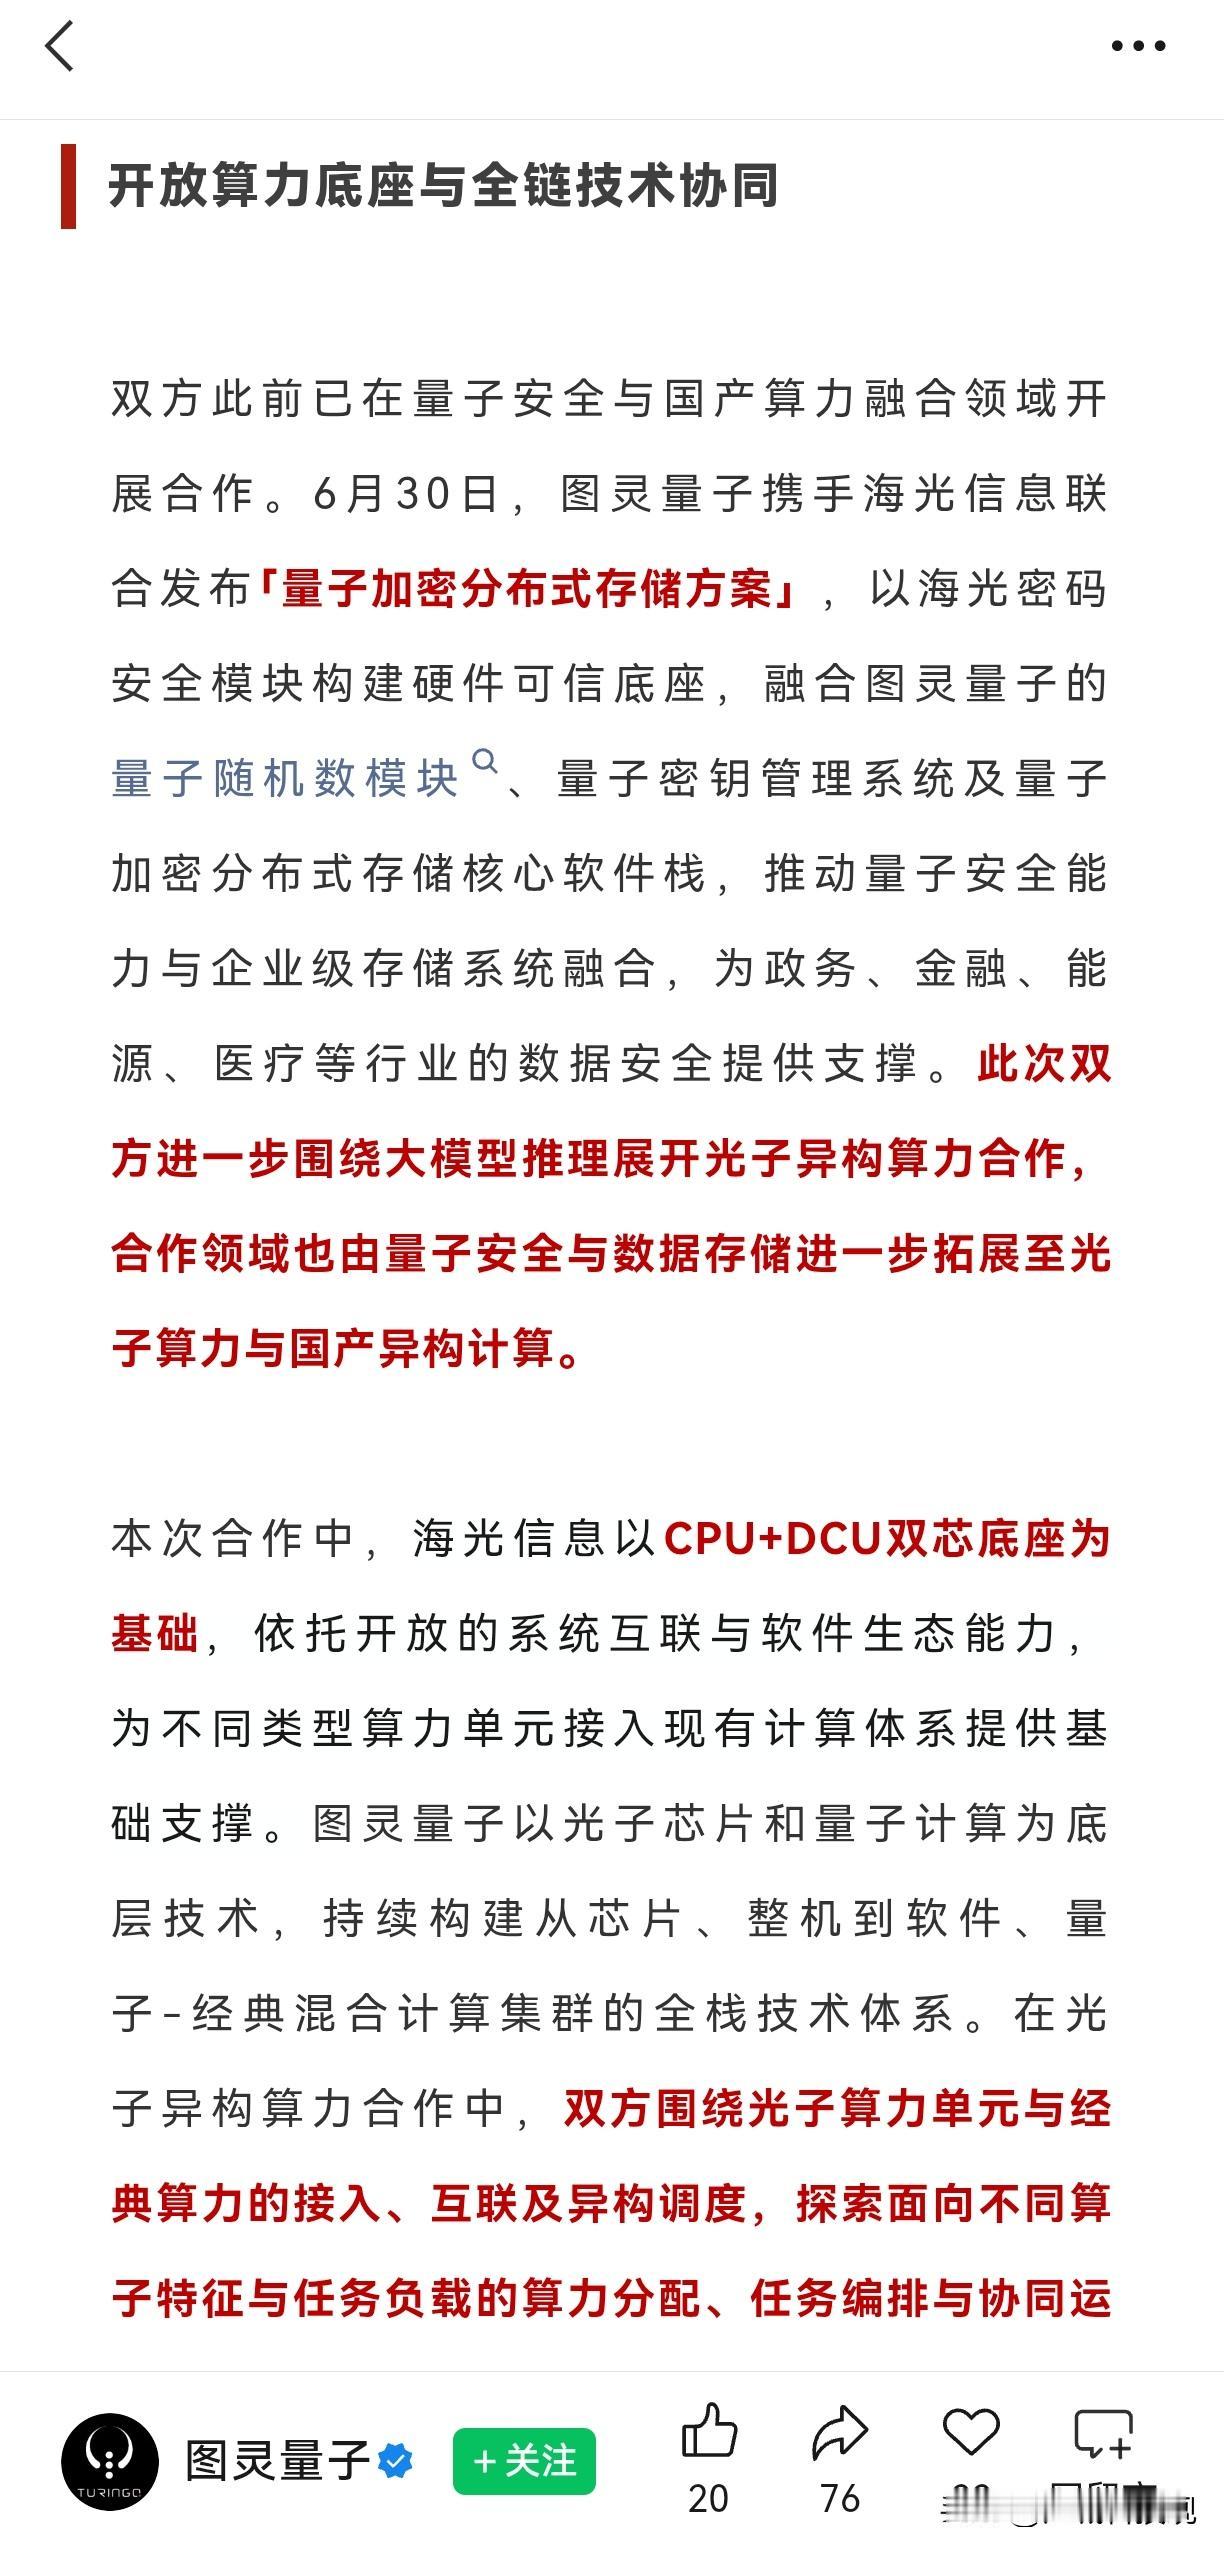
大模型推理有个现实:负载不是铁板一块。Prefill、解码、RAG、MoE路由,脾气都不一样。海光信息跟图灵量子合作,本质就是承认这一点,然后组队打。
海光的思路是:CPU统筹调度,DCU扛矩阵运算,图灵光子算力单元补向量运算。这个分工不一定完美,但比让一种架构硬扛所有任务合理。尤其解码阶段GEMV多,算术强度低,数据搬运容易成瓶颈,光子做线性变换有它的位置。
海光更侧重什么?我看是底座和调度。海光DCU的DTK异构计算平台兼容CUDA生态,开发者迁移成本低;同时推出统一异构编程工具包openDU,联合AI芯片厂商共建软件栈生态标准。CPU+DCU是基本盘,HSL是连接手段,统一编程和调度是目标。光子是加速单元,但能不能发挥,取决于海光这个底座搭得稳不稳。
所以别把这事看成“海光又多了个合作伙伴”。它更像海光在异构算力上的一次卡位:未来推理架构大概率是组合拳,不是单芯片通吃。谁先把组合拳打顺,谁就有机会。
海光信息 DCU 大模型推理